
人工智能技术文章
-
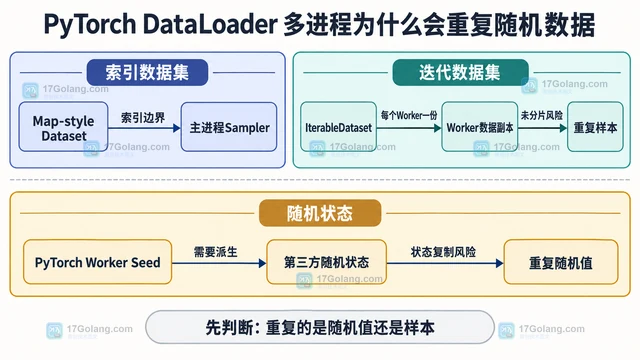
- PyTorch DataLoader 多进程为什么会重复随机数据
- 排查 PyTorch DataLoader 多进程中的重复随机值与重复样本,说明 worker seed、第三方随机库、IterableDataset 分片和 generator 的正确配置。
- 科技周边 · 人工智能 | 1星期前 | 人工智能 · 深度学习 · PyTorch 随机种子 DataLoader num_workers worker_init_fn 316浏览 收藏
-
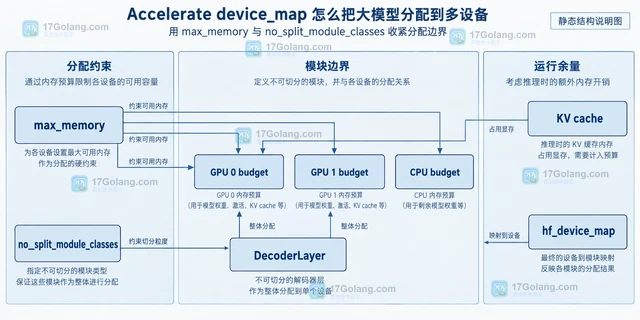
- Accelerate device_map 怎么把大模型分配到多设备
- 通过 Transformers 与 Accelerate 的 device_map=auto、max_memory 和 no_split_module_classes,把大模型稳妥分配到多张 GPU,并检查 CPU 或磁盘卸载边界。
- 科技周边 · 人工智能 | 1星期前 | 大模型 Accelerate device_map 多设备推理 150浏览 收藏
-
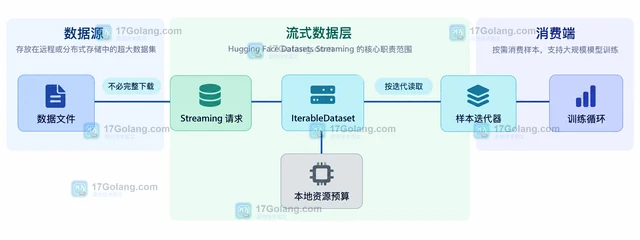
- Hugging Face Datasets Streaming 怎么处理超大数据集
- Hugging Face Datasets Streaming 通过 IterableDataset 边迭代边读取超大数据集。本文给出加载、抽样、缓冲打乱、在线变换、分片与训练观测的完整用法和适用边界。
- 科技周边 · 人工智能 | 1星期前 | 148浏览 收藏
-
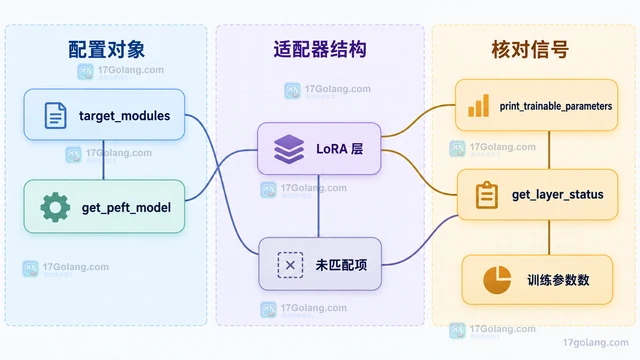
- PEFT LoRA 怎么选择 target_modules
- 说明 PEFT LoRA 的 target_modules 如何按模型模块树、任务范围和参数预算选择,并给出默认目标、all-linear、MoE 特例与命中检查方法。
- 科技周边 · 人工智能 | 1星期前 | 人工智能 · LoRa PEFT target_modules 251浏览 收藏
-
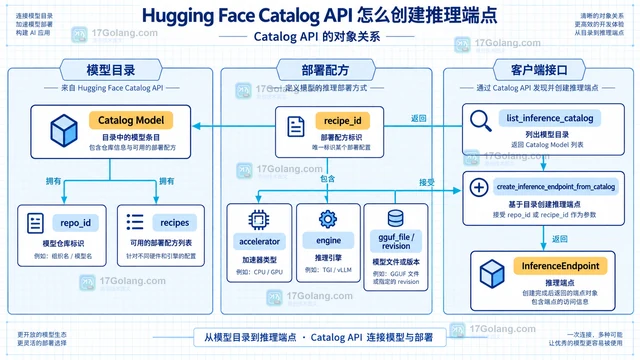
- Hugging Face Catalog API 怎么创建推理端点
- 讲清 Hugging Face Catalog API 的模型与配方关系,并用 huggingface_hub 完成目录筛选、精确创建、状态等待和成本控制。
- 科技周边 · 人工智能 | 1星期前 | 333浏览 收藏
-
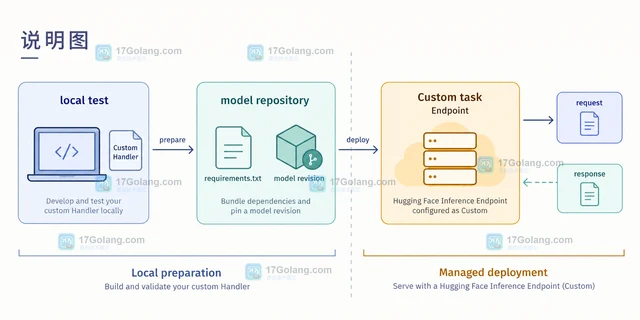
- Hugging Face Inference Endpoint 怎么编写自定义 Handler
- 从 handler.py 的 EndpointHandler 结构、依赖管理、本地测试到 Custom 任务部署,说明 Hugging Face Inference Endpoint 编写自定义 Handler 的完整边界。
- 科技周边 · 人工智能 | 1星期前 | python · 人工智能 · Hugging Face Inference Endpoint EndpointHandler handler.py 145浏览 收藏
-
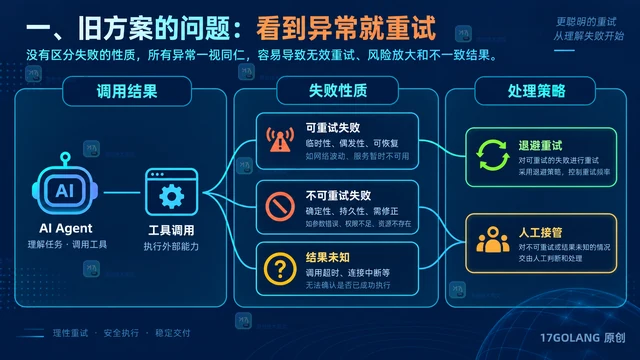
- AI Agent 工具调用失败后的重试与幂等设计
- AI Agent 的工具调用失败可能是拒绝、超时或结果未知。本文给出失败分类、稳定幂等键、结果复用、指数退避与人工接管的完整设计,避免重复副作用。
- 科技周边 · 人工智能 | 1星期前 | 人工智能 · 重试 AI Agent 幂等 工具调用 Idempotency Key 236浏览 收藏
-
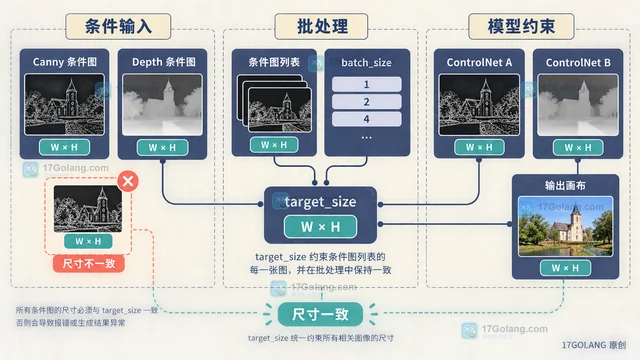
- Diffusers ControlNet 条件图尺寸匹配的处理
- 讲清 Diffusers ControlNet 条件图与生成画布的尺寸匹配方法,覆盖等比补边、居中裁切、多 ControlNet 和批量输入检查。
- 科技周边 · 人工智能 | 1星期前 | 人工智能 · Python教程 · 图像尺寸 Pillow ControlNet diffusers 条件图 314浏览 收藏
-
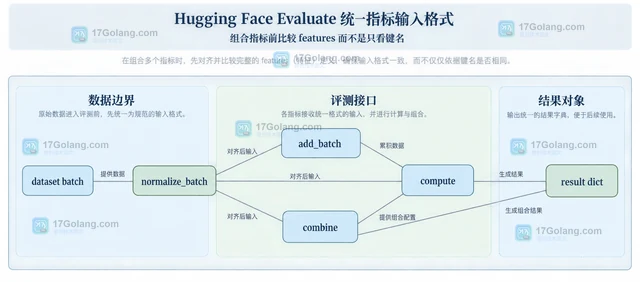
- Hugging Face Evaluate 统一指标输入格式
- 统一 Hugging Face Evaluate 输入时,应该统一 predictions 和 references 的批次外壳,同时以 metric.features 保留每个指标的元素类型与嵌套边界。本文给出适配器写法、compute 与 add_batch 共用方式,以及组合指标前必须检查的兼容条件。
- 科技周边 · 人工智能 | 1星期前 | python · 人工智能 · 模型评测 Hugging Face Evaluate 指标输入格式 predictions references 134浏览 收藏
-
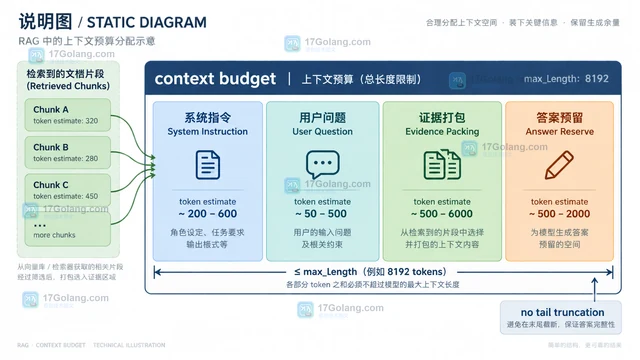
- RAG 检索结果去重与上下文长度控制
- RAG 检索结果不要直接按 top_k 全量送入模型。本文用文档身份、规范化文本和语义多样性三层策略去重,再按系统指令、问题、证据与回答余量分配上下文预算,给出可迁移的 Python 实现与参数调优指标。
- 科技周边 · 人工智能 | 1星期前 | 357浏览 收藏
-
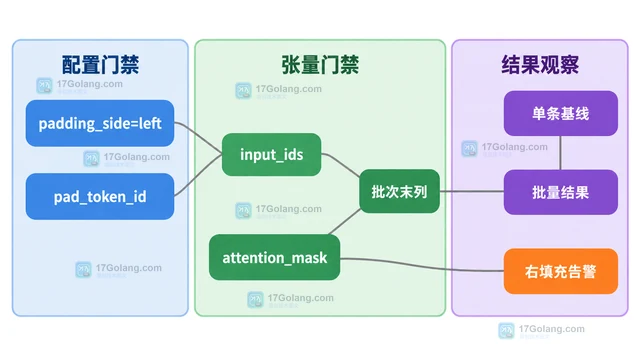
- Tokenizer padding_side 影响批量生成的对齐
- 说明 decoder-only 模型批量生成时 padding_side 为什么应设为 left,并结合 input_ids、attention_mask 和生成起点排查对齐问题。
- 科技周边 · 人工智能 | 2星期前 | 206浏览 收藏
-
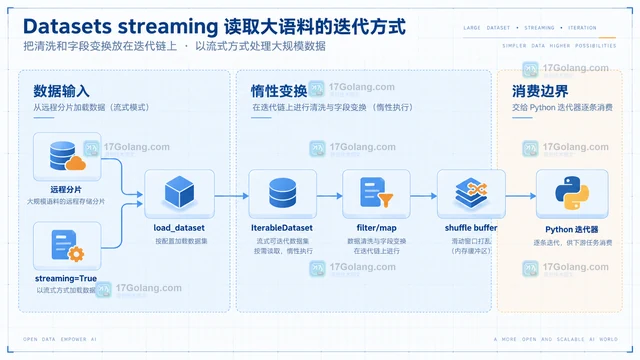
- Datasets streaming 读取大语料的迭代方式
- Hugging Face Datasets 的 streaming 模式会返回 IterableDataset,按迭代按需读取远程或本地分片。本文给出变换、缓冲区打乱、多 worker、训练轮次和检查点恢复的生产写法。
- 科技周边 · 人工智能 | 2星期前 | python · 人工智能 · 数据迭代 Hugging Face Datasets streaming IterableDataset 大语料 337浏览 收藏
-
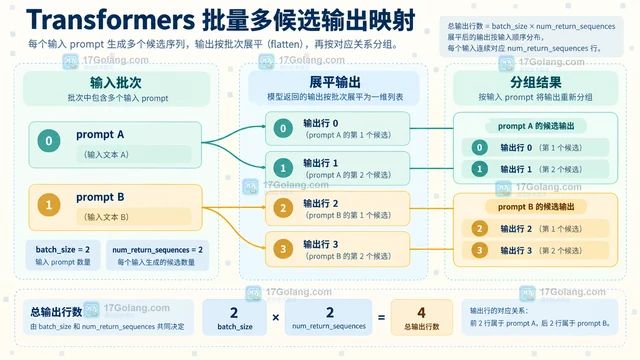
- Transformers generate 的停止条件与批量输出
- 梳理 Transformers generate 的 EOS、max_new_tokens、stop_strings 与自定义 StoppingCriteria,演示批量提示词、多候选返回、纯新增 token 解码和输出分组。
- 科技周边 · 人工智能 | 2星期前 | python · Transformers generate 停止条件 批量输出 133浏览 收藏
-
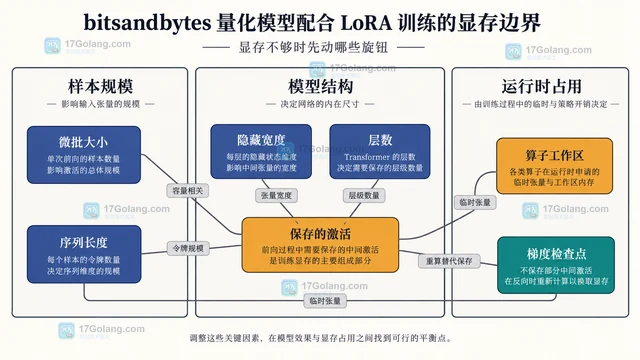
- bitsandbytes 量化模型配合 LoRA 训练的显存边界
- bitsandbytes 4-bit 量化只压缩冻结基座权重,LoRA 参数、梯度、优化器状态、激活与 CUDA 工作区仍会占用显存。本文给出 NF4 配置、峰值测量方法和 OOM 调整顺序,说明 QLoRA 单卡训练的真实边界。
- 科技周边 · 人工智能 | 2星期前 | 人工智能 · LoRa 显存优化 bitsandbytes QLoRA 4-bit量化 249浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-
- Golang深入理解GPM模型
- Golang深入理解GPM调度器模型及全场景分析,希望您看完这套视频有所收获;包括调度器的由来和分析、GMP模型简介、以及11个场景总结。
- 474次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 478次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 535次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 555次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 506次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 328次使用


