
模型服务批处理队列的延迟与吞吐配置
模型服务批处理的核心不是盲目增大 batch size,而是在用户可接受的排队时间内凑出稳定批次,再用显存预算和端到端延迟验证收益。低并发时,等待窗口过长会直接抬高首 token 或整体响应时间;高并发时,批量上限过小又会让 GPU 吃不满。可以把策略拆成三层:队列最多等多久、一个批次最多容纳多少请求或 token、以及用什么指标决定下一轮调整。
官方参考:https://docs.nvidia.com/deeplearning/triton-inference-server/user-guide/docs/user_guide/model_configuration.html
生成式服务参考:https://huggingface.co/docs/text-generation-inference/basic_tutorials/launcher
- 先以 p95 延迟和超时率设定等待上限,再调批量,不要反过来。
- Triton 主要看
max_batch_size与max_queue_delay_microseconds;TGI 要看max_batch_total_tokens与 prefill 预算。 - 只有队列、批大小、prefill/decode 和端到端延迟一起改善,才算吞吐配置有效。
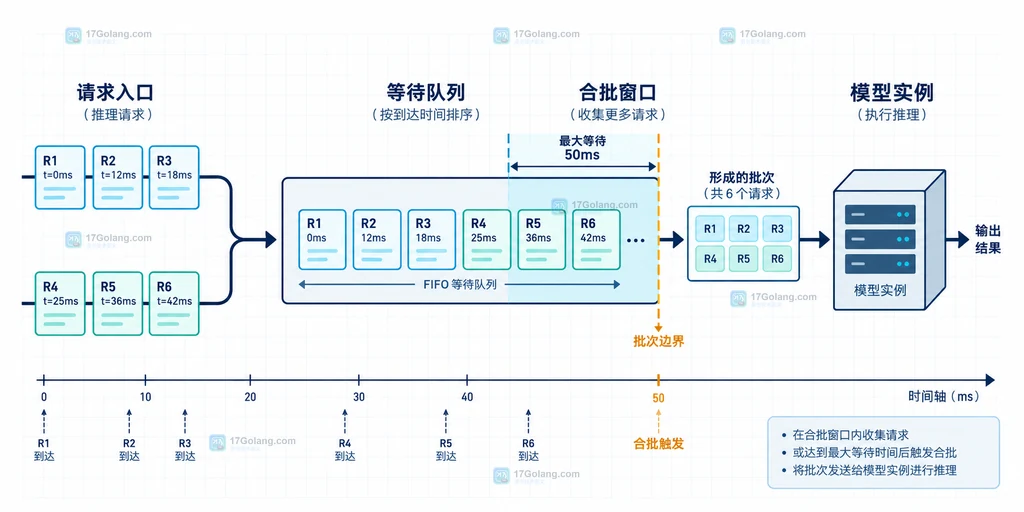
先用排队延迟换取可控批量
以 Triton 为例,dynamic_batching 会把同时到达的推理请求合并。max_queue_delay_microseconds 允许调度器短暂等待后续请求;时间到了,即使没有形成最大或首选批次,也会把当前批次送入模型。因此它是“最多愿意等多久”,不是“保证得到多大批次”。建议先从业务 p95 预算中扣除网络、排队、推理和序列化时间,剩余部分才是队列等待预算。
max_batch_size: 8
dynamic_batching {
  // 只允许队列短暂等待,数值单位是微秒。
  max_queue_delay_microseconds: 200
  // 只有确认模型在该批量上有稳定收益时才填写首选批次。
  preferred_batch_size: [ 4, 8 ]
}
上面的数字只是配置形状,不是通用推荐值。若低负载时请求经常单独到达,继续增大等待时间只会增加延迟;若高负载时批次长期接近上限而显存仍有余量,再通过压测逐步增加 max_batch_size。preferred_batch_size 也不要凭感觉填写,除非模型或后端在某些批量上确实有明确的优化档位。
吞吐上限由请求预算决定
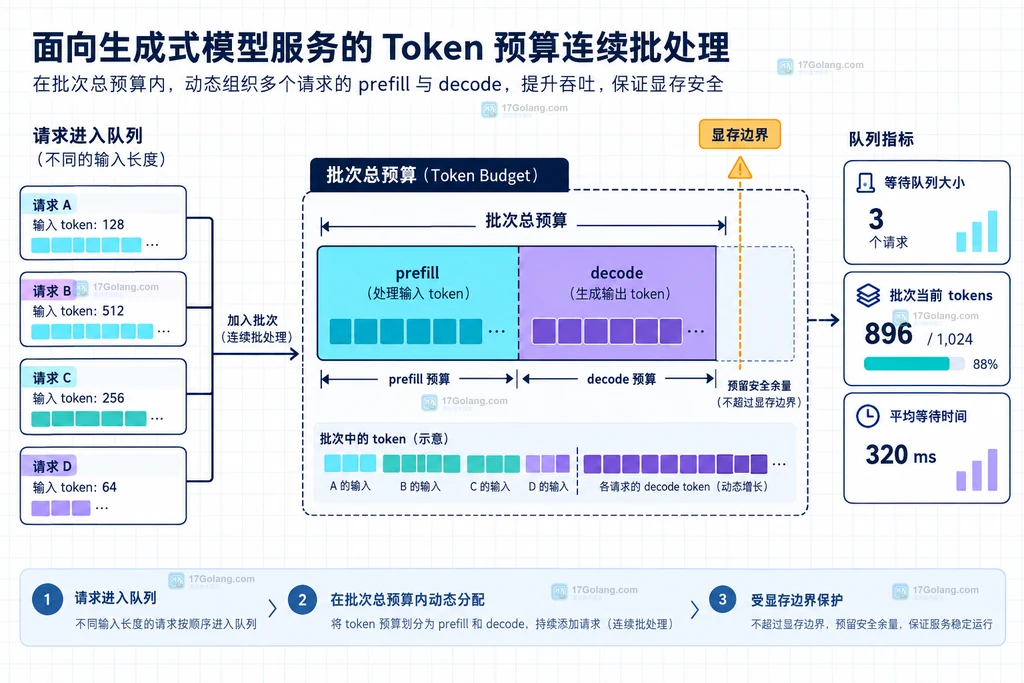
生成式模型不能只按请求数理解批量:一个短提示词和一个长提示词占用的显存完全不同。TGI 用 max_batch_total_tokens 表示当前批次可容纳的潜在 token 总量,用 max_batch_prefill_tokens 限制输入提示词的 prefill 预算。前者更像总容量,后者防止一批长输入瞬间挤压正在生成的请求。
# 令牌预算示例:先限制单批总量,再限制一次 prefill 的输入压力
docker run --gpus=all --rm \
  -e MAX_BATCH_TOTAL_TOKENS=4096 \
  -e MAX_BATCH_PREFILL_TOKENS=2048 \
  -e MAX_INPUT_TOKENS=1024 \
  text-generation-inference:latest
# 生产环境应固定镜像版本,并在启动日志中记录最终生效值。
如果 max_batch_total_tokens 太小,短请求会频繁排队;太大则可能触发显存压力或让单个长请求挤占其他请求。输入长度、最大输出长度、量化方式和 KV cache 都会改变可承受范围,所以应以压测和 OOM 前的安全余量共同确定,而不是直接照搬机器上的默认值。
用指标把参数调到目标区间
每次只改一个变量,至少比较低并发、目标并发和突发并发三组数据。Triton 侧关注队列等待、实际批大小、实例利用率和请求 p95;TGI 侧可读取 tgi_queue_size、tgi_batch_current_size、tgi_batch_current_max_tokens 以及 prefill、decode 和 inference duration。吞吐上升但 p95、超时率或拒绝率同步恶化时,说明调参已经越过服务目标。
一个实用的调整顺序是:先把等待窗口调到不会明显侵蚀 p95 的范围,再把批量或 token 预算调到显存安全线以内,最后用并发压测观察队列是否持续增长。队列持续增长通常意味着到达速率超过服务能力,此时应限流、扩实例或降低单请求预算,不能只继续增大等待时间。
# 以队列持续增长为扩容信号,避免只看 GPU 利用率。
deriv(tgi_queue_size[5m]) > 0
# 同时观察端到端 p95,防止吞吐上升却让用户超时。
histogram_quantile(0.95, sum(rate(request_latency_seconds_bucket[5m])) by (le))
常见问题
等待时间越长,吞吐一定越高吗?
不一定。只有在后续请求能及时到达、模型确实从更大批量中获益且显存仍有余量时,等待才可能换来吞吐;低流量场景通常只会增加排队延迟。
为什么批大小不大,显存仍然会爆?
生成式模型的占用还受输入和输出 token、KV cache、prefill 预算、量化和实现方式影响。应按 token 总量观察,而不是只看请求数量;保留安全余量,并为超时、拒绝和回滚设定明确边界。
 magisk OTA 更新前要做什么?还原镜像、分区类型与重启边界说明
- 上一篇
- magisk OTA 更新前要做什么?还原镜像、分区类型与重启边界说明
- 下一篇
- Go fs.Sub 暴露子目录并保持路径安全
-
- 科技周边 · 人工智能 | 1天前 | 人工智能 · 重试 AI Agent 幂等 工具调用 Idempotency Key
- AI Agent 工具调用失败后的重试与幂等设计
- 236浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | 人工智能 · Python教程 · 图像尺寸 Pillow ControlNet diffusers 条件图
- Diffusers ControlNet 条件图尺寸匹配的处理
- 314浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 | python · 人工智能 · 模型评测 Hugging Face Evaluate 指标输入格式 predictions references
- Hugging Face Evaluate 统一指标输入格式
- 134浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 |
- RAG 检索结果去重与上下文长度控制
- 357浏览 收藏
-
- 科技周边 · 人工智能 | 4天前 |
- Tokenizer padding_side 影响批量生成的对齐
- 206浏览 收藏
-
- 科技周边 · 人工智能 | 4天前 | python · 人工智能 · 数据迭代 Hugging Face Datasets streaming IterableDataset 大语料
- Datasets streaming 读取大语料的迭代方式
- 337浏览 收藏
-
- 科技周边 · 人工智能 | 4天前 | python · Transformers generate 停止条件 批量输出
- Transformers generate 的停止条件与批量输出
- 133浏览 收藏
-
- 科技周边 · 人工智能 | 5天前 | 人工智能 · LoRa 显存优化 bitsandbytes QLoRA 4-bit量化
- bitsandbytes 量化模型配合 LoRA 训练的显存边界
- 249浏览 收藏
-
- 科技周边 · 人工智能 | 5天前 | 人工智能 · LoRa PEFT load_adapter set_adapter 适配器切换
- PEFT LoRA 适配器按任务切换的加载方案
- 268浏览 收藏
-
- 科技周边 · 人工智能 | 5天前 | 人工智能 · LoRa PEFT merge_and_unload 适配器合并
- PEFT 适配器合并后为什么输出会变化
- 221浏览 收藏
-
- 科技周边 · 人工智能 | 5天前 |
- Tokenizer 左填充和右填充应该怎么选
- 399浏览 收藏
-
- 科技周边 · 人工智能 | 5天前 |
- Safetensors 为什么支持按需读取权重切片
- 258浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 318次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 374次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 370次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 337次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 162次使用
-
- Go goroutine 泄漏怎么排查:pprof 快照、止血和回退手册
- 2026-07-09 374浏览
-
- CodeGeeX for Jetbrains IDEs正式上线!
- 2023-01-17 284浏览
-
- 技术阿里云实现ocr批量图片和pdf文件表格图片转换excel文档/支持票据图片提取/普通图片文字提取处理
- 2023-01-18 387浏览
-
- 直播预告|FeatureStore Meetup V2
- 2023-01-10 328浏览
-
- 深入浅出特征工程 – 基于 OpenMLDB 的实践指南(上)
- 2023-02-25 426浏览


