详细介绍
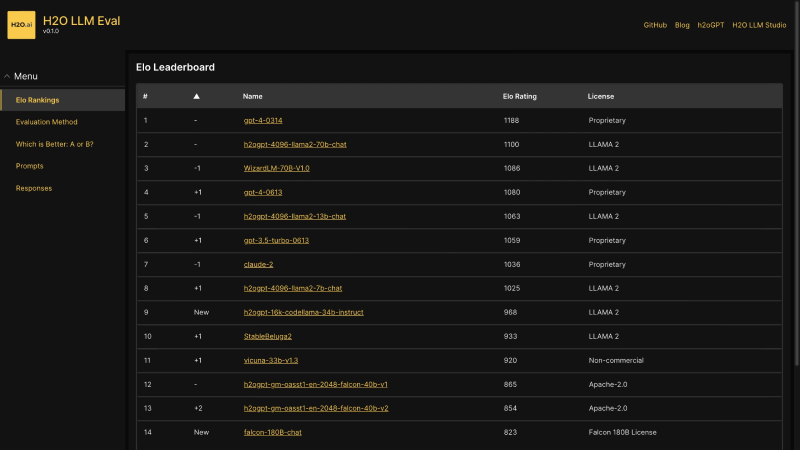
H2O EvalGPT 是由 H2O.ai 推出的一款开源工具,旨在帮助用户全面评估和对比各类大型语言模型(LLM)。该平台通过丰富的任务场景和基准测试,直观展示模型的实际性能表现。无论您是希望利用大模型实现工作流自动化,还是寻找针对特定任务的最优解决方案,H2O EvalGPT 都能提供一份涵盖主流、开源且高性能大模型的详细排行榜,协助您精准选型,提升项目效率。
H2O EvalGPT 的核心优势
- 高度相关性: H2O EvalGPT 基于行业特定的真实数据进行评估,深入解析流行大语言模型在实际应用场景中的具体表现。
- 透明可信: 平台通过公开的排行榜展示顶级模型的排名及详尽的评估指标,确保所有结果具备完全的可重复性和透明度。
- 高效更新: 作为一个全自动且响应迅速的平台,H2O EvalGPT 每周更新排行榜数据,大幅缩短模型评估与提交的等待时间。
- 广泛覆盖: 支持对多种任务类型的模型进行评估,并持续引入新的指标和基准测试,从而提供对模型能力的全方位洞察。
- 交互验证与人工一致性: 支持手动执行 A/B 测试,为用户提供更深入的评估视角,同时验证自动评估结果与人工判断之间的一致性。
查看更多
最新文章
CNCF 年度调查怎样解读云原生采用率
CNCF 年度调查里的云原生采用率并不是一张全行业普查表。本文从样本、分母和使用场景出发,解释 98%、
OVHcloud 升级 CNCF 白金会员释放了哪些云原生信号
CNCF 公告披露 OVHcloud 升级为白金会员,并提到 Harbor Kubernetes Ope
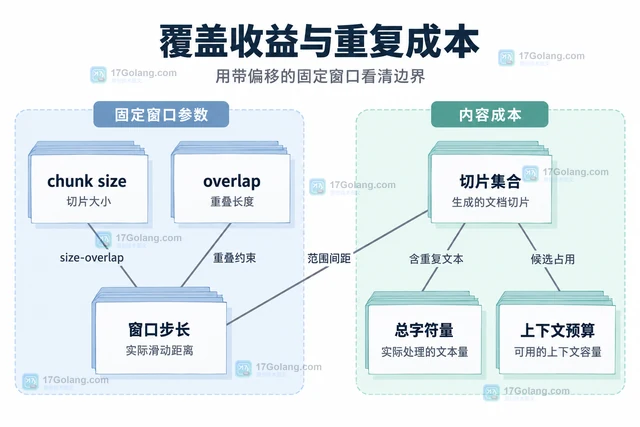
RAG 文档切片怎样决定 overlap
RAG 切片的 overlap 应结合统一计量单位、跨边界证据与重复上下文成本决定。本文用保留原文偏移的
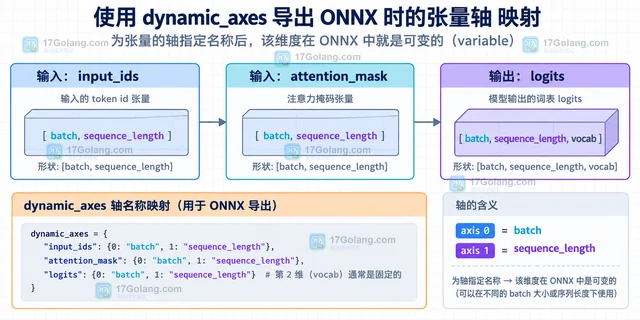
ONNX 导出怎样声明动态 batch 和序列长度
本文围绕 PyTorch ONNX 导出的 dynamic_axes,说明如何为文本模型声明动态 bat
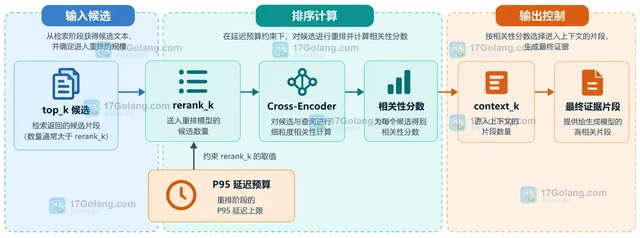
RAG 检索结果怎样设置召回和重排的 Top K
拆分 RAG 的 top_k、rerank_k 与 context_k,说明如何用候选覆盖率、重排延迟、
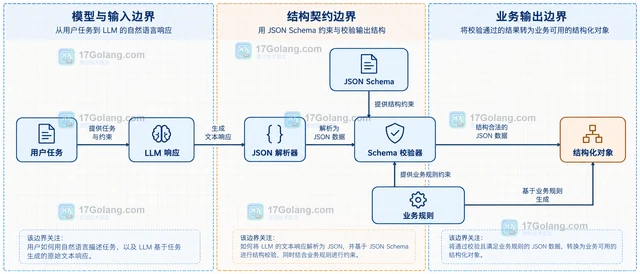
LLM 结构化输出失败后怎样做有限修复
把 LLM 结构化输出拆成 JSON 解析、Schema 校验和业务规则三层,只对可定位的格式错误做有限