详细介绍
PubMedQA是什么
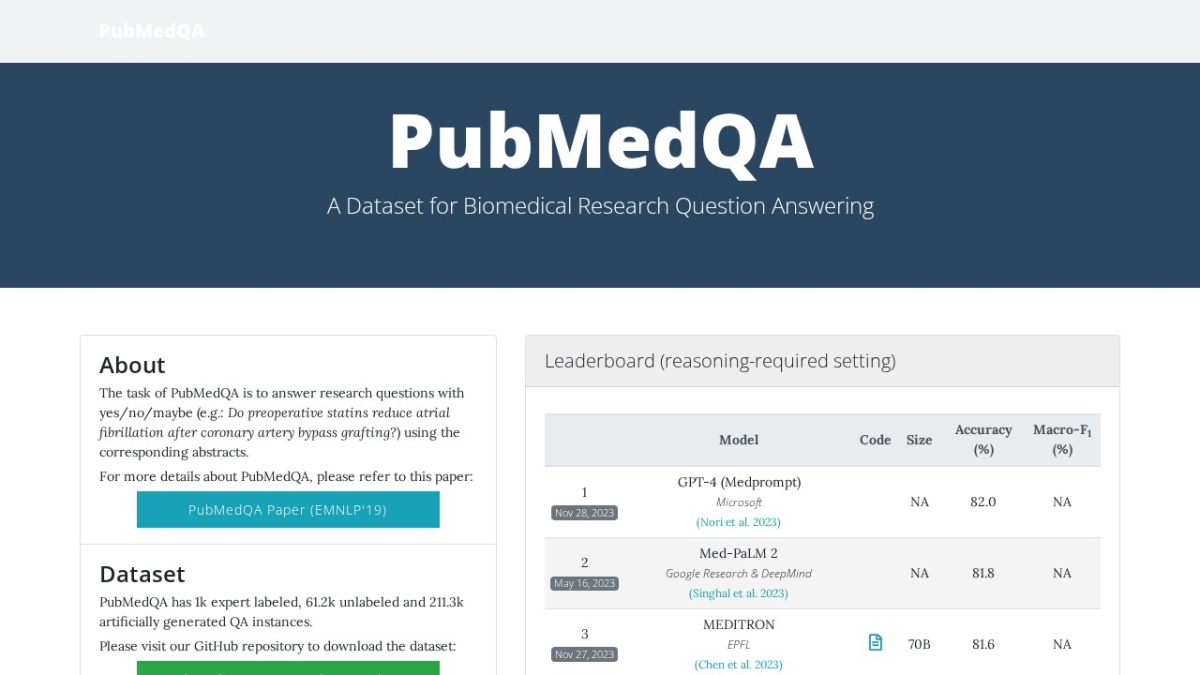
PubMedQA是一个专为生物医学研究领域设计的问答数据集。该数据集旨在通过文献摘要来回答具有“是/否/可能”性质的研究问题,例如评估“某种特定药物是否有效”。PubMedQA资源库中包含了1000个由专家精心标注的问答实例、61200个未标注实例以及211300个人工生成的问答对。它为研究人员提供了一个标准化的测试环境,专门用于开发和评估生物医学领域的自然语言处理(NLP)模型,从而显著提升模型对生物医学文献的理解深度及问答准确性。
PubMedQA的主要功能
- 提供高品质的生物医学问答数据:PubMedQA汇集了1000个专家标注样本、61200个未标注样本及211300个人工生成样本,为生物医学NLP研究提供了丰富且多样化的数据支持。
- 充当模型评估的标准基准:作为生物医学问答模型的标准化测试平台,PubMedQA通过公开各类模型的性能指标,协助研究者进行横向比较,进而推动模型的改进与优化。
- 促进生物医学信息的高效提取:该数据集赋能生物医学NLP研究,帮助从海量学术文献中迅速提炼关键信息,从而大幅提高科研工作的效率。
- 驱动生物医学NLP技术进步:凭借高质量的数据资源,PubMedQA推动了生物医学问答系统及文本理解技术的发展,为构建更智能的人工智能模型奠定了坚实基础。
如何使用PubMedQA
- 获取PubMedQA数据集:访问PubMedQA官方GitHub仓库(https://github.com/pubmedqa/pubmedqa),克隆代码库并下载所需的数据集文件。
- 熟悉数据集架构:加载数据文件并检查其结构,明确每个实例中包含的研究问题、对应答案以及相关文献摘要等关键要素。
- 执行数据预处理:对原始数据进行清洗和格式化,例如利用分词器将问题与摘要转化为模型可识别的输入格式,并提取相应的标签。
- 开展模型训练:选取合适的模型架构(如BERT、PubMedBERT等),使用预处理后的数据进行训练,并通过调整参数来优化模型表现。
- 实施模型评估在测试集上验证模型性能,计算准确率、F1分数等关键指标,以确认模型的有效性与可靠性。
- 提交结果至排行榜:遵循GitHub仓库中的“Submission”指引,将模型的预测结果及性能数据提交至PubMedQA官方排行榜,等待审核与排名。
- 借鉴排行榜优化策略:分析排行榜上高分模型的技术方案与性能表现,与自身模型进行对比,寻找差距并进一步迭代优化。
PubMedQA的应用场景
- 辅助临床决策:协助医生快速检索最新的研究成果,为诊断和治疗方案的制定提供有力支持。
- 加速医学研究:为科研人员提供精准的文献信息提取服务,缩短研究周期,加快科学发现进程。
- 赋能医学教育:作为高效的学习辅助工具,帮助医学生快速掌握生物医学领域的核心知识与前沿动态。
- 支持药物研发:助力制药企业及研究人员快速评估药物疗效及临床试验结果,提高研发效率。
- 构建智能医疗系统:集成于智能医疗平台中,基于最新研究成果为用户提供个性化的医疗建议与健康指导。
查看更多
最新文章
SkildArt对跨境电商运营有什么帮助?常用场景和能力边界
本文详解SkildArt对跨境电商运营的实际价值、四类核心使用场景与明确能力边界,搭配实用常见问题帮运营
Redis LPOS 使用 rank 和 maxlen 时怎样控制扫描范围
Redis LPOS 的 rank 决定从头部还是尾部计数,maxlen 决定最多比较多少个列表元素;两
Go net.Dialer Timeout 和 Deadline 该如何分别设置
Go net.Dialer 的 Timeout 是相对拨号开始的最长时长,Deadline 是绝对截止时
MySQL COUNT(DISTINCT) 忽略 NULL 时如何统计缺失值
MySQL 的 COUNT(DISTINCT) 只统计非 NULL 唯一值。本文用订单示例区分已知客户数
Go strings.Cut 和 Split 处理键值文本有什么区别
处理键值文本时,strings.Cut 适合围绕第一个分隔符取左右两段,strings.Split 适合
跨境电商运营怎么用SkildArt?第一次完成真实任务的操作路线
本文面向首次使用SkildArt的跨境电商运营人员,梳理从素材筹备到人工复核的完整实操路线,附可复用需求