
人工智能技术文章
-
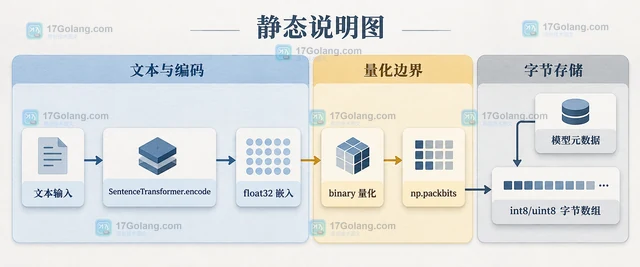
- Sentence Transformers 怎样用二进制量化保存嵌入向量
- Sentence Transformers 可以在 encode 阶段直接生成 binary 嵌入,也可以把已有 float32 向量交给 quantize_embeddings。本文说明 bit 打包后的 shape、dtype、保存元数据,以及二进制召回与高精度重排的配合方式。
- 科技周边 · 人工智能 | 1星期前 | 人工智能 · 向量数据库 · 向量检索 Sentence Transformers 嵌入向量 二进制量化 150浏览 收藏
-
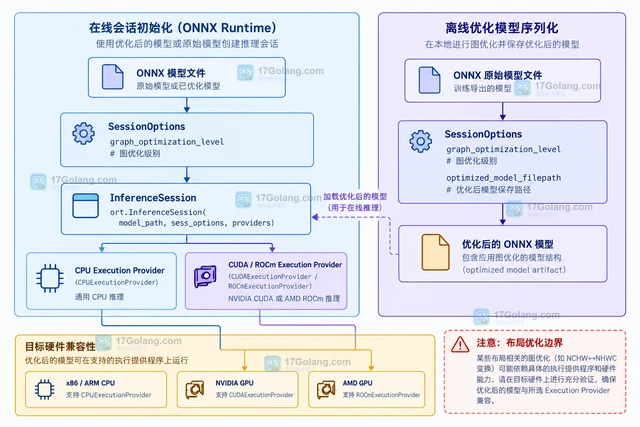
- ONNX Runtime 怎样为指定会话选择图优化等级
- ONNX Runtime 的图优化等级绑定在 SessionOptions 上,EXTENDED 会包含 basic,ALL 还包括 layout。本文给出指定 InferenceSession 的 Python 配置、在线与离线优化的边界,以及按 Execution Provider 和目标硬件做基准、回退的实用方法。
- 科技周边 · 人工智能 | 1星期前 | 性能优化 · 人工智能 · ONNX Runtime InferenceSession SessionOptions 图优化 269浏览 收藏
-
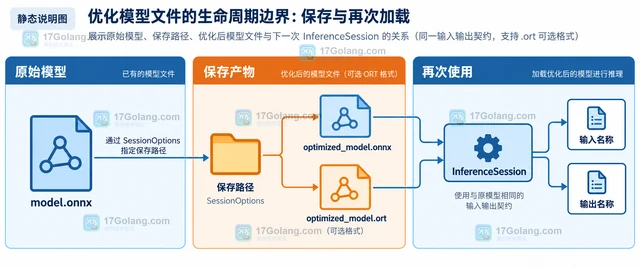
- ONNX Runtime 怎样把优化后的模型另存为文件
- ONNX Runtime 通过 SessionOptions 的图优化级别和 optimized_model_filepath 在创建推理会话时保存优化后的模型。本文说明 Python 写法、ONNX 与 ORT 格式边界,以及文件未生成时的排查方向。
- 科技周边 · 人工智能 | 1星期前 | 372浏览 收藏
-
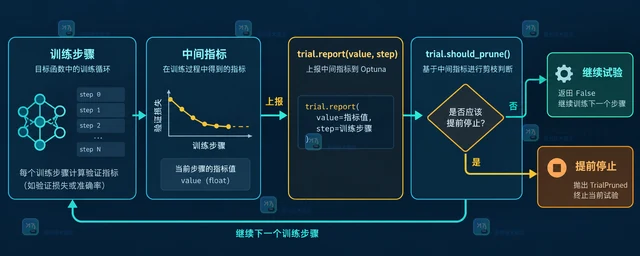
- Optuna MedianPruner 怎样结合中间指标提前停止试验
- Optuna 的 MedianPruner 不会自动猜测训练进度,关键是让 objective 在每个可比较的步骤调用 report,再用 should_prune 响应剪枝判断。本文用一个单目标验证损失示例说明启动试验数、预热步骤、检查间隔和最小样本数如何配合。
- 科技周边 · 人工智能 | 1星期前 | python · 人工智能 · Optuna 超参数优化 MedianPruner 中间指标 298浏览 收藏
-
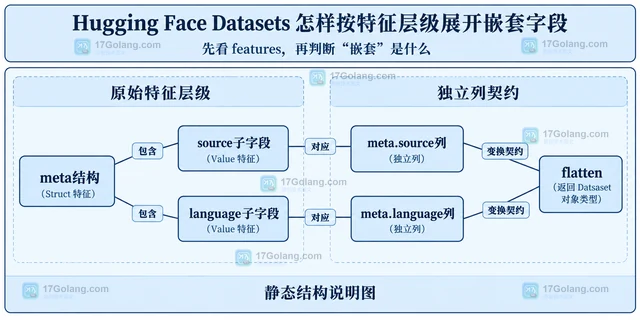
- Hugging Face Datasets 怎样按特征层级展开嵌套字段
- Hugging Face Datasets可用flatten把struct子字段展开成带层级前缀的独立列。本文通过原创样本区分Dataset与Features展开、列表拆行和索引整理,并说明下游列名契约。
- 科技周边 · 人工智能 | 1星期前 | 数据处理 · 人工智能 · 嵌套字段 Hugging Face Datasets flatten Features 350浏览 收藏
-
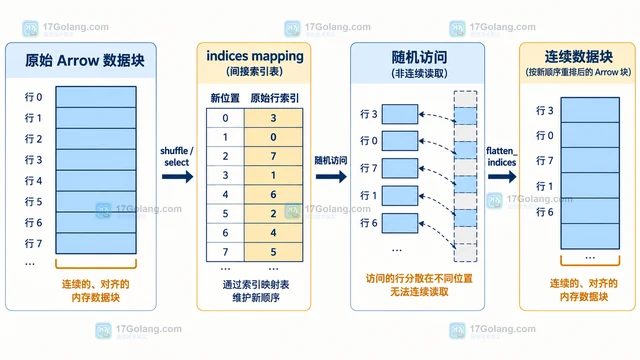
- Hugging Face Datasets 怎样用 flatten_indices 恢复顺序访问性能
- Hugging Face Datasets 在 shuffle、select 等操作后可能带有 indices mapping,导致访问不再连续。本文用 flatten_indices 重写数据,说明缓存、批量写入、并行和 IterableDataset 的选择边界。
- 科技周边 · 人工智能 | 1星期前 | 性能优化 · Hugging Face Datasets IterableDataset flatten_indices indices mapping Arrow 222浏览 收藏
-
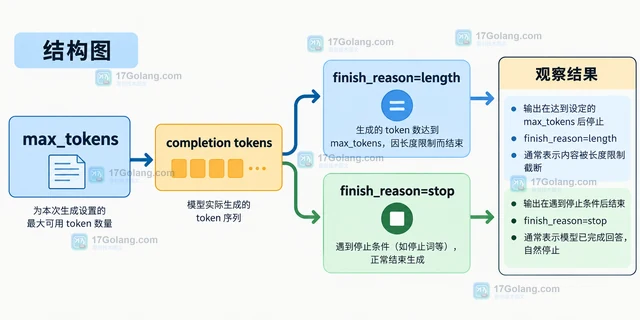
- vLLM 怎样为在线服务设置请求最大 Token 数
- 讲清 vLLM 在线服务中请求级 max_tokens 的设置位置、上下文边界与 finish_reason 判断方法,帮助按业务预算控制输出长度。
- 科技周边 · 人工智能 | 1星期前 | API · 人工智能 · vLLM max_tokens 推理服务 326浏览 收藏
-
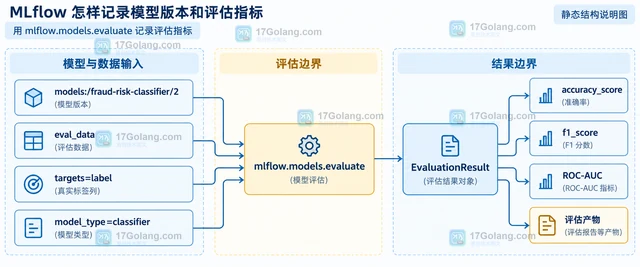
- MLflow 怎样记录模型版本和评估指标
- 用一个完整的 MLflow Run 串起参数、手工指标、模型制品、注册模型版本和测试集评估结果:先固定实验与注册模型名,再用 registered_model_name 生成版本,最后通过 mlflow.models.evaluate 读取 accuracy、F1 等指标。
- 科技周边 · 人工智能 | 1星期前 | 人工智能 · 评估指标 MLFlow 模型版本 Model Registry 机器学习实验 313浏览 收藏
-
- ONNX Runtime 怎样生成算子级延迟 profiling JSON
- 用 ONNX Runtime SessionOptions 开启 profiling,完成代表性推理后通过 end_profiling 导出 JSON,再按 Node、Kernel 与 dur 字段定位算子级延迟,避免误把主机事件和设备事件重复计算。
- 科技周边 · 人工智能 | 1星期前 | 人工智能 · Profiling ONNX Runtime 算子耗时 推理性能 JSON trace 178浏览 收藏
-
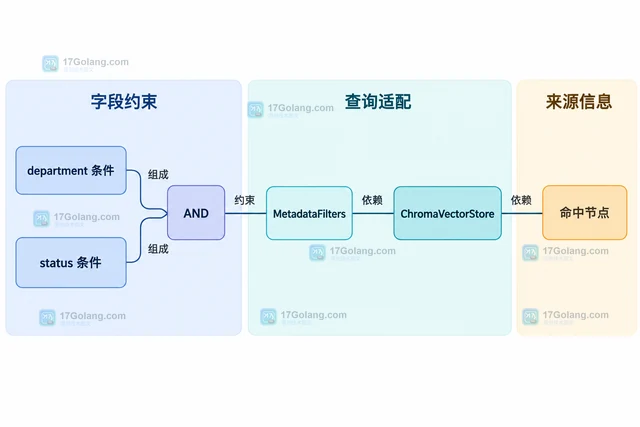
- LlamaIndex 怎样把元数据加入向量检索过滤
- 以 Chroma 为例,把节点 metadata 与 MetadataFilters 对应起来,演示等值 AND 过滤、模拟嵌入检索和临时集合清理,并解释字段类型、top-k、空结果及后端支持范围。
- 科技周边 · 人工智能 | 1星期前 | 334浏览 收藏
-
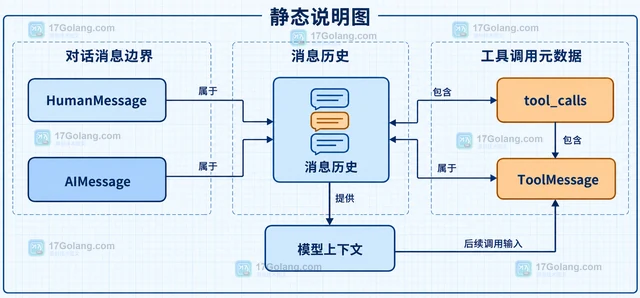
- LangChain 怎样为工具调用保留中间消息
- LangChain 工具调用需要保留完整 messages,而不是只取最终文本。本文说明 AIMessage、ToolMessage、tool_call_id、content 与 artifact 的关系,以及如何保存中间消息并继续交给模型。
- 科技周边 · 人工智能 | 1星期前 | 450浏览 收藏
-
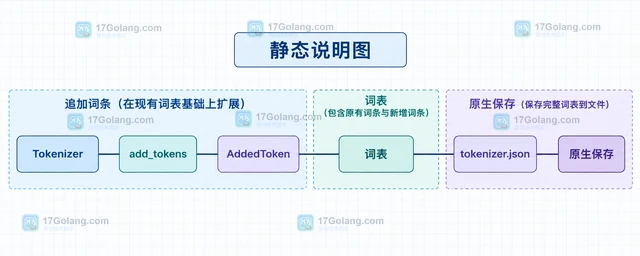
- Hugging Face Tokenizers 怎样保存自定义词表
- 用 Hugging Face Tokenizers 添加领域词条后,如何保存并重新加载自定义词表?本文区分追加词条与重新训练词表,分别说明 save()、from_file() 与 save_pretrained() 的使用边界。
- 科技周边 · 人工智能 | 1星期前 | 自定义词表 tokenizer Hugging Face Tokenizers tokenizer.json 311浏览 收藏
-
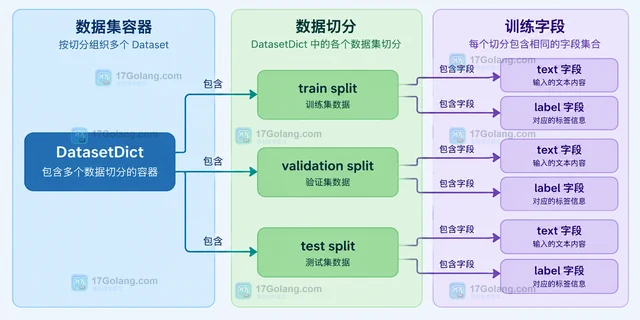
- Hugging Face Datasets select_columns 怎样只保留训练所需字段
- 用 Hugging Face Datasets 的 select_columns 从 Dataset 或 DatasetDict 中保留训练所需字段,配合 column_names、features 和 split 检查处理字段缺失与结构不一致。
- 科技周边 · 人工智能 | 1星期前 | Hugging Face Datasets select_columns DatasetDict 训练字段 174浏览 收藏
-
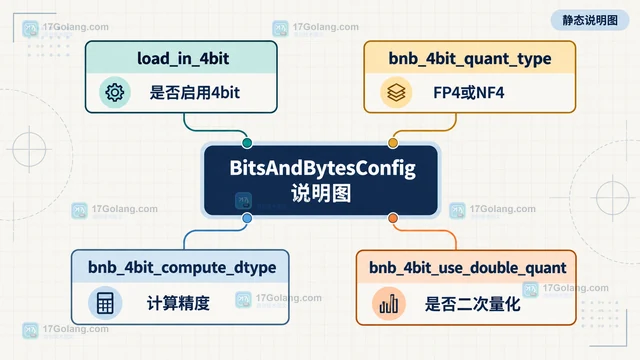
- BitsAndBytesConfig 怎样查看 4bit 量化参数
- 通过 BitsAndBytesConfig.to_dict() 和 model.config.quantization_config 读取 4bit 量化配置,重点区分 load_in_4bit、nf4/fp4、计算 dtype 与双重量化字段。
- 科技周边 · 人工智能 | 1星期前 | Transformers bitsandbytes BitsAndBytesConfig 4bit量化 205浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-
- Golang深入理解GPM模型
- Golang深入理解GPM调度器模型及全场景分析,希望您看完这套视频有所收获;包括调度器的由来和分析、GMP模型简介、以及11个场景总结。
- 474次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 925次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 932次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1031次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1010次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 841次使用


