
人工智能技术文章
-
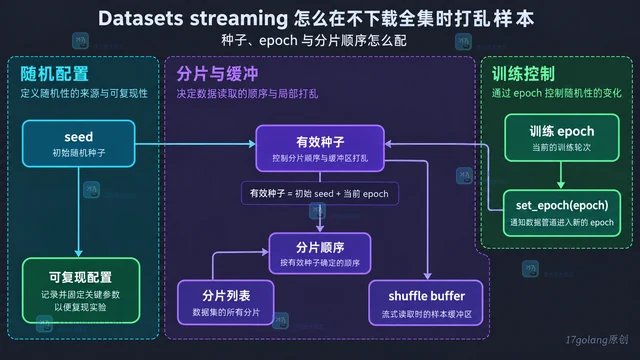
- Datasets streaming 怎么在不下载全集时打乱样本
- Hugging Face Datasets 的 streaming 模式可用 IterableDataset.shuffle 在有限缓冲区内随机采样,无需下载完整数据集。本文说明 buffer_size、seed、set_epoch、分片顺序以及 take/skip 的调用边界。
- 科技周边 · 人工智能 | 2星期前 | python · 人工智能 · shuffle Hugging Face Datasets streaming IterableDataset buffer_size 470浏览 收藏
-
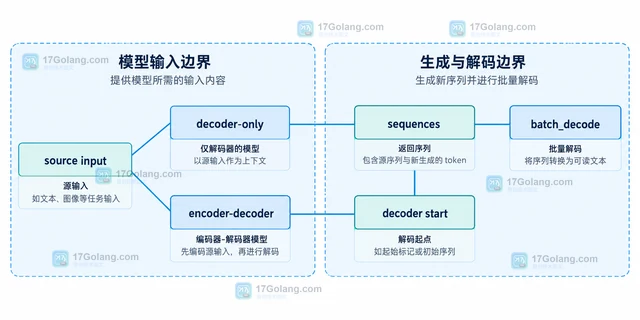
- Transformers怎样只解码新生成的token
- 讲清 Transformers generate 返回完整序列的原因,分别处理 decoder-only 与 encoder-decoder 模型,用输入长度切出新生成 token,并给出批量解码、特殊 token 和空结果的处理方式。
- 科技周边 · 人工智能 | 1星期前 | 解码 token Transformers generate 新生成内容 461浏览 收藏
-
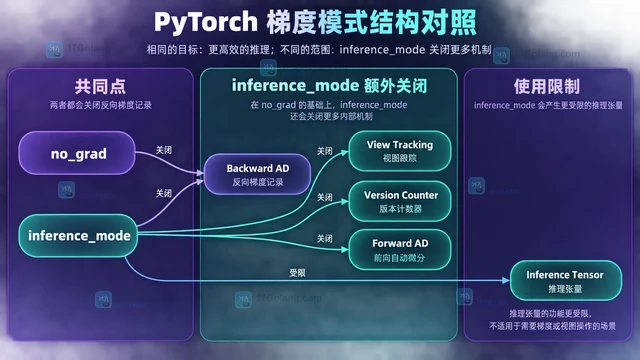
- PyTorch inference_mode 与 no_grad 有什么区别
- no_grad 关闭反向梯度记录且更宽松;inference_mode 进一步关闭视图追踪、版本计数器更新与 forward-mode AD,但推理张量不能进入后续 autograd 计算。本文给出选择表和安全写法。
- 科技周边 · 人工智能 | 3星期前 | 人工智能 · PyTorch 模型推理 inference_mode no_grad 458浏览 收藏
-
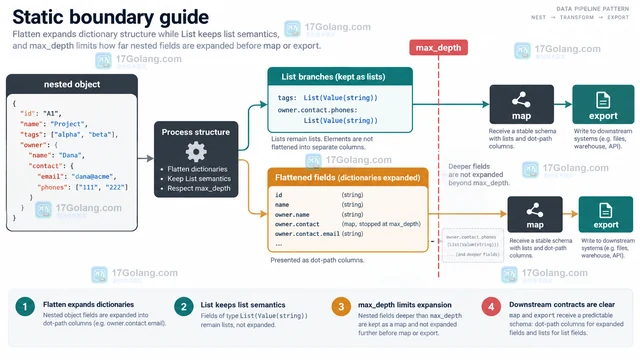
- Hugging Face Datasets flatten 怎么展开嵌套字段并保留特征类型
- Hugging Face Datasets 的 flatten 会把嵌套字典字段展开为点号路径列,同时保留 Features 对字段类型的描述。本文用嵌套 struct、List 和 max_depth 说明如何安全接入后续 map 处理。
- 科技周边 · 人工智能 | 1星期前 | 455浏览 收藏
-
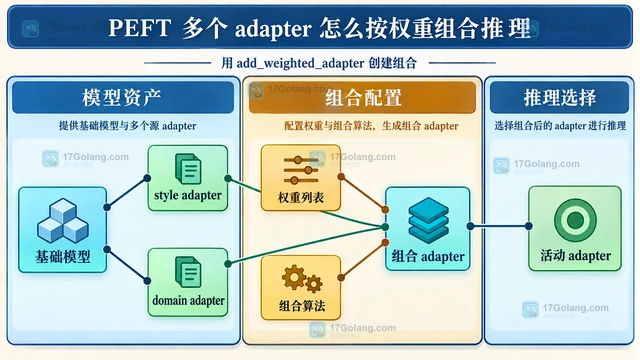
- PEFT 多个 adapter 怎么按权重组合推理
- 本文演示 PEFT 多个 LoRA adapter 的命名加载、加权组合与推理激活,说明 linear、cat、SVD、TIES 和 DARE 的选择边界及评测方法。
- 科技周边 · 人工智能 | 2星期前 | 454浏览 收藏
-
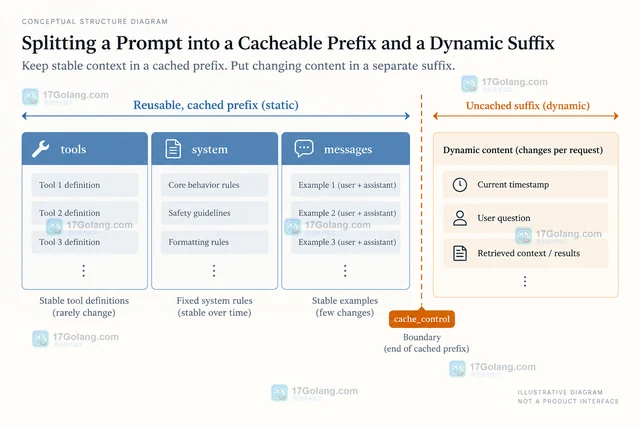
- 提示词缓存命中率低应如何划分静态前缀
- 提示词缓存命中率低时,先把工具定义、系统规则和稳定上下文划为前缀,把时间戳、用户问题和检索结果留在后缀,再用 usage 字段判断断点、TTL、长度门槛和并发时序问题。
- 科技周边 · 人工智能 | 1星期前 | 缓存 · 人工智能 · 提示词工程 · 提示词缓存 cache_control Prompt Caching 静态前缀 cache_read_input_tokens 453浏览 收藏
-
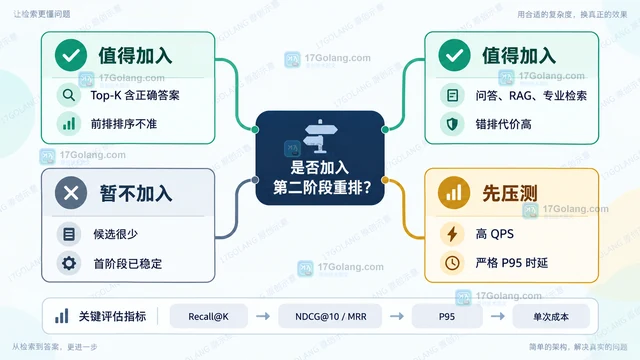
- 语义检索重排器何时值得加入第二阶段
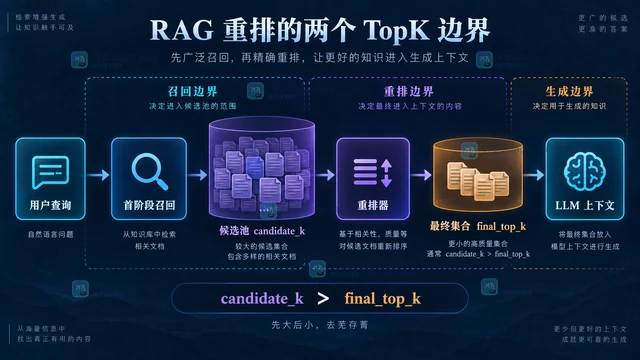
- 语义检索是否需要第二阶段重排,关键不在模型更强,而在第一阶段已能召回正确文档、前排仍错序且业务能承担额外时延。本文用 Recall@K、NDCG/MRR、P95 和单次成本给出决策与实现方法。
- 科技周边 · 人工智能 | 1星期前 | 人工智能 · rag · 语义检索重排器 第二阶段重排 Cross-Encoder Retrieve and Re-Rank Recall@K 449浏览 收藏
-
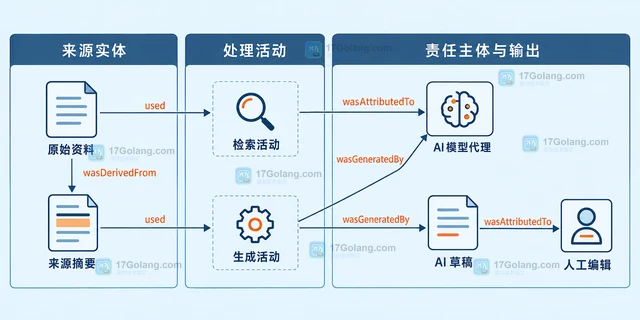
- AI 生成内容怎样保留来源和引用链
- AI 生成内容要可追溯,关键不是只保存最终答案,而是把来源实体、检索与生成活动、模型和人工角色拆开记录,再用稳定 ID 串成可查询的引用链。
- 科技周边 · 人工智能 | 6天前 | 人工智能 · AI工程 · 生成式AI 内容溯源 AI生成内容 provenance 引用链 448浏览 收藏
-
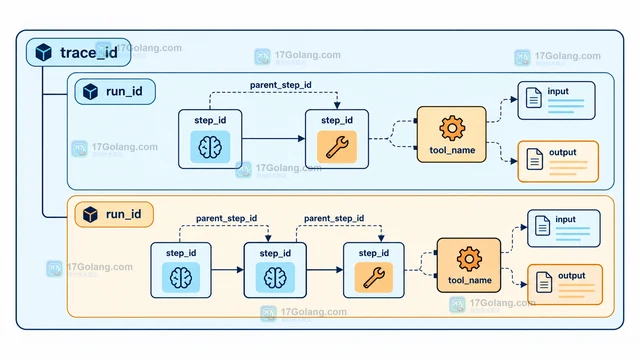
- AI Agent 怎样记录工具调用轨迹供回放
- 从 trace、run、step 三层标识出发,设计 AI Agent 工具调用轨迹,保存输入输出与版本上下文,并用夹具和沙箱划清安全回放边界。
- 科技周边 · 人工智能 | 1天前 | 444浏览 收藏
-
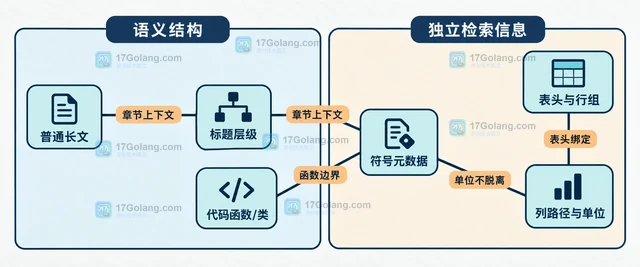
- RAG 怎样为不同文档类型设置分块策略
- RAG 分块不应让普通长文、代码和表格共用一套硬切规则。本文从召回偏移的常见症状出发,说明如何保留标题段落、函数符号、表头与行组边界,并用统一元数据和小样本查询复盘检索质量。
- 科技周边 · 人工智能 | 1天前 | 443浏览 收藏
-
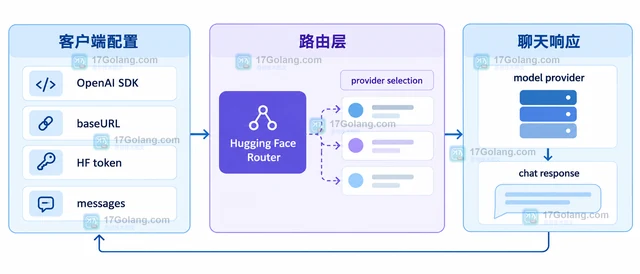
- Hugging Face 路由 API 怎样兼容 OpenAI Chat Completions
- Hugging Face Inference Providers 提供 OpenAI 兼容的 Chat Completions 路由。本文从 baseURL、HF token、messages 消息结构和模型路由后缀入手,给出一套可迁移的 Python 调用方式,并说明图片、嵌入等非聊天任务为什么要改用官方 InferenceClient。
- 科技周边 · 人工智能 | 45分钟前 | 人工智能 · 人工智能 Hugging Face Inference Providers OpenAI Chat Completions 路由 API 模型标识 HF_TOKEN 442浏览 收藏
-
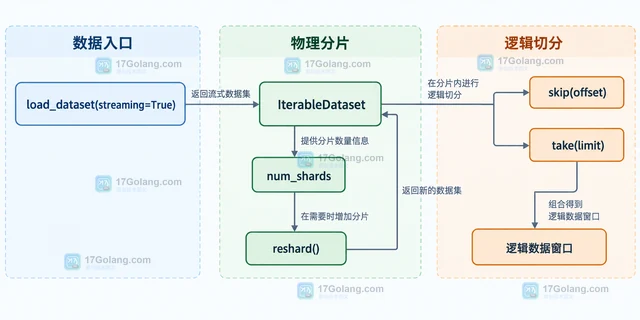
- IterableDataset 只有一个 shard 时怎么继续切分数据
- Hugging Face Datasets 的 IterableDataset 如果 reshard 后仍只有一个 shard,继续调用物理分片并不能解决切分问题。正确做法是先完成 shuffle,再用 skip 和 take 构造逻辑窗口,并明确 offset、limit、短流和重复遍历的边界。
- 科技周边 · 人工智能 | 5天前 | skip take Hugging Face Datasets streaming IterableDataset shard 441浏览 收藏
-
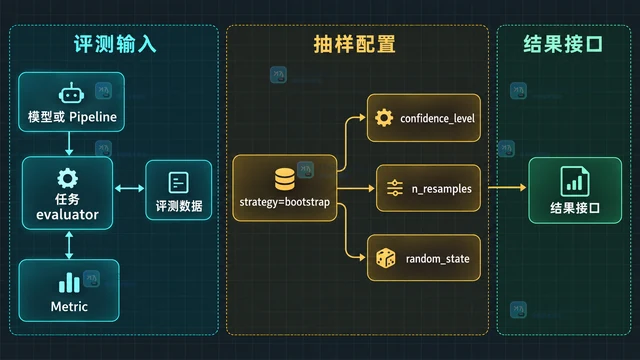
- Hugging Face Evaluate 怎么为指标计算置信区间
- 介绍 Hugging Face Evaluate 使用 bootstrap 策略计算指标置信区间的方法,解释 confidence_level、n_resamples、random_state 以及结果中的标准误。
- 科技周边 · 人工智能 | 3星期前 | python · 人工智能 · Bootstrap 模型评估 置信区间 Hugging Face Evaluate 438浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-
- Golang深入理解GPM模型
- Golang深入理解GPM调度器模型及全场景分析,希望您看完这套视频有所收获;包括调度器的由来和分析、GMP模型简介、以及11个场景总结。
- 474次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 571次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 615次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 645次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 603次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 420次使用


