
AI Agent 怎样记录工具调用轨迹供回放
AI Agent 出问题时,最后一段回答往往只能说明“结果不对”,却说明不了它先调用了哪个工具、传了什么参数、拿到什么版本的数据。要做到可回放,核心不是把聊天记录越存越长,而是把一次运行拆成可定位的步骤,并为每个步骤固定输入、输出和执行上下文。
参考地址:https://huggingface.co/docs/hub/agent-traces
参考地址:https://opentelemetry.io/docs/specs/otel/trace/api/
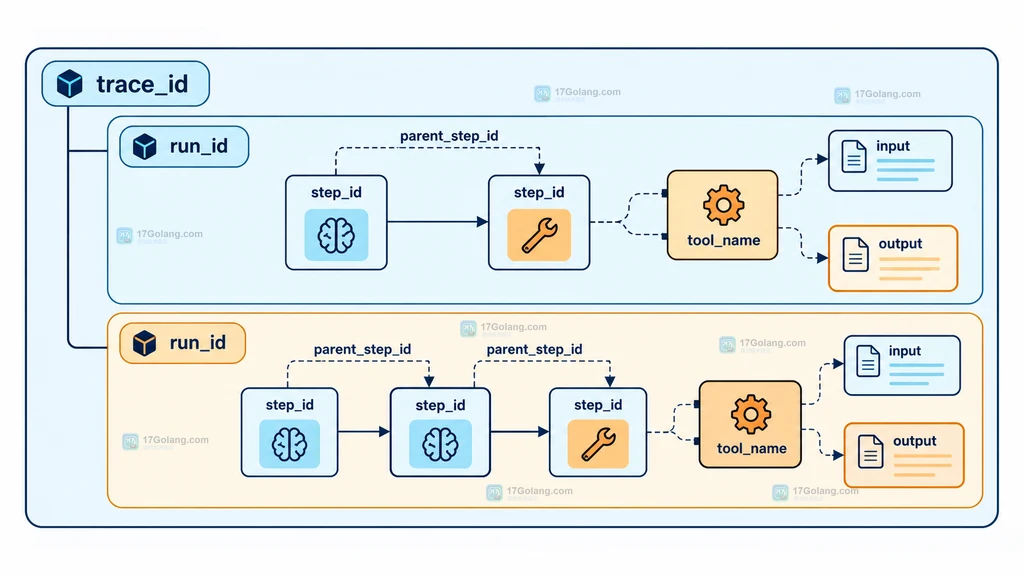
- 用 trace_id 关联一次用户任务,用 run_id 区分重试,用 step_id 定位每个模型或工具步骤。
- 工具调用至少记录名称、版本、规范化输入、输出摘要、耗时、错误和副作用等级。
- 回放优先进入沙箱或替身;真实写入、删除、发消息等动作不能直接照着历史轨迹再执行。
先把一次 Agent 运行拆成三层标识
我更愿意把轨迹看成一棵树,而不是一条拼接后的字符串。trace_id代表用户任务的完整生命周期,run_id代表一次具体尝试,step_id代表模型决策、工具调用或工具返回。这样一来,第一次运行失败后再次尝试,不会覆盖第一次的证据;一个工具内部重试,也能保留父子关系。
每个 step 的最小字段可以按下面的结构设计:
# 这个记录只描述一次工具调用,不保存无法回放的隐式全局状态
step = {
    "schema_version": 1,
    "trace_id": "tr_20261019_001",
    "run_id": "run_02",
    "step_id": "step_04",
    "parent_step_id": "step_03",
    "kind": "tool_call",
    "tool_name": "orders.search",
    "tool_version": "orders-api@2026.10",
    "input": {"customer_id": "c_17", "limit": 20},
    "output": {"count": 2, "items_digest": "sha256:..."},
    "started_at": "2026-10-19T10:01:02Z",
    "duration_ms": 183,
    "status": "ok",
    "side_effect": "read_only"
}
input和output不一定都要存原文。大对象可以保存脱敏后的摘要与对象地址,但摘要必须能帮助定位“是否拿到了同一份输入”。日志、提示词、密钥、个人信息和返回正文也要有单独的保留策略,不能因为可回放就无限制落盘。
记录字段时要把“能比较”和“会变化”分开
工具回放最容易踩的坑,是把所有字段都当作严格相等。时间戳、请求 ID、随机排序、令牌消耗和实时库存本来就可能变化;工具名、参数语义、返回状态和业务对象摘要则更适合参与回归比较。我通常会给字段加上比较策略,而不是在测试代码里到处写例外。
| 字段 | 记录目的 | 回放比较方式 |
|---|---|---|
| tool_name / tool_version | 确认实际执行了哪个能力 | 严格相等,版本变化单独标记 |
| input | 复现调用条件 | 规范化后比较,隐藏凭据 |
| output | 观察工具给 Agent 的事实 | 按业务字段比较,允许顺序差异 |
| duration_ms | 定位慢调用 | 只做趋势或阈值比较 |
| side_effect | 决定能否直接回放 | 作为执行门禁,不参与内容相等判断 |
OpenTelemetry 的 span 和 event 思路很适合承载这类上下文:把一次 Agent 运行作为父级范围,把模型调用和工具调用挂成子节点,再用事件记录异常或关键状态。无论最终落到 JSONL、数据库还是追踪系统,字段语义都应该先稳定下来,存储方式可以后换。
副作用工具必须用录制结果或沙箱回放
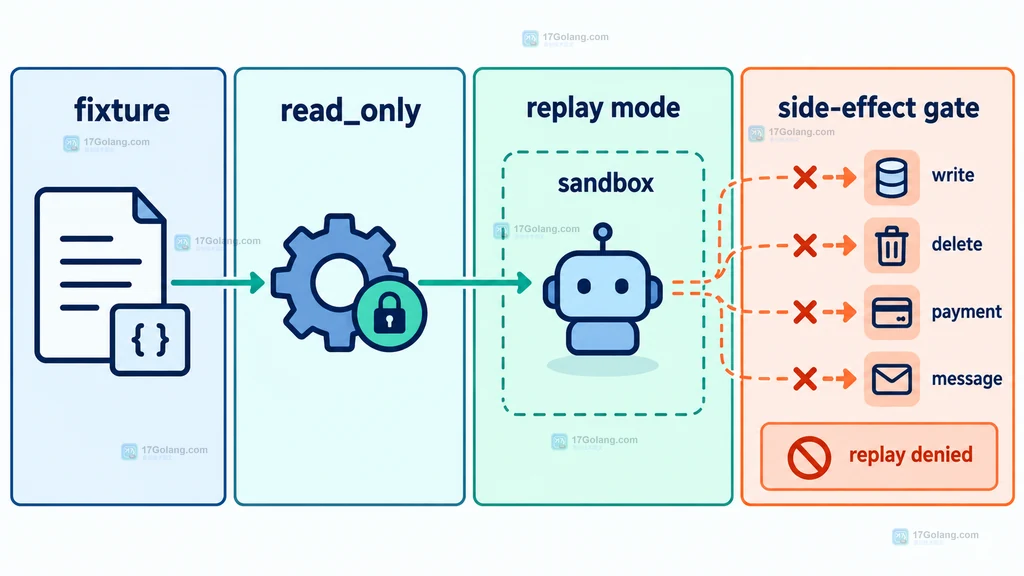
“回放”不是把旧的工具参数重新发送一遍。查询订单、读取文档这类只读动作可以指向冻结数据集;发送邮件、扣款、删除文件、写入生产数据库则必须拒绝直连。安全的做法是给工具声明副作用等级,并在 replay 模式下注入替身:
# replay 模式只允许读取录制夹具;写操作没有夹具就直接失败
def invoke_tool(tool, payload, mode, fixtures):
    # 先用稳定键查找夹具,避免把真实凭据放进回放请求
    fixture_key = make_fixture_key(tool.name, payload)
    if mode == "replay":
        if tool.side_effect != "read_only" or fixture_key not in fixtures:
            raise RuntimeError("replay denied: side effect or fixture missing")
        # 返回录制结果,不访问真实外部系统
        return fixtures[fixture_key]
    # live 模式才允许经过正常的鉴权、超时和审计链路
    return tool.call(payload)
夹具最好与工具版本、输入摘要和数据集版本一起保存。否则同一个参数在接口升级后可能得到完全不同的结构,回放失败时就分不清是 Agent 决策变了,还是工具事实变了。涉及隐私的轨迹还应在导出前脱敏,并设置保存期限。
最后按语义比较,而不是只比整段 JSON
回放完成后,先比较步骤树是否一致,再比较每个步骤的输入和输出。对列表按业务主键排序,对时间字段做归一化,对不可控的实时值只记录差异提示。真正需要升级处理的,是工具选择变了、参数缺失、错误类型改变,或 Agent 在没有新证据时走出了不同分支。
一个实用的检查顺序是:① trace/run 是否对应同一任务;② step 父子关系和工具名称是否一致;③ 输入是否只差脱敏或规范化字段;④ 输出差异是否来自数据集版本;⑤ 是否出现了本应被 replay 门禁拦截的副作用调用。这个顺序能把“轨迹不一致”和“业务数据变化”分开。
常见问题
只保存最终回答,后面补工具轨迹可以吗?
通常不行。最终回答无法恢复工具输入、返回顺序和错误分支,最多只能从下一次运行开始补采集。
工具输出要不要完整保存?
不必一刀切。对小型、低敏感结果可保存原文;大对象和敏感字段更适合保存脱敏摘要、版本号和可控的内部引用。
回放结果不同就说明 Agent 回归了吗?
不一定。先排除数据集、工具版本、时间和随机 ID 的变化,再判断工具选择、关键参数和错误语义是否真的改变。
真正可用的 Agent 轨迹,重点不在于记录更多,而在于让每个步骤都能回答三个问题:当时调用了什么、依据是什么、在什么边界内允许重做。把这三件事固定下来,调试、回归和事故复盘才会共享同一份证据。
 向量检索怎样为时间敏感文档设置有效期过滤
- 上一篇
- 向量检索怎样为时间敏感文档设置有效期过滤
- 下一篇
- AI Agent 怎样把工具调用权限拆成最小范围
-
- 科技周边 · 人工智能 | 49分钟前 | RAG AI评测 生成错误 检索错误 faithfulness context precision
- AI 评测怎样区分检索错误与生成错误
- 419浏览 收藏
-
- 科技周边 · 人工智能 | 52分钟前 | 人工智能 · 多模态 · 多模态输入 Processor Hugging Face Transformers chat template 图片文本绑定
- 多模态输入怎样把图片与文本绑定同一请求
- 199浏览 收藏
-
- 科技周边 · 人工智能 | 55分钟前 |
- 结构化输出怎样处理模型缺少可选字段
- 288浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- RAG 怎样为不同文档类型设置分块策略
- 443浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- RAG 检索怎样用 query rewrite 减少召回偏移
- 416浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- Hugging Face Hub 怎样用 commit hash 固定模型文件版本
- 191浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 548次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 601次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 628次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 581次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 406次使用
-
- 量化模型本地推理的显存估算方法
- 2026-10-17 501浏览
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览


