
Go语言技术文章
-
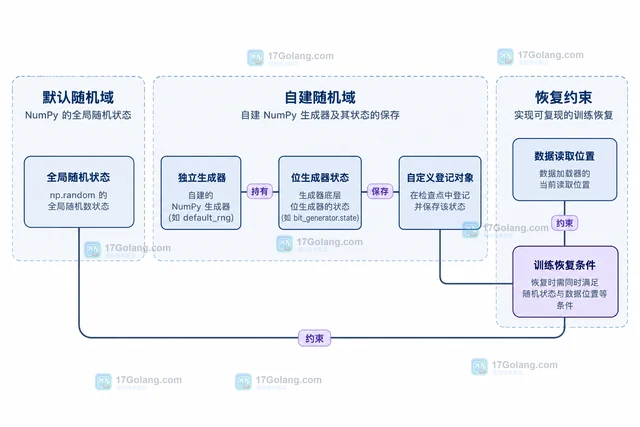
- Accelerate恢复训练时如何保存随机数状态
- 用Accelerate的save_state与load_state保存和恢复训练随机数状态,通过epoch边界示例说明加载时机、自建生成器登记和数据位置区别,避免将固定seed误当断点恢复。
- 科技周边 · 人工智能 | 13小时前 | PyTorch checkpoint Accelerate 随机数状态 恢复训练 326浏览 收藏
-
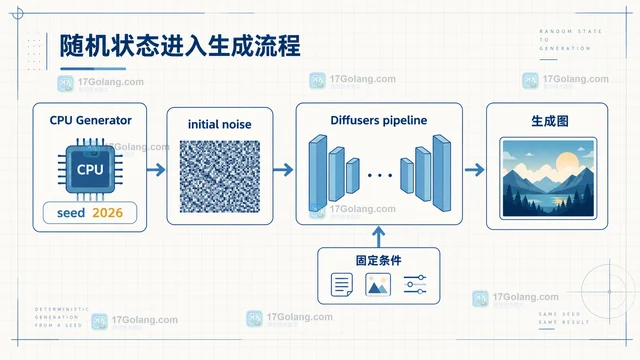
- Diffusers怎样使用Generator复现同一张生成图
- Diffusers 生成结果每次不同,通常与随机状态和采样条件有关。本文用 CPU torch.Generator 说明怎样固定初始噪声、每次重新播种,并整理模型、提示词、步数和调度器的复现清单。
- 科技周边 · 人工智能 | 13小时前 | 118浏览 收藏
-
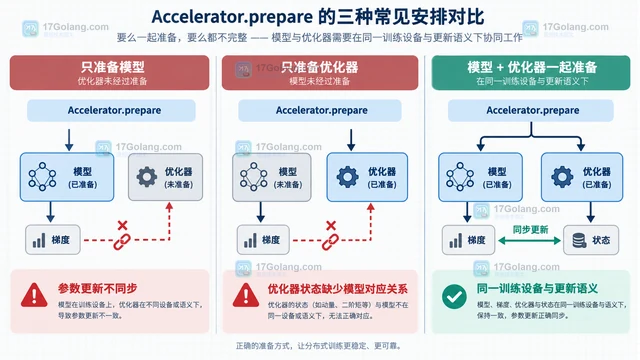
- Accelerate prepare为什么要同时接收模型与优化器
- Accelerator.prepare 不只是把模型搬到设备上;训练时模型包装、参数位置、优化器参数组和状态必须保持一致,所以通常要把模型与优化器一起交给 Accelerate 准备。本文用最小训练骨架说明对象顺序、调度器和推理场景的边界。
- 科技周边 · 人工智能 | 13小时前 | 模型 混合精度 优化器 分布式训练 Accelerate Accelerator.prepare 386浏览 收藏
-
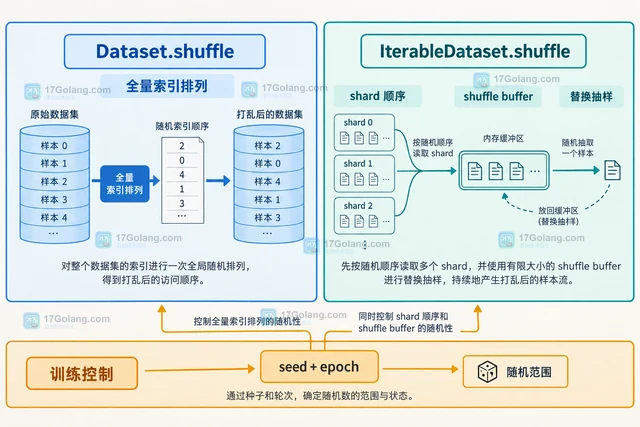
- Datasets流式读取与内存数据集的shuffle有什么区别
- Hugging Face Datasets 的 Dataset.shuffle 会为内存数据集建立全量索引映射,IterableDataset.shuffle 则通过 shard 顺序和有限 shuffle buffer 做近似随机。本文解释两者的访问模型、随机范围、性能代价与训练参数选择。
- 科技周边 · 人工智能 | 13小时前 | 人工智能 · Hugging Face Datasets streaming IterableDataset Dataset.shuffle shuffle buffer 130浏览 收藏
-
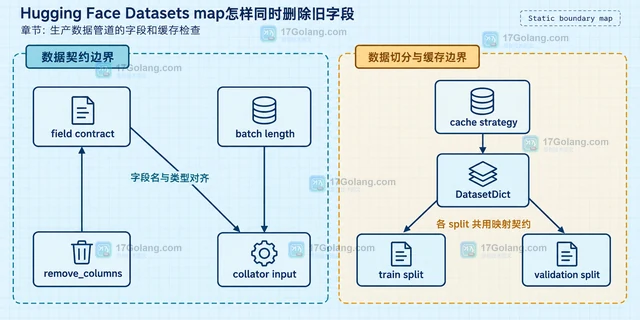
- Hugging Face Datasets map怎样同时删除旧字段
- Hugging Face Datasets 用 map 转换样本时,可以通过 remove_columns 一次删除多个旧字段。本文说明单条与批量映射、同名覆盖、DatasetDict 和缓存边界。
- 科技周边 · 人工智能 | 13小时前 | 421浏览 收藏
-
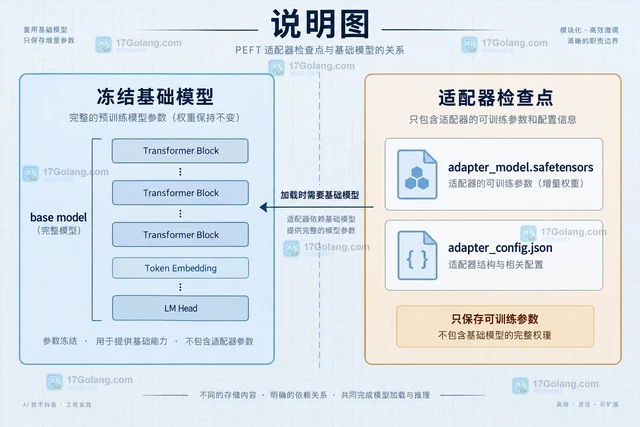
- PEFT适配器检查点为什么不包含完整基础模型
- 使用 Hugging Face PEFT 训练适配器后,检查点通常只包含适配器权重和配置,不会复制完整基础模型。本文从目录现象出发,说明保存设计、恢复加载、继续训练与合并导出的区别。
- 科技周边 · 人工智能 | 13小时前 | 301浏览 收藏
-
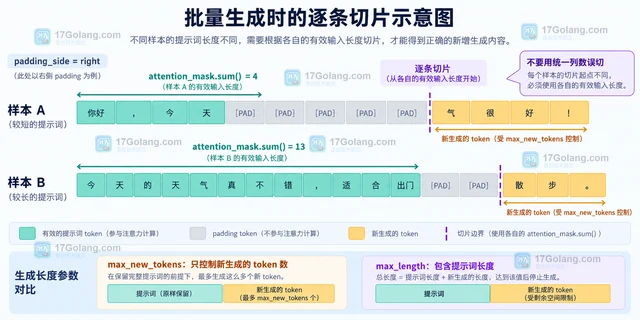
- Transformers生成结果为什么包含输入提示词
- Transformers 的 generate 返回完整序列时,GPT 类 decoder-only 模型会把输入提示词和新增 token 一起返回。本文用 token 长度切片、批量 padding 和 max_new_tokens 说明如何稳定取出真正生成的文本。
- 科技周边 · 人工智能 | 13小时前 | python · Hugging Face 提示词 Transformers generate input_ids 111浏览 收藏
-
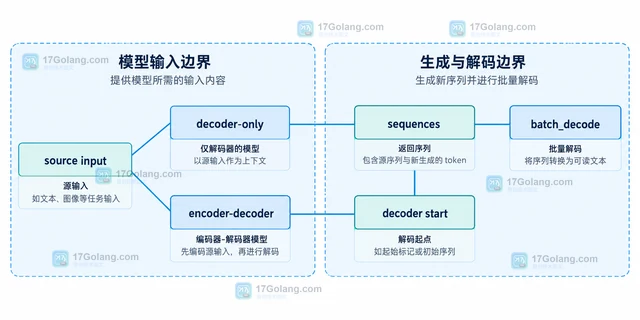
- Transformers怎样只解码新生成的token
- 讲清 Transformers generate 返回完整序列的原因,分别处理 decoder-only 与 encoder-decoder 模型,用输入长度切出新生成 token,并给出批量解码、特殊 token 和空结果的处理方式。
- 科技周边 · 人工智能 | 13小时前 | 解码 token Transformers generate 新生成内容 461浏览 收藏
-
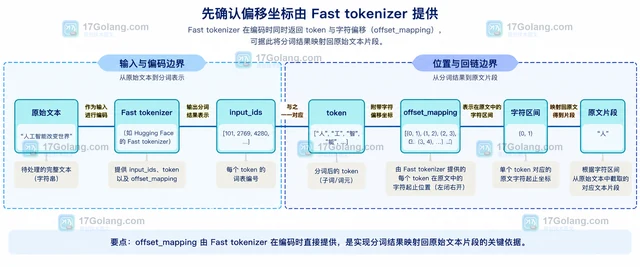
- Transformers分词偏移怎样映射回原始文本片段
- 使用 Transformers Fast tokenizer 的 offset_mapping 把 token 位置还原为原始文本片段,并处理特殊 token、批量溢出、成对输入与预分词边界。
- 科技周边 · 人工智能 | 13小时前 | python · 人工智能 · Transformers offset_mapping 原始文本 Fast tokenizer 文本偏移 330浏览 收藏
-
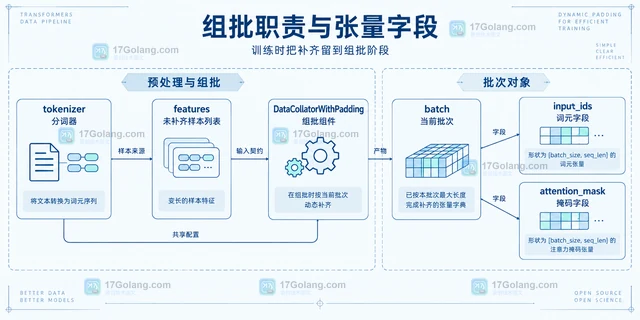
- Transformers批次分词时动态补齐与固定长度补齐怎么选
- 比较Transformers批次分词的动态补齐与固定长度补齐,说明截断上限、collator组批职责和部署形状约束,并给出可复制代码与实际观测指标。
- 科技周边 · 人工智能 | 13小时前 | Transformers 固定长度 tokenizer 动态补齐 DataCollatorWithPadding 153浏览 收藏
-
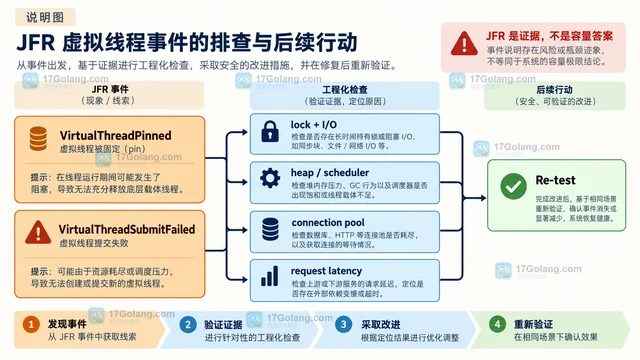
- OpenJDK 虚拟线程与 JFR 观测如何协同
- OpenJDK 虚拟线程降低了高并发等待型任务的线程成本,但是否真的改善服务端表现,仍要结合 JFR 观察 pinning、提交失败、阻塞事件与外部资源。本文给出一套从录制到判断的协同方法。
- 科技周边 · 业界新闻 | 1天前 | 虚拟线程 · 虚拟线程 OpenJDK JFR VirtualThreadPinned Java Flight Recorder 480浏览 收藏
-
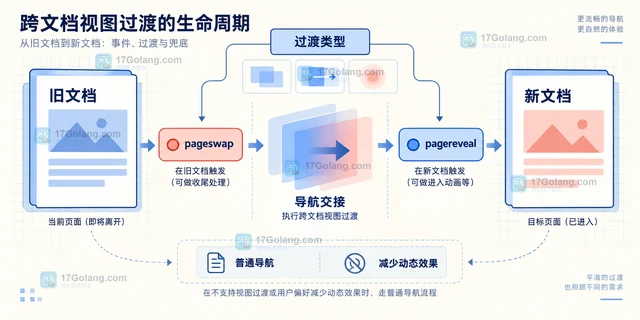
- 浏览器 View Transition 跨文档能力为何值得关注
- 跨文档 View Transition 让传统多页站点也能在同源导航时获得连续的页面切换效果。本文用一个列表页到详情页的小项目说明最小 CSS 配置、命名元素、事件定制与降级边界。
- 科技周边 · 业界新闻 | 1天前 | 338浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-
- Golang深入理解GPM模型
- Golang深入理解GPM调度器模型及全场景分析,希望您看完这套视频有所收获;包括调度器的由来和分析、GMP模型简介、以及11个场景总结。
- 474次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 466次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 528次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 546次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 497次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 316次使用


