
王兴谈外卖竞争:坚持正确事,反对内卷
2025-08-31 18:18:55
0浏览
收藏
美团CEO王兴在近期财报电话会上,针对外卖市场竞争加剧的现状,明确表达了美团的态度:坚决反对内卷,坚持做正确的事。他强调,美团将继续捍卫市场地位,并在竞争中不断壮大。王兴回顾了美团在过去竞争中取得的领先地位,并表示美团始终专注于为用户创造良好的体验,保证优质供给、稳定履约和合理价格。他强调,美团将回归本质,确保快速可靠的履约和经济实惠的价格,以应对当前激烈的市场竞争。此次表态体现了美团在外卖市场竞争中的策略和决心,也预示着未来外卖行业将更加注重用户体验和健康发展。
8月28日消息,据媒体报道,昨日,美团发布2025年第二季度业绩报告,今年二季度,美团营收同比增长11.7%至918亿元。
在财报电话会上,美团CEO王兴再次强调:“首先明确,我们坚决反对内卷。”
他表示,当前外卖市场竞争持续加剧,美团将继续捍卫市场地位。
“美团是在竞争中成长起来的,我们在持续的竞争中实现了今天的领先地位。”
王兴表示,美团不是第一次面对这种激烈的竞争,在过去多年的发展中,美团在竞争中不断壮大、巩固领先地位。
“此外,无论过去还是现在,美团始终专注于做正确的事,即,保证优质供给、稳定履约、合理价格,为用户创造良好的体验。”
他还强调,美团坚持做正确的事这一点不会变。“没有什么花哨的,回归本质,确保快速可靠地履约、确保经济实惠的价格。”

今天关于《王兴谈外卖竞争:坚持正确事,反对内卷》的内容介绍就到此结束,如果有什么疑问或者建议,可以在golang学习网公众号下多多回复交流;文中若有不正之处,也希望回复留言以告知!
 AI工具全场景适配,写作建站一站式解决
- 上一篇
- AI工具全场景适配,写作建站一站式解决

- 下一篇
- JS判断数据类型的方法有哪些?
查看更多
最新文章
-
- 科技周边 · 业界新闻 | 6小时前 | kubernetes · sidecar 服务网格 Istio ambient
- 服务网格流量治理从sidecar到ambient模式的选型方法
- 216浏览 收藏
-
- 科技周边 · 业界新闻 | 7小时前 | 容器 · 供应链安全 · OCI 镜像供应链 provenance SBOM Referrers
- OCI镜像供应链元数据在多环境发布中的保留方式
- 153浏览 收藏
-
- 科技周边 · 业界新闻 | 2天前 |
- 浏览器隐私沙盒能力变化下的前端数据方案调整
- 375浏览 收藏
-
- 科技周边 · 业界新闻 | 2天前 |
- PHP扩展兼容矩阵在升级前的验收方法
- 265浏览 收藏
-
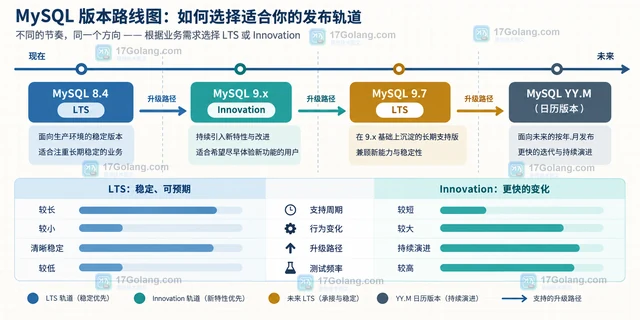
- 科技周边 · 业界新闻 | 5天前 |
- MySQL LTS与创新版本迁移窗口的评估清单
- 265浏览 收藏
-
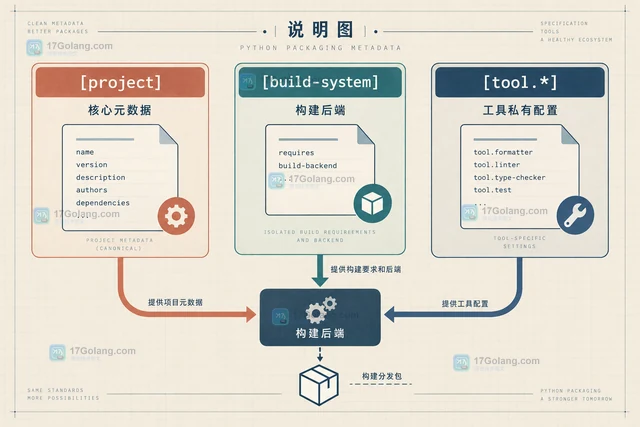
- 科技周边 · 业界新闻 | 5天前 | python ·
- Python打包元数据标准化后的构建流水线调整方法
- 396浏览 收藏
-
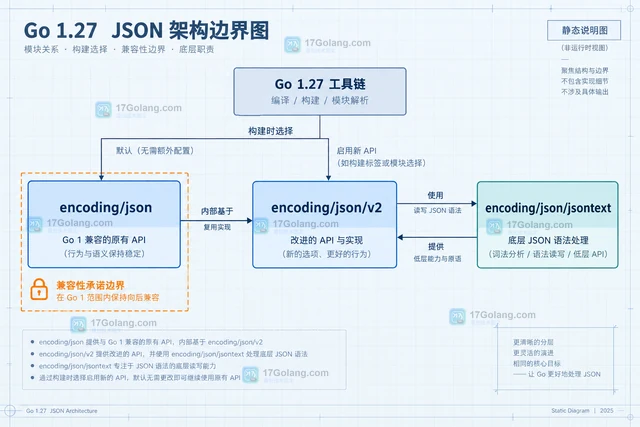
- 科技周边 · 业界新闻 | 5天前 | go · 业界新闻 · encoding/json · 版本迁移 · 兼容性 · encoding/json Go工具链 jsonv2 Go 1.27 JSON兼容性
- Go工具链JSON实验开关对编码兼容性的影响范围
- 293浏览 收藏
-
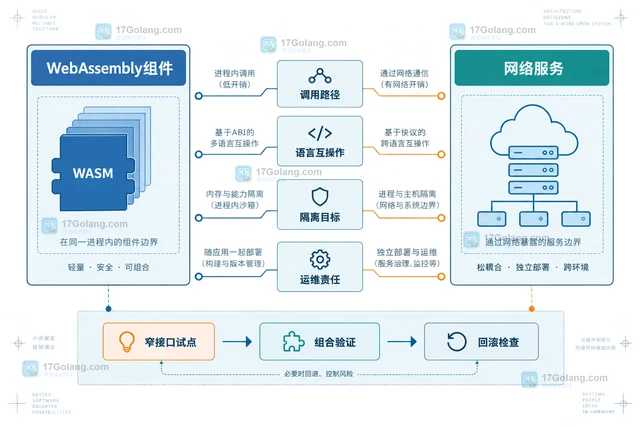
- 科技周边 · 业界新闻 | 5天前 | 架构设计 · 业界新闻 · WebAssembly WASI WIT 服务边界 组件模型
- WebAssembly组件模型在服务边界选择中的判断表
- 272浏览 收藏
-
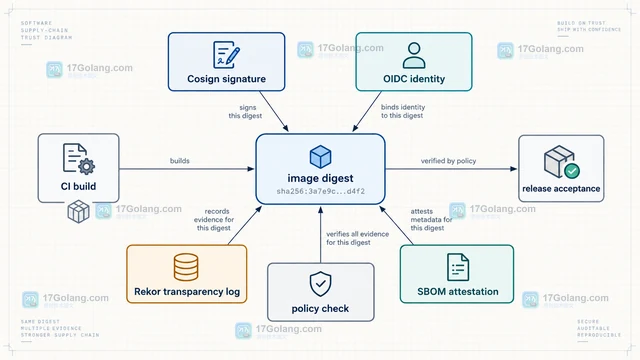
- 科技周边 · 业界新闻 | 5天前 | CI · 供应链安全 ·
- CNCF供应链签名在CI产物验收中的接入方案
- 105浏览 收藏
-
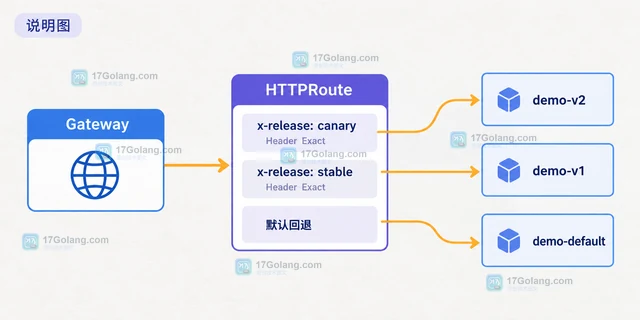
- 科技周边 · 业界新闻 | 5天前 |
- Kubernetes Gateway API按Header拆分路由的配置方法
- 391浏览 收藏
-
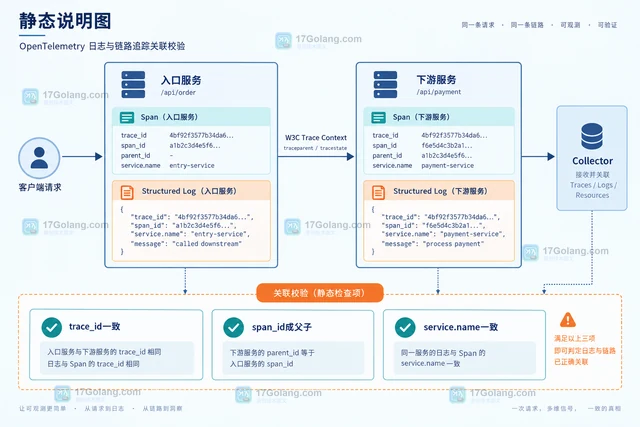
- 科技周边 · 业界新闻 | 5天前 | 日志 · 可观测性 · OpenTelemetry trace trace_id 日志关联 span_id
- OpenTelemetry日志与Trace关联字段的落地清单
- 375浏览 收藏
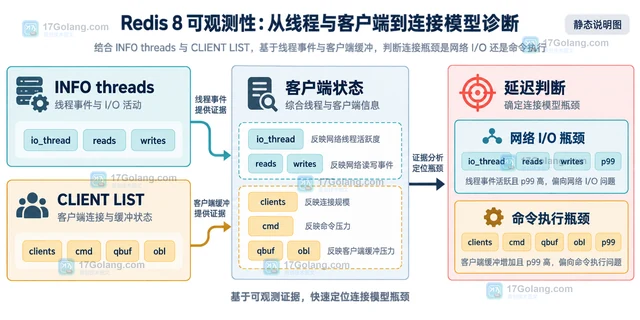
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 213次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 267次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 225次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 211次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 201次使用
查看更多
相关文章
-
- 蒙面演唱引争议,旺仔小乔被平台封禁
- 2025-08-08 501浏览
-
- openGauss向量驱动升级,RAC多写突破内核
- 2025-07-30 501浏览
-
- 安普瑞斯工厂放假,电芯供应受影响
- 2025-07-04 501浏览
-
- 农产品APP开发优势与功能全解析
- 2025-04-30 501浏览
-
- 开店省钱妙招,外卖系统同城配送运营攻略
- 2025-04-26 501浏览


