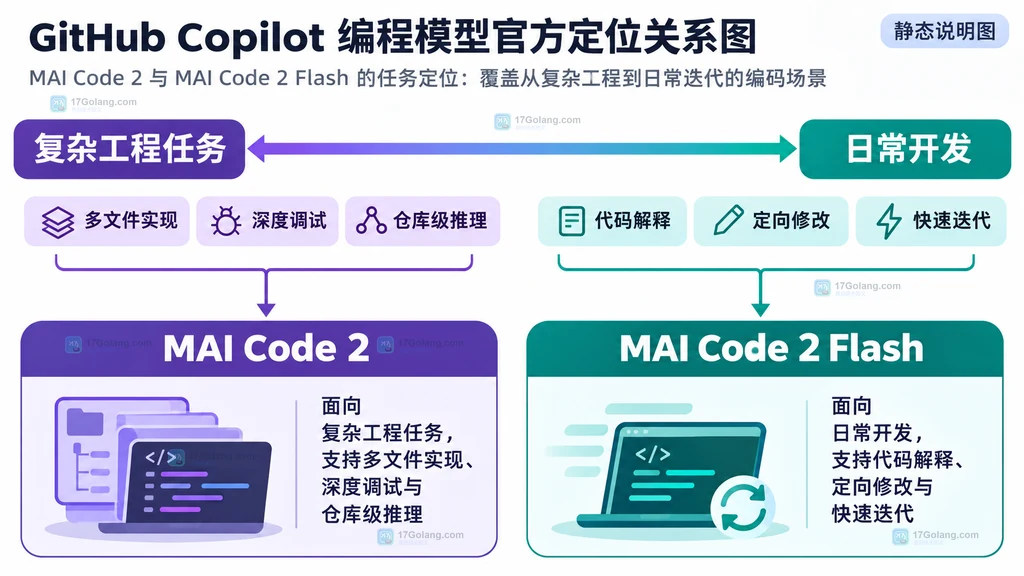
GitHub 在 2026 年 11 月 17 日的官方公告中,把 MAI Code 2 和 MAI Code 2 Flash 一起带入 GitHub Copilot,但两者不是同一个模型的简单快慢档。公告给出的核心分工是:MAI Code 2 面向复杂、多文件、深度调试和仓库级推理;MAI Code 2 Flash 面向代码解释、定向修改、常规修复和快速迭代。团队选择时,应该先看任务形态,再看账号与客户端是否满足接入条件。
官方公告:https://github.blog/changelog/2026-11-17-mai-code-2-and-mai-code-2-flash-in-github-copilot/
模型文档:https://docs.github.com/en/copilot/reference/ai-models/supported-models
可以把这次更新理解为一组任务分流入口:复杂工程任务优先评估 MAI Code 2,日常小步修改优先评估 MAI Code 2 Flash;但“适合什么任务”是官方定位,不等于对每个仓库都成立的性能保证。
公告到底新增了什么
这条 Changelog 的事实范围很窄:GitHub 宣布 Microsoft AI 的下一代编码模型进入 Copilot,并明确给出两个名称、两种定位、用量计费方式和可用入口。公告没有给出一张可以直接替代实际试用的统一跑分表,因此阅读时要把“模型类别”和“模型效果”分开。
MAI Code 2 被归到更强、更通用的编码任务方向,目标是让开发者从需求走到结果,减少不必要的来回沟通;MAI Code 2 Flash 则被归到轻量、成本效率优先的方向,适合高频、范围较小的开发动作。这里的“复杂”和“轻量”描述的是推荐任务边界,不是对某次生成结果的保证。
另外,两者都按用量计费。Flash 的轻量定位不能被解读为“免费模型”,最终成本还要结合 Copilot 计划、AI credits 或 usage-based billing 规则阅读。
两种模型如何分工
最实用的判断方法是先看一次请求需要多少上下文和多少轮修改。若任务要同时理解多个目录、追踪跨文件调用、做深度调试或进行仓库级推理,可以把 MAI Code 2 作为优先候选。若只是解释一段函数、改一个局部条件、修复常规问题或快速重复尝试,MAI Code 2 Flash 更贴近公告给出的使用场景。
| 任务特征 | 优先评估 | 原因 |
|---|---|---|
| 多文件实现、复杂重构 | MAI Code 2 | 公告将它定位为通用、强能力的编码模型 |
| 深度调试、仓库级推理 | MAI Code 2 | 需要更长的上下文链路和更少的来回拆解 |
| 代码解释、定向编辑 | MAI Code 2 Flash | 请求边界小,反馈周期短 |
| 常规修复、快速迭代 | MAI Code 2 Flash | 更符合轻量和成本效率优先的定位 |
这张表是基于官方场景描述整理的决策起点,不是模型质量排名。真实接入时仍应使用团队自己的典型任务,记录一次请求的上下文范围、修改轮次、人工返工和消耗,再决定是否固定分流。
接入面和团队策略怎么读
公告列出的入口包括 Visual Studio Code、Visual Studio、Copilot CLI、GitHub Copilot cloud agent、Copilot app、github.com、GitHub Mobile、JetBrains、Xcode 和 Eclipse。它表达的是 Copilot 的支持面,而不是承诺每一个账号在所有客户端同时看到模型。
公告同时写明:MAI Code 2 面向 Copilot Pro、Pro+、Max、Business 和 Enterprise;MAI Code 2 Flash 的计划范围更广,包含 Free、Student、Pro、Pro+、Max、Business 和 Enterprise。两者都限定在符合条件的年度订阅用户范围内。这里的 eligible 仍然是账号与计划条件,不能仅凭客户端版本推断开放资格。
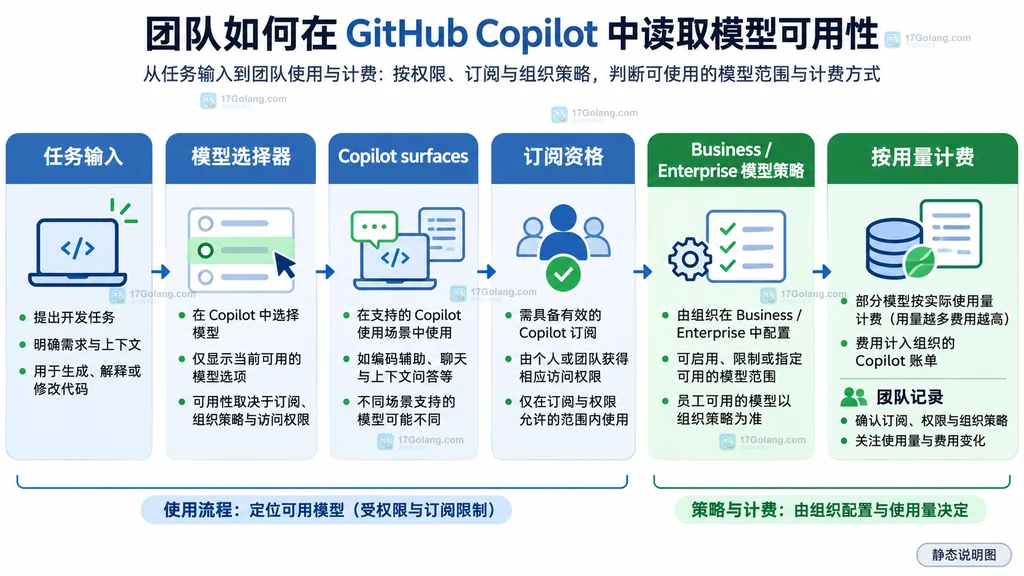
对 Business 和 Enterprise 团队,管理员还可以通过 Copilot 设置中的 model policy 管理 MAI 模型访问。默认模型启用时,新模型会自动启用;如果管理员关闭了全局默认设置或明确禁用该模型,成员就不能把“公告已发布”直接等同于“本组织可选”。
如何把公告转成采用步骤
- 先选 3 类真实任务:复杂多文件任务、局部修复任务、代码解释任务,避免只用一个示例做结论。
- 在实际 Copilot 客户端的模型选择器中记录模型是否可见,并同时记录订阅计划和客户端名称。
- 把复杂任务和日常任务分别交给两个模型尝试,记录人工返工、来回轮次、生成改动范围和用量信息。
- Business 或 Enterprise 组织要让管理员确认 model policy;个人账号则重点核对计划资格和计费页面。
- 按团队最常见的任务类型形成默认建议,但保留人工切换,不要把一次试用结果写成永久规则。
这套流程的价值在于把“定位”落成可追踪的团队记录:输入是什么、选了哪个模型、在哪个 Copilot surface 操作、结果花了多少人工修正。官方公告负责告诉你应该从哪里开始,是否采用仍然要由自己的代码库和成本边界决定。
常见误读
MAI Code 2 一定比 Flash 生成结果更好吗?
公告只给出任务定位,没有承诺所有语言、仓库和提示下的绝对质量排序。更稳妥的做法是按任务类型建立小样本记录。
Flash 的轻量定位是否代表不收费?
不是。公告明确写了两者按用量计费,轻量和成本效率是定位描述,不能替代账号实际看到的计费规则。
看到公告后,企业成员就能直接选择吗?
不一定。企业管理员可以通过模型策略管理访问;客户端、年度订阅资格和组织设置都可能影响模型是否出现在选择器中。
小结
MAI Code 2 和 MAI Code 2 Flash 的区别,首先是任务定位而不是宣传式的高低排名:前者面向复杂工程和仓库级推理,后者面向解释、局部修改、常规修复和快速迭代。接入时再沿着客户端、订阅资格、企业模型策略和按用量计费逐层确认。只有把公告事实与团队自己的任务记录分开,才能得到可复用的模型选择规则。
 Go debug/elf.VersionIndex.Index 怎样取得不含标记位的符号版本索引