
Copilot Fusion 扩展可用范围后,怎样按入口核对模型支持
GitHub 在 2026 年 11 月 17 日更新了 Copilot Fusion:公告提到最新版本的 github.com、Visual Studio,以及 iOS 和 Android 的 GitHub Mobile beta 可以选择 Copilot Fusion,生产版 GitHub Mobile 仍是后续安排。真正核对时,不能只看“入口已开放”这句话,还要对照当前入口和官方模型支持矩阵。
官方地址:https://docs.github.com/en/copilot/concepts/models/copilot-fusion
最稳妥的判断顺序是:先确认入口是否出现 Fusion,再确认该入口对应的模型表,最后检查 Copilot 计划和组织策略。Fusion 是运行时路由器,不等于一个固定模型。
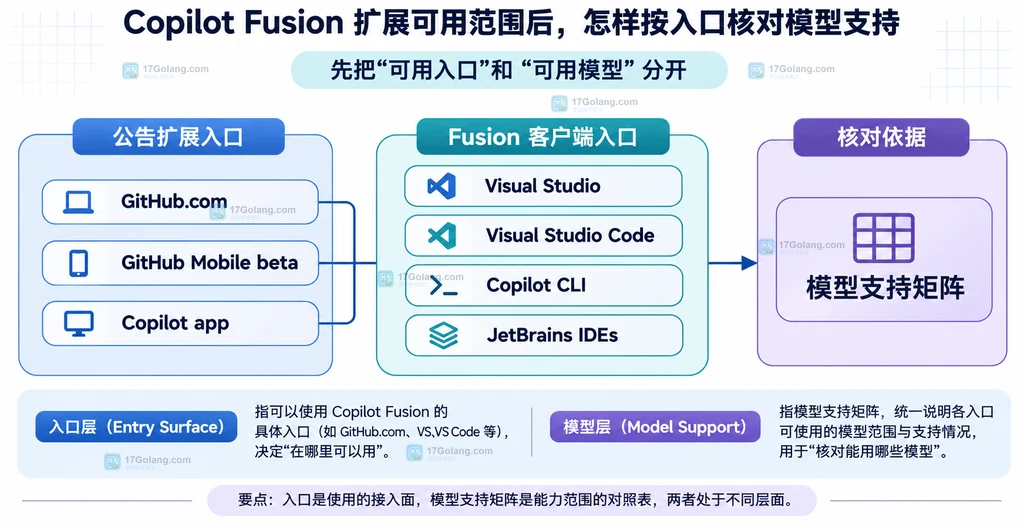
先把“可用入口”和“可用模型”分开
这次公告带来的是入口扩展、公开基准信息和模型池变化三件事。Copilot Fusion 的本质仍是运行时模型路由与编排:用户选择的是 Fusion 和 effort level,系统再为任务选择执行模式、推理强度以及参与的模型。
因此,“我能在某个地方看到 Fusion”与“我能在这个地方使用某个具体模型”是两项不同结论。官方文档把 Copilot Fusion 的一般可用入口列为 Visual Studio Code、Copilot CLI、GitHub Copilot app 和 JetBrains IDEs;公告则额外说明最新 github.com、Visual Studio 和 GitHub Mobile beta 的扩展范围。两份信息应当并列看,不要用其中一项替代另一项。
按入口核对:先看“有没有”,再看“能用什么”
可以把核对分成三列:入口名称、官方页面是否列出该入口、当前模型选择器是否实际出现 Fusion。以本轮公告为例,可按下面的顺序记录:
| 入口 | 公告信息 | 核对重点 |
|---|---|---|
| github.com | 最新版本扩展到该入口 | 看当前页面的模型选择器和账号计划 |
| Visual Studio | 最新版本扩展到该入口 | 确认客户端版本、模型选择器和组织策略 |
| GitHub Mobile beta | iOS/Android beta 支持;生产版稍后 | 不要把 beta 状态当成生产版全面可用 |
| VS Code、Copilot CLI、Copilot app、JetBrains | 官方 Fusion 文档列为一般可用入口 | 再查该客户端的模型支持表和版本说明 |
如果入口本身没有 Fusion,先不要分析模型名字;如果入口有 Fusion,但某个模型没有出现,再进入计划、模型政策和合规限制的检查。这个顺序能避免把“模型不在列表”误判成客户端故障。
再看模型池:Fusion Standard、High、Max 不是模型名称
官方模型支持页把 Auto model selection 和 Copilot Fusion 的支持模型单独列出,并按 Copilot cloud agent、Copilot Chat、Copilot CLI、GitHub Copilot app 等入口分栏。当前页面列出的示例包括 GPT-6 Astra、GPT-6 Luna、GPT-6 Sol、Claude Opus 5.5、Claude Sonnet 5.5、Gemini 3.8 Flash、MAI Code 2 Flash 等,但这份名单会随时间变化。
同时,Fusion Standard、Fusion High 和 Fusion Max 表示不同的质量、成本、延迟取舍,不是三个固定模型。Standard 偏日常任务,High 适合范围明确但更复杂的改动,Max 面向需要更深分析的任务。Fusion Fast 不是用户可选的普通档位,官方文档说明它只在 VS Code inline chat 的特定场景中使用。
所以当同一篇公告提到新模型加入不同 Fusion 档位时,正确读法是“这些档位的候选池发生变化”,而不是“用户可以在所有入口直接点选这些模型”。Copilot app 的文档还说明,开启 Fusion 后可以选择 effort level;如果要点选具体模型,需要关闭 Fusion 开关。
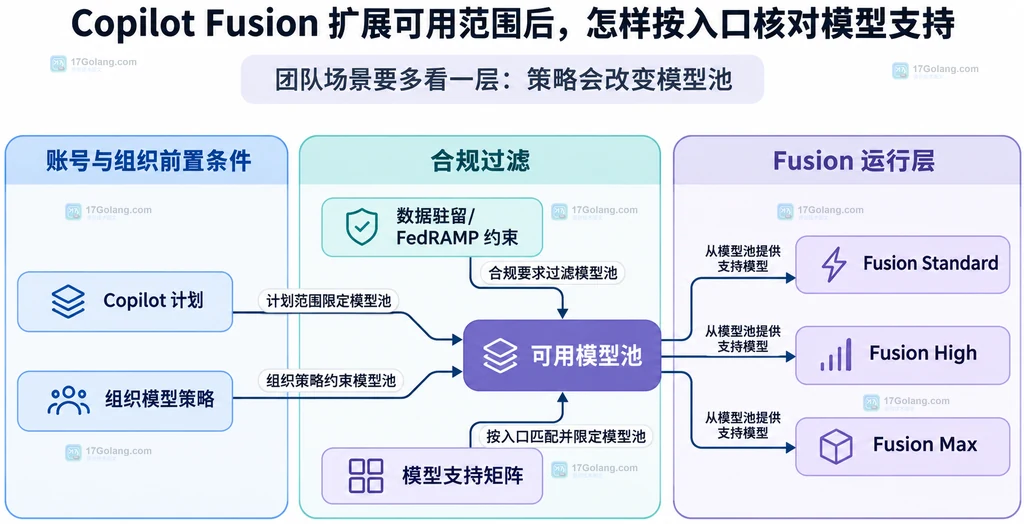
团队场景要多看一层:策略会改变模型池
个人账号看到的列表,不能直接代表团队成员看到的列表。GitHub 文档明确说明,Fusion 会从可用模型中选择,但可用范围受 Copilot 计划、组织或企业模型政策、数据驻留或 FedRAMP 限制,以及评估模型政策影响。
企业管理员应在 AI controls → Copilot → Models → Configure Copilot Fusion models 中检查 Fusion 模型配置;如果使用组织或企业团队委派,还要确认成员所属组织或团队是否获得对应模型。企业策略中“Enabled”“Disabled”和“Delegate”含义不同:启用只是把模型纳入允许范围,不能替代用户计划和其他模型政策的最终判断。
如果 Fusion Max 没有出现在选择器里,官方给出的直接线索是:它所需的一个或多个模型可能被禁用。此时应该回到模型政策和支持矩阵查原因,而不是反复更新客户端。
公告里的基准结果应该怎样理解
这次公告还把 Copilot Fusion Max 列入 Terminal-Bench 4.1 的公开排行榜,并给出了 71.2% 的 resolution rate 以及相对其他模型的成本比较。这属于 GitHub 公布的基准结果,适合用来了解公告的背景,但不能替代你自己的入口、计划、策略和任务核对。
尤其是团队准备接入时,先回答“成员能否看到 Fusion”“能否看到所需档位”“模型政策是否允许”“费用和上下文选项是否符合预期”,再讨论性能是否值得采用。基准结果不等于某个仓库、语言或团队任务的承诺。
一张可重复的入口核对清单
- 记录入口:github.com、Visual Studio、GitHub Mobile beta,或 VS Code、CLI、Copilot app、JetBrains。
- 记录状态:公告描述、官方 Fusion 文档描述、当前客户端选择器的实际显示分开记录。
- 查模型表:优先看“Supported AI models for Auto model selection and Copilot Fusion”对应入口列,不只看总模型名单。
- 查账号与策略:确认 Copilot 计划、组织/企业模型政策、数据驻留或 FedRAMP 约束。
- 查档位:确认 Standard、High、Max 是否出现,并把它们当作路由档位而不是固定模型。
- 最后再做小范围任务试用,观察响应下方的模型信息;这一步只用于体验,不把一次结果扩大成普遍结论。
这样核对的好处是,公告提供“发生了什么”,支持矩阵回答“哪个入口支持什么”,策略页面解释“为什么你的账号不同”。三者合并后,才是对 Copilot Fusion 支持范围的可靠判断。
常见问题
为什么官方总模型表里有某个模型,Fusion 里却看不到?
总模型表和 Fusion 专用支持表不是同一张表;还要叠加入口、计划和组织政策。先查 Fusion 专用矩阵,再查策略。
看到 Fusion 就代表能使用 Fusion Max 吗?
不代表。Max 需要它依赖的模型仍在可用池中;任一必要模型被计划或管理员策略排除,Max 可能不显示。
为什么同一个任务里会出现多个模型?
Fusion 会按任务选择执行模式,High 和 Max 可能包含额外的审查或协作调用。最终界面通常展示主代理模型,不能把它当成完整的内部调用清单。
参考资料
https://github.blog/changelog/2026-11-17-github-copilot-fusion-updates-more-availability-benchmarks-and-models
https://docs.github.com/en/copilot/reference/ai-models/supported-models
https://docs.github.com/en/copilot/how-tos/administer-copilot/manage-for-enterprise/manage-availability-of-default-models
 JavaScript Range.isPointInRange 怎样判断指定节点偏移是否落在范围内
- 上一篇
- JavaScript Range.isPointInRange 怎样判断指定节点偏移是否落在范围内
- 下一篇
- Go go/constant.Float32Val 怎样判断常量能否精确表示为 float32
-
- 科技周边 · 业界新闻 | 10小时前 |
- Meta Argo CD 与 Kargo 分离 AI 集群应用交付和基础设施发布
- 423浏览 收藏
-
- 科技周边 · 业界新闻 | 10小时前 |
- Kubernetes 1.37 弃用 IPVS 后怎样规划迁移
- 124浏览 收藏
-
- 科技周边 · 业界新闻 | 10小时前 | 云原生 · kubernetes · Kubernetes CNCF Workload Conformance
- Kubernetes 工作负载一致性小组要解决什么问题
- 238浏览 收藏
-
- 科技周边 · 业界新闻 | 10小时前 | 云原生 · CNCF Community Awards 云原生社区
- CNCF 2026 社区奖项怎样呈现云原生贡献类型
- 111浏览 收藏
-
- 科技周边 · 业界新闻 | 10小时前 |
- Open Cluster Management 的 hub-and-spoke 架构怎样支撑多集群管理
- 103浏览 收藏
-
- 科技周边 · 业界新闻 | 10小时前 | 云原生 · tab CNCF User Groups
- CNCF 推出 User Groups,终端用户协作怎样获得长期组织支持
- 473浏览 收藏
-
- 科技周边 · 业界新闻 | 10小时前 |
- KubeRay 捐赠 CNCF 后,Ray 集群编排的治理归属如何变化
- 165浏览 收藏
-
- 科技周边 · 业界新闻 | 10小时前 |
- kpt 1.0 发布后配置包管理与 Porch 的分工是什么
- 158浏览 收藏
-
- 科技周边 · 业界新闻 | 11小时前 | gitHub actions · 业界新闻 · 持续集成 · 预装软件 CI环境 GitHub Actions runner images Included Software
- GitHub Actions runner images 怎样查看预装软件变化
- 151浏览 收藏
-
- 科技周边 · 业界新闻 | 11小时前 | 云原生 · postgresql · kubernetes · PostgreSQL 高可用 Kubernetes Operator CNCF CloudNativePG
- CNCF CloudNativePG 晋级孵化项目后 PostgreSQL 高可用运维关注什么
- 175浏览 收藏
-
- 科技周边 · 业界新闻 | 11小时前 |
- GitHub Actions workflow lockfiles 正式可用后怎样固定 Action 依赖
- 218浏览 收藏
-
- 科技周边 · 业界新闻 | 11小时前 | 云原生 · Kubernetes AI推理 KubeCon 2026
- KubeCon 2026 的 AI 推理议题反映了哪些工程变化
- 281浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1093次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1089次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1254次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1197次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1042次使用
-
- 聊聊Go语言编译github上的项目遇到的坑
- 2022-12-31 455浏览
-
- node.js学习笔记之koa框架和简单爬虫练习
- 2023-01-10 124浏览
-
- 在连接云服务器的TDengine时,一定要注意这个细微的操作
- 2023-02-25 311浏览
-
- 爬虫系列:使用 MySQL 存储数据
- 2023-01-13 462浏览
-
- 这款简洁的开源客户关系管理系统,真是好东西
- 2023-01-24 485浏览


