CNCF 在 2026 年 11 月 10 日发布的公告,传递的重点不是又出现了一个“AI 平台”,而是云原生生态正在把模型训练、分布式推理和智能体运行时放进同一套生产基础设施语境。公告称 CNCF 项目总数达到 231 个,全球云原生开发者达到 2120 万,过去一年相关活动吸引了 82000 名参与者。
因此,“进入生产阶段”更准确的理解是:生态开始补齐 AI 工作负载在生产环境中的隔离、调度、推理扩展和策略治理。它不表示公告中每个项目都已经成熟到可以直接替换现有平台。团队真正要做的,是把公告中的能力线拆开,再用自己的工作负载逐项试点。
官方地址:https://www.cncf.io/projects/
公告原文:https://www.cncf.io/announcements/2026/11/10/cncf-hits-major-milestones-with-global-community-growth-record-industry-investment-and-a-new-generation-of-projects-to-build-ai-systems-in-production/
公告基线:这次变化看的是组合,不是单点产品
从公告指标看,CNCF 今年新增或推进的内容已经覆盖了多个层次:32 个项目扩展了技术组合,Agent Substrate、llm-d 和 OpenShell 被放在 AI 基础设施的新增动向中;8 家企业加入 Platinum 会员;欧洲 KubeCon + CloudNativeCon 的参会人数接近 13500 人。官方还提到,社区新增了 40 个云原生案例和 12 个参考架构。
这些数字是生态规模信号,不是任何一个项目的吞吐、延迟或成本基准。读者在阅读新闻时,应该把“社区投入变大”和“某个项目适合自己的生产负载”分成两个问题。前者说明值得关注,后者必须回到项目边界、运维能力和回滚条件。
| 公告信号 | 可以怎样理解 | 不能直接推出的结论 |
|---|---|---|
| 项目总数达到 231 个 | 云原生基础设施的可组合范围扩大 | 所有项目都已经生产就绪 |
| llm-d 达到 1.0 | 分布式大模型推理有更明确的版本节点 | 每种模型和硬件组合都能直接采用 |
| Kubeflow graduated | 模型数据处理、训练、微调和服务生态成熟度提升 | 部署后无需补充监控、权限和成本治理 |
| Agent Substrate、OpenShell 进入 Sandbox | 智能体隔离和运行时治理成为公开协作方向 | Sandbox 等同于企业生产认证 |
训练、推理和智能体开始形成一条能力链
公告中的项目可以按工作负载拆成三条线。训练侧,Kubeflow 覆盖数据处理、模型训练、微调和服务等生命周期环节,KubeRay 则把 Ray 工作负载带到 Kubernetes 上,适合需要分布式计算的训练和推理场景。OpenRL 进一步把强化学习所需的计算协调放进 Kubernetes 原生编排语境。
推理侧,llm-d 加入 CNCF 并达到 1.0,代表大语言模型的分布式推理和扩展开始有更明确的开放协作入口。它解决的是推理服务怎样拆分、扩展和协同的问题,仍然需要结合模型大小、批处理策略、加速器类型和流量形态做实测。
智能体侧,Agent Substrate 强调在 Kubernetes 上隔离不受信任代码,OpenShell 则围绕智能体可访问的文件、网络、凭据和模型端点提供策略治理。两者的共同点不是“让 Agent 更聪明”,而是让 Agent 的执行边界更容易被平台团队看见和控制。
项目成熟度要和生产承诺分开看
CNCF 的项目阶段提供了观察生态的统一语言,但它们回答的问题不同。Sandbox 通常表示项目处于早期协作和验证阶段;Incubating 说明项目已经有一定使用和贡献基础,但仍在继续建立成熟度;Graduated 则代表更完整的治理、社区和技术成熟度信号。版本达到 1.0 也只是某个项目的版本节点,不会自动替团队完成兼容性、可观测性和安全评估。
这也是这次公告最容易被误读的地方:Kubeflow graduated、llm-d 1.0、HAMi 进入 incubation,与 Agent Substrate 和 OpenShell 进入 Sandbox,不能放到同一个“可直接上线”标签下。正确做法是记录项目阶段、目标工作负载、依赖的 Kubernetes 和硬件版本,以及失败后的撤回路径。
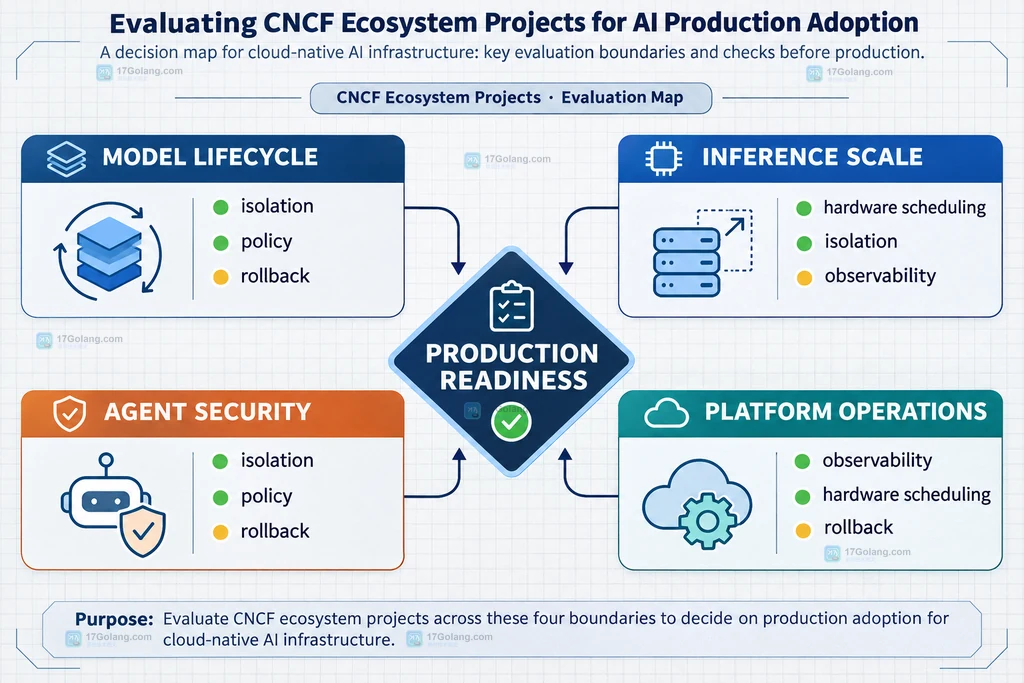
从新闻信号到生产试点,先核对五个条件
如果团队准备跟进这批项目,可以先用一张小型评估表,而不是一次性搭建完整 AI 平台。
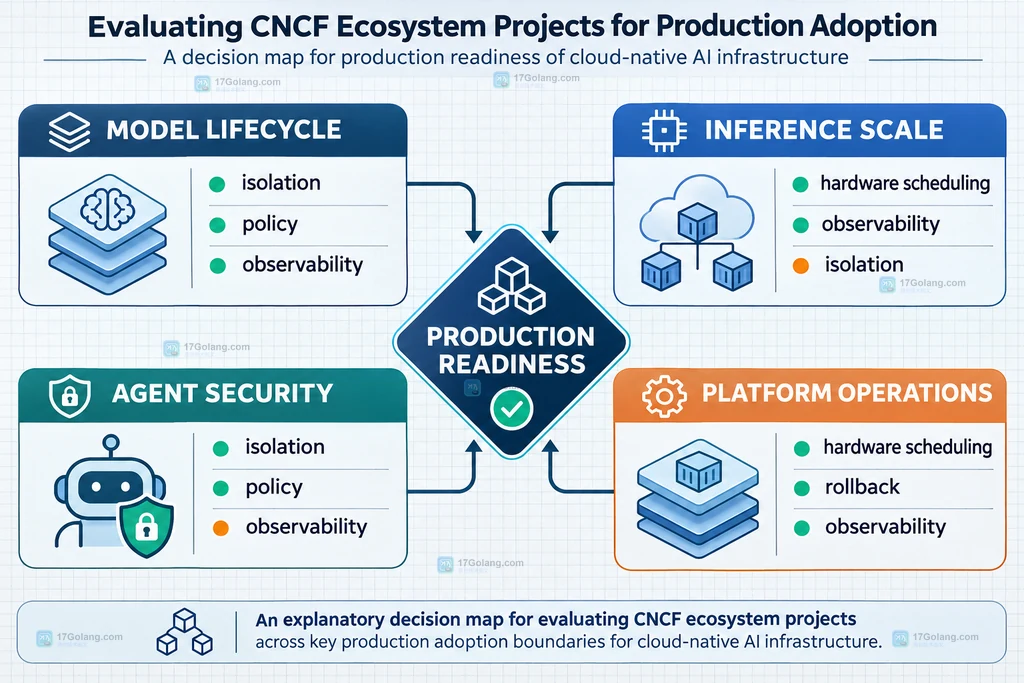
- 隔离:确认训练任务、推理服务和 Agent 执行是否能使用不同的命名空间、节点池或运行时边界;尤其要明确不受信任代码不能默认触达宿主机。
- 策略:把文件、网络、凭据和模型端点分别列出,写清允许访问的范围。智能体能调用什么,比它能生成什么更需要先定规则。
- 可观测性:至少记录模型、工作负载、请求和资源消耗的关联关系,避免出现“服务可用但无法解释成本和延迟”的结果。
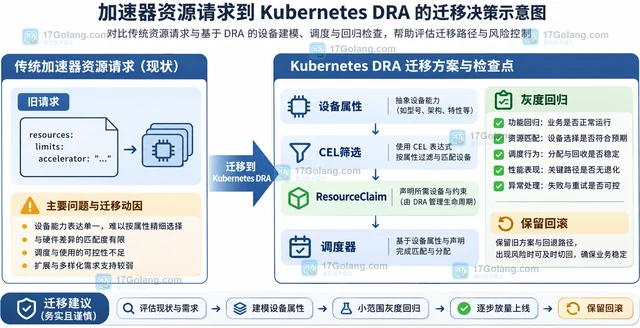
- 硬件调度:明确 GPU 或其他加速器的分配、共享与回收方式,先验证单一硬件类型,再扩展到异构集群。
- 回滚:为 CRD、运行时策略和推理路由保留可逆变更;试点出现权限放大、延迟抖动或资源争用时,能够退回原有服务路径。
低风险采用路径:先选择一个边界清楚的负载
第一步可以选一个已有回归集的推理服务,先对比现有方案与新组件在延迟分布、资源占用、失败重试和发布回退上的差异。这样做的好处是结果可量化,且不必同时改变训练、推理和 Agent 三个系统。
第二步再把一个需要分布式计算的训练任务或离线推理任务迁到目标集群,观察调度、数据访问和失败恢复。对于 Agent 场景,应先从无敏感凭据、只读数据和受限网络的任务开始,把 OpenShell 或 Agent Substrate 的策略能力放在边界验证上,而不是直接承载高权限自动化。
第三步才考虑组合多个项目。组合时把每个项目的责任写进平台文档,例如谁负责训练编排、谁负责推理路由、谁负责运行时隔离、谁负责凭据策略。只要责任边界说不清,项目数量越多,排障成本越高。
结论:AI 基础设施的生产化正在从单点能力转向组合治理
CNCF 这次公告的实际价值,在于它把训练、推理和智能体运行时放到同一张云原生基础设施地图上。llm-d、Kubeflow、KubeRay、OpenRL、Agent Substrate 和 OpenShell 分别补上不同的能力缺口,但成熟度、硬件依赖和运维责任并不相同。
对工程团队来说,最稳妥的行动是先记录项目阶段,再用隔离、策略、可观测性、硬件调度和回滚五项条件做小范围试点。能被单独测量、能撤回、能解释的试点,才是从生态新闻走向生产基础设施的可靠起点。
常见问题
CNCF 宣布的这些项目是不是都已经可以直接用于生产?
不是。公告同时包含 Sandbox、Incubating、Graduated 和 1.0 等不同信号,团队仍需结合自己的模型、硬件、权限和运维能力评估。
llm-d 达到 1.0 代表什么?
它提供了一个更明确的版本节点,说明项目在分布式大模型推理方向形成了相对清晰的交付形态;具体兼容性和性能仍要用目标模型与硬件测试。
为什么 Agent 基础设施要先做权限和隔离?
Agent 的风险不只来自模型输出,也来自它实际能访问的文件、网络、凭据和模型端点。先限定执行边界,才能在自动化能力扩大后保持可审计和可撤回。
团队应该从哪个项目开始试点?
应从最贴近现有问题且边界清楚的单一负载开始:已有推理服务可优先观察推理扩展,分布式训练团队可先看训练编排,Agent 团队则从低权限、只读和无敏感凭据的任务开始。
 GPT-Live双工语音会话接入后端