
Python sqlite3 怎样限制单条语句的参数编号
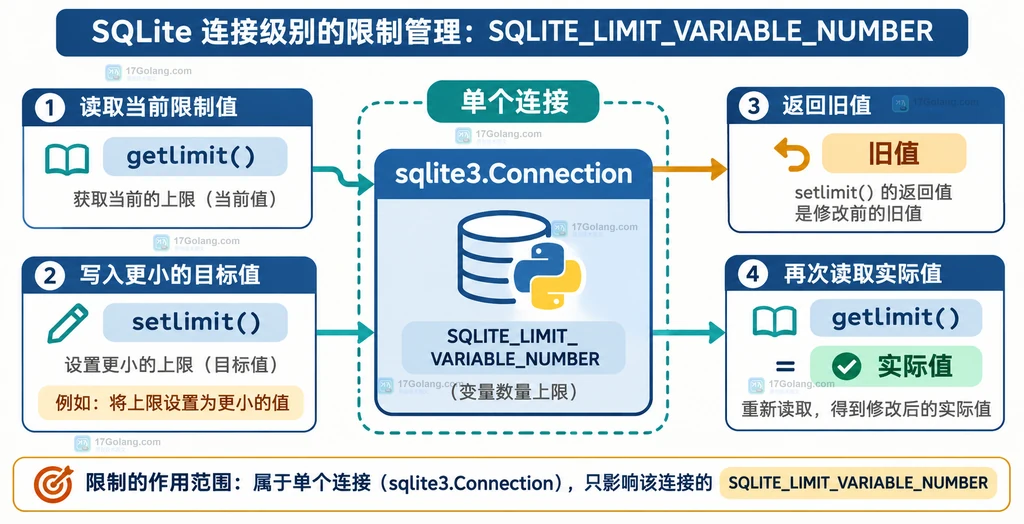
Python 的 sqlite3 可以在单个数据库连接上限制 SQL 参数的最大编号。做法是先用 Connection.getlimit() 读取当前值,再调用 Connection.setlimit(sqlite3.SQLITE_LIMIT_VARIABLE_NUMBER, limit) 设置更低的上限。这里限制的是 SQLite 看到的最大参数编号,不是简单统计问号数量,也不是 SQL 文本长度。
官方地址:https://docs.python.org/3/library/sqlite3.html
这个设置适合给由外部输入影响的 SQL 构造增加连接级边界,也适合让批量参数生成器尽早暴露异常。它不会自动把超长参数列表拆成多条语句,批量拆分仍然要由应用代码负责。
先分清参数数量和参数编号
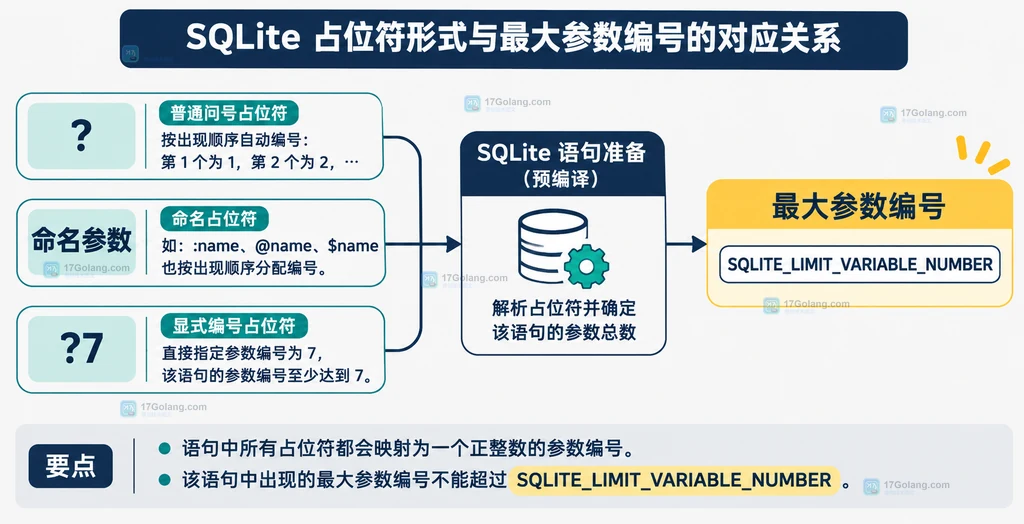
SQLite 支持普通问号参数、命名参数和带显式编号的参数。普通的 ? 通常按出现顺序获得编号;?7 则直接使用编号 7。命名参数也会被 SQLite 映射到参数编号,因此最终要检查的是一条语句占用的最大编号。
import sqlite3

# 三种写法都属于占位参数,但编号来源不同。
sql = "SELECT ? AS first_value, ?7 AS seventh_value, :name AS named_value"

with sqlite3.connect(":memory:") as connection:
    # 这里的参数编号由 SQLite 在准备语句时分配,不要把问号个数当成上限。
    print(connection.execute("SELECT ?", ("普通参数",)).fetchone())
    print(sql)
    # 命名参数使用字典绑定,避免把业务值拼接进 SQL 文本。
    connection.execute("SELECT :name", {"name": "示例"})
最容易误判的情况是 ?7 只写了一个占位符,却要求 SQLite 按 1 到 7 的范围管理参数槽位。编号越大,消耗的参数槽位越多;因此“只出现一个问号”不代表资源成本只有一个参数。
用 getlimit 读取当前连接的上限
SQLITE_LIMIT_VARIABLE_NUMBER 是 SQLite 的限制类别常量。Python 连接对象提供 getlimit(),可以读取这个连接当前允许的最大参数编号。限制属于连接对象本身,不能把一个连接上的读取结果当成所有连接的全局配置。
import sqlite3

with sqlite3.connect(":memory:") as connection:
    # 读取本连接的参数编号上限,便于日志记录和策略判断。
    current_limit = connection.getlimit(sqlite3.SQLITE_LIMIT_VARIABLE_NUMBER)
    print(f"当前最大参数编号:{current_limit}")

    # 负数表示不修改,只查询当前值;返回值仍是当前限制。
    unchanged = connection.setlimit(sqlite3.SQLITE_LIMIT_VARIABLE_NUMBER, -1)
    print(f"未修改时返回:{unchanged}")
如果底层 SQLite 不认识传入的限制类别,Python 会抛出 ProgrammingError。读取动作放在连接初始化阶段,能让后续的 SQL 构造逻辑使用一个明确的边界,而不是把默认值写死在业务代码里。
用 setlimit 降低单条语句的参数编号
setlimit() 的第二个参数是新的限制值。它返回修改前的值;如果尝试设置的值高于底层硬上限,SQLite 会把它截断到硬上限,所以需要记录返回值或再次读取,避免把“请求值”误当成“生效值”。
import sqlite3

def configure_sqlite_limits(connection: sqlite3.Connection, maximum: int) -> int:
    # 只允许设置正整数,避免把配置错误带到 SQL 执行阶段。
    if maximum  {actual}")
    return actual


with sqlite3.connect(":memory:") as connection:
    # 例如把这个连接的最大参数编号收窄到 100。
    configure_sqlite_limits(connection, 100)
这里的“收窄”只对当前 connection 有效。新建另一个连接时,应在它自己的初始化流程中再次设置;连接关闭后,设置也不会持久化到数据库文件。
编号跳跃时怎样处理异常边界
当 SQL 生成器使用显式编号时,应把最大编号控制在连接限制以内。不要仅用占位符个数判断安全边界,因为 ?1000 即使只出现一次,也会把最大编号推到 1000。若语句准备或执行阶段超过限制,应用应捕获数据库异常并记录“生成的最大编号”和批次大小,而不是盲目重试同一条 SQL。
import sqlite3

def execute_numbered_query(connection: sqlite3.Connection, values: list[str]):
    # 用连续编号生成占位符,最大编号与 values 数量保持一致。
    placeholders = ", ".join(f"?{index}" for index in range(1, len(values) + 1))
    sql = f"SELECT value FROM items WHERE id IN ({placeholders})"

    try:
        # 参数数量和最大编号同步,避免出现 ?1000 这类稀疏编号。
        return connection.execute(sql, values).fetchall()
    except sqlite3.Error as error:
        # 记录边界信息,交给调用方拆分批次或调整连接策略。
        raise RuntimeError(
            f"SQL 参数编号超出当前连接边界,最大编号={len(values)}"
        ) from error
真实项目中也可以直接使用连续的 ?,让驱动按出现顺序分配编号。无论选择哪种写法,批量查询都应在应用层设置每批大小,并让批大小小于连接的最大参数编号,而不是把限制当成自动分批器。
这个限制和哪些问题不是一回事
| 问题 | 应关注的对象 | 是否由 setlimit 直接解决 |
|---|---|---|
| 显式参数编号过大 | SQLITE_LIMIT_VARIABLE_NUMBER | 可以,按连接降低上限 |
| 一批数据太多 | 应用层批次大小与循环 | 不能,仍需拆分语句 |
| SQL 字符串太长 | SQLITE_LIMIT_SQL_LENGTH | 不是同一个限制类别 |
| 参数值本身太大 | 值大小、行大小和绑定策略 | 不能直接替代数据校验 |
尤其不要为了处理参数编号问题而拼接 SQL 字符串。占位符仍然应该配合参数绑定使用;要降低资源风险,优先收窄连接限制、控制批次大小,并在异常信息中保留生成器的边界数据。
常见问题
setlimit 设置的是整个数据库文件的限制吗?
不是。它设置的是当前 Connection 的运行时限制,同一个数据库文件被不同连接打开时,需要分别配置。
为什么一个 ?1000 会比很多个普通问号更容易触发限制?
因为 SQLite 会为从 1 到最大编号之间的参数槽位准备空间。显式编号跳跃会把最大编号直接推高,即使语句里肉眼看到的占位符数量不多。
把 limit 设置得更大,就能支持任意长度的批量查询吗?
不能。底层硬上限、内存消耗、SQL 文本长度和数据库执行成本仍然存在。批量查询应优先按业务规模分批,并根据实际连接能力设置合理上限。
小结:Python sqlite3 限制单条语句的参数编号,核心是对连接调用 setlimit(sqlite3.SQLITE_LIMIT_VARIABLE_NUMBER, limit),再用 getlimit() 读取实际值。判断边界时关注最大参数编号而不是问号个数;避免稀疏的 ?NNN,批量数据由应用拆分,SQL 文本长度和参数值大小则分别处理。
 MySQL JSON_LENGTH 怎样分别统计对象成员和数组元素
- 上一篇
- MySQL JSON_LENGTH 怎样分别统计对象成员和数组元素
- 下一篇
- Go sql.DB.SetMaxIdleConns 怎么控制连接池中的空闲连接
-
- 文章 · python教程 | 2小时前 | 并发编程 · Python教程 · Python multiprocessing Pool initializer spawn initargs 多进程配置
- Python multiprocessing spawn 传递初始化配置的方案
- 295浏览 收藏
-
- 文章 · python教程 | 2小时前 | 文件处理 · 标准库 · csv · python · 数据导入 · Python csv DictReader DictWriter 空行 newline lineterminator
- Python csv newline 参数避免空行的文件处理
- 365浏览 收藏
-
- 文章 · python教程 | 2小时前 |
- Python itertools.batched 分批消费迭代器的边界
- 408浏览 收藏
-
- 文章 · python教程 | 3小时前 |
- Python 正则原子组避免回溯放大的写法
- 267浏览 收藏
-
- 文章 · python教程 | 3小时前 | 标准库 · python · Python map sorted 对象属性 operator.attrgetter itemgetter
- Python operator.attrgetter 怎样批量读取对象属性
- 305浏览 收藏
-
- 文章 · python教程 | 3小时前 | python · 异步编程 · Python asyncio timeout CancelledError TimeoutError
- Python asyncio.timeout 区分超时与主动取消的边界
- 172浏览 收藏
-
- 文章 · python教程 | 3小时前 | python · 异步编程 · Python asyncio CancelledError TaskGroup ExceptionGroup
- Python asyncio.TaskGroup 取消兄弟任务的处理方式
- 289浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1015次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1019次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1145次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1120次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 961次使用
-
- Go问答:database/sql.NamedSQL 命名参数为什么没有生效为什么结果为空或不符合预期
- 2026-11-09 151浏览
-
- Go问答:database/sql.NamedSQL 命名参数为什么没有生效怎样在批处理代码中减少额外分配
- 2026-11-09 351浏览
-
- Navicat for SQLite导入csv中文数据的方法
- 2022-12-29 378浏览
-
- SQL 编程思想:一切皆关系
- 2023-02-18 315浏览
-
- 支持国产化!HFish全面兼容国产CPU
- 2023-01-25 305浏览


