
Python operator.attrgetter 怎样批量读取对象属性
在处理一组对象时,如果排序、字段投影和分组都反复写 lambda item: item.name,属性读取逻辑很快会散落在多处。Python 的 operator.attrgetter 可以把属性路径预先做成一个可调用对象,再交给 sorted()、map() 或其他接收函数参数的工具。
直接结论:单个属性用 attrgetter("name") 返回标量;多个属性用 attrgetter("name", "score") 返回按声明顺序排列的元组;点号路径如 attrgetter("customer.profile.display_name") 会逐层取属性,中间任一层不存在就会抛出 AttributeError。
官方地址:https://docs.python.org/3/library/operator.html#operator.attrgetter
先把重复的 lambda 收拢成一个访问器
attrgetter 返回的不是读取结果,而是一个可以反复调用的函数对象。把它保存到变量后,既可以直接调用,也可以作为排序键或映射函数传入。
from dataclasses import dataclass
from operator import attrgetter

@dataclass
class Student:
    name: str
    score: int

students = [
    Student("林一", 86),
    Student("周宁", 93),
    Student("陈默", 78),
]

# 先创建可复用的属性访问器,避免每个调用点重复写 lambda。
get_name = attrgetter("name")

# sorted 会把每个 Student 交给 get_name,并按返回的字符串排序。
by_name = sorted(students, key=get_name)

# map 复用同一个访问器,得到名字序列;这里显式转 list 便于后续使用。
names = list(map(get_name, students))

# 访问器本身仍可直接调用,参数必须是拥有 name 属性的对象。
first_name = get_name(students[0])
这里的关键是“把字段读取当作函数传递”。sorted 负责遍历对象,get_name 只负责返回排序键,二者职责清晰。若只是一次性的简单排序,lambda 仍然足够;当同一字段要被排序、投影和分组多次使用时,attrgetter 更容易集中管理。
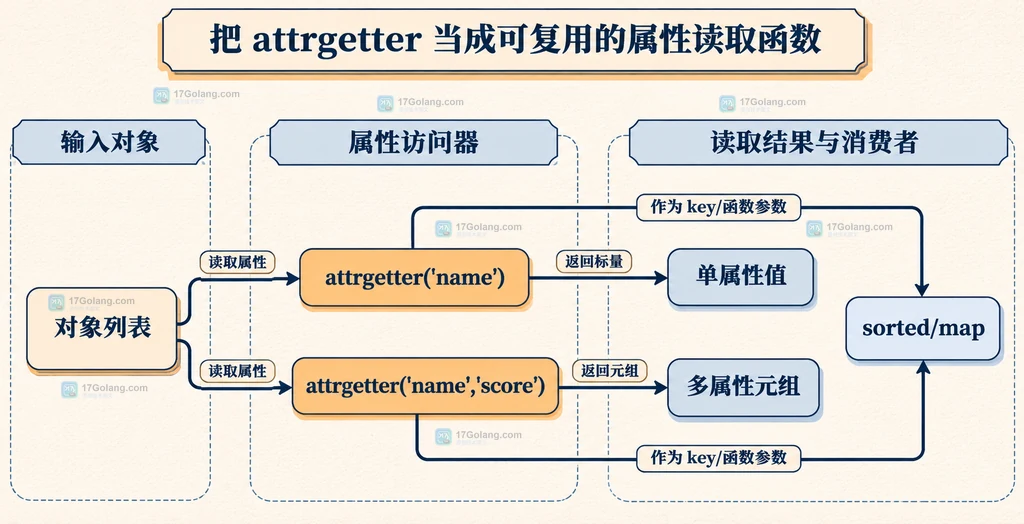
单属性和多属性的返回形状不同
单属性访问器返回该属性的原值,多属性访问器返回元组。这个差异会影响解包、排序键和后续的类型判断,不能只把两种写法当成参数数量不同。
from operator import attrgetter

# 单属性:返回一个字符串,不会自动包装成一元组。
get_name = attrgetter("name")
name = get_name(Student("林一", 86))

# 多属性:返回元组,元组顺序与 attrgetter 的参数顺序一致。
get_name_score = attrgetter("name", "score")
name_score = get_name_score(Student("林一", 86))
name_value, score_value = name_score

# 多字段元组也可以直接作为排序键,先按 name,再按 score。
ordered = sorted(students, key=attrgetter("name", "score"))
多属性返回元组后,Python 的元组比较会按位置进行比较。因此 sorted(..., key=attrgetter("name", "score")) 的含义是先比较姓名,姓名相同时再比较分数。若业务要求先按分数降序、再按姓名升序,建议把两个排序条件写成清楚的排序策略,不要误以为 attrgetter 能为每个字段单独配置方向。
点号路径适合读取嵌套对象
属性名可以包含点号,attrgetter 会按照点号切分后逐层访问。它适合对象结构稳定、字段链路明确的场景,例如从订单对象取客户展示名。
from dataclasses import dataclass
from operator import attrgetter

@dataclass
class Profile:
    display_name: str

@dataclass
class Customer:
    profile: Profile

@dataclass
class Order:
    order_id: str
    customer: Customer

orders = [
    Order("A-102", Customer(Profile("周宁"))),
    Order("A-101", Customer(Profile("林一"))),
]

# 点号路径表示连续的属性读取,不是字典键路径。
get_display_name = attrgetter("customer.profile.display_name")

# 同一个访问器可用于排序和字段投影。
orders_by_customer = sorted(orders, key=get_display_name)
customer_names = list(map(get_display_name, orders))
这里的 customer.profile.display_name 是对象属性链。如果 customer 为 None,或者某一层没有目标属性,访问就会在对应位置失败。attrgetter 不会把缺失属性自动转换成 None,也不会替业务决定默认值。
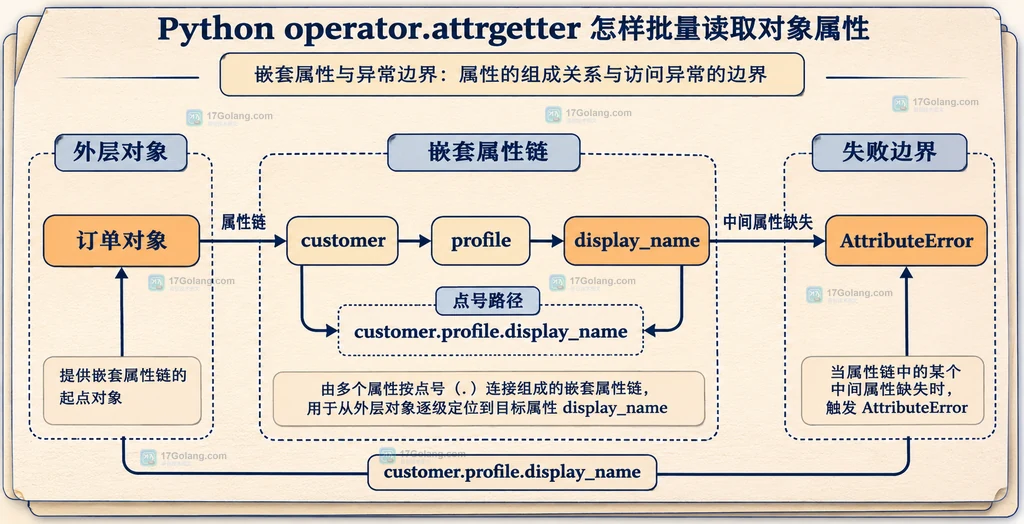
缺失属性时要决定是暴露异常还是先做清洗
如果数据契约要求每个对象都有完整属性,直接让 AttributeError 暴露出来通常更好,它能尽早发现脏数据或对象类型混入。若输入允许缺少字段,则应在进入 attrgetter 前完成归一化,或者使用带默认值的显式函数。
from operator import attrgetter

get_name = attrgetter("name")

def safe_name(item):
    # 只有业务明确允许缺失 name 时才提供默认值,避免吞掉结构错误。
    try:
        return get_name(item)
    except AttributeError:
        return "未命名"

# 先统一结果,再交给排序;这样排序逻辑不需要处理异常。
ordered = sorted(students, key=safe_name)
不要为了“让程序继续跑”而无条件捕获所有异常。AttributeError 可能来自嵌套链路中的任何一层,生产代码最好在输入边界记录对象类型和字段来源,再决定是拒绝数据、补齐字段还是使用默认值。
attrgetter、getattr 和 itemgetter 怎么选
| 工具 | 读取对象 | 适合场景 | 主要边界 |
|---|---|---|---|
attrgetter | 属性,如 item.name | 排序、映射、分组时复用字段访问器 | 缺失属性会抛 AttributeError |
getattr | 一次读取一个属性,可传默认值 | 属性名动态变化或需要按业务提供默认值 | 默认值和异常策略要由调用方设计 |
itemgetter | 下标或键,如 row["name"] | 字典、元组、列表和其他实现 __getitem__ 的对象 | 它读取下标/键,不是对象属性 |
一个简单判断方法是:数据字段写成 obj.name 就优先考虑 attrgetter,写成 obj["name"] 就考虑 itemgetter;属性名来自配置且需要默认值时,再使用显式的 getattr(obj, field, default)。
把这套写法放进实际工作流
- 先确认输入是对象属性还是字典/序列下标。
- 字段固定且会被多处消费时,创建一个命名清楚的
attrgetter。 - 单字段直接使用标量结果,多字段按声明顺序解包元组。
- 嵌套路径只用于结构稳定的对象,明确中途缺失时的异常策略。
- 将访问器交给
sorted、map或itertools.groupby前,先约定返回值形状。
掌握这几个边界后,operator.attrgetter 的价值不在于少写几个字符,而在于把“如何取字段”从排序、投影等业务动作中分离出来,让同一个字段访问规则可以被重复使用。
常见问题
attrgetter 可以读取字典键吗?
不能直接把字典键当成对象属性。字典场景应使用 operator.itemgetter("name"),或者用 getattr 处理真正的对象属性。
多个属性的返回值一定是元组吗?
传入两个或更多属性名时返回元组,顺序与参数顺序一致;只传一个属性名时返回该属性本身,而不是一元组。
如何给不存在的嵌套属性设置默认值?
attrgetter 没有默认值参数。可以在数据清洗阶段补齐对象,或写一个明确捕获 AttributeError 的包装函数,只对业务允许缺失的字段提供默认值。
 Python dataclasses.asdict 怎样把嵌套数据类转换为字典
- 上一篇
- Python dataclasses.asdict 怎样把嵌套数据类转换为字典
- 下一篇
- Python 正则原子组避免回溯放大的写法
-
- 文章 · python教程 | 45分钟前 | python · 异步编程 · Python asyncio timeout CancelledError TimeoutError
- Python asyncio.timeout 区分超时与主动取消的边界
- 172浏览 收藏
-
- 文章 · python教程 | 50分钟前 | python · 异步编程 · Python asyncio CancelledError TaskGroup ExceptionGroup
- Python asyncio.TaskGroup 取消兄弟任务的处理方式
- 289浏览 收藏
-
- 文章 · python教程 | 1天前 | 日志 · 标准库 · python · 工程实践 · Python logging request_id LogRecord setLogRecordFactory
- Python logging.setLogRecordFactory 怎样统一注入关联字段
- 306浏览 收藏
-
- 文章 · python教程 | 1天前 | python · 异步编程 · Python asyncio TaskGroup asyncio.create_task
- Python asyncio.create_task 怎样保存任务引用避免提前回收
- 296浏览 收藏
-
- 文章 · python教程 | 1天前 | 标准库 · 资源管理 · python · Python 上下文管理 contextlib nullcontext
- Python nullcontext 怎样统一可选上下文管理
- 385浏览 收藏
-
- 文章 · python教程 | 1天前 | python · 接口设计 · Python 静态类型检查 typing.Protocol 结构化接口
- Python Protocol 怎样表达结构化接口
- 113浏览 收藏
-
- 文章 · python教程 | 1天前 | 标准库 · 枚举 · Python教程 · Python unique flag enum.verify EnumCheck CONTINUOUS NAMED_FLAGS
- Python enum.verify 怎样在定义时检查枚举约束
- 323浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1014次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1019次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1143次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1119次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 960次使用
-
- GScript 编写标准库示例详解
- 2022-12-30 369浏览
-
- 关于Golang标准库flag的全面讲解
- 2023-02-25 344浏览
-
- Golang标准库unsafe源码解读
- 2022-12-29 464浏览
-
- 快速掌握Go语言HTTP标准库的实现方法
- 2022-12-30 327浏览
-
- 解析golang 标准库template的代码生成方法
- 2022-12-24 349浏览


