
Python itertools.batched 分批消费迭代器的边界
如果你要把一个可能很大的可迭代对象按固定数量交给下游处理,itertools.batched() 的关键不是“把列表切成几段”,而是按需读取输入并逐批返回元组。默认情况下,最后不足 n 个元素的尾批也会返回;只有明确要求每批完整时,才使用 strict=True。
官方文档:https://docs.python.org/3.15/library/itertools.html#itertools.batched
本文只讨论 Python 3.12+ 的 batched():输入是什么、结果何时产生、尾批如何处理,以及代码应该在哪个边界上做决定。
itertools.batched 到底返回什么
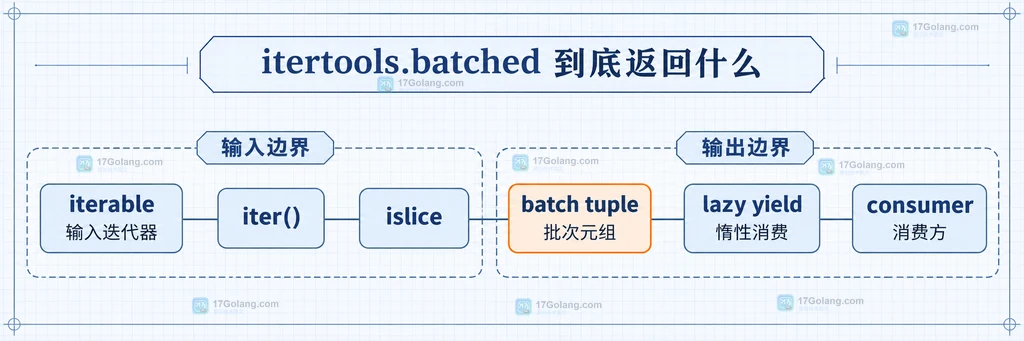
batched(iterable, n) 接受任何可迭代对象,返回一个批次迭代器;每次迭代得到的是一个 tuple,而不是自动生成的列表。它不会先把全部输入复制到内存里,而是消费到足够填满当前批次时就产生一个结果。
from itertools import batched

# 用生成器模拟持续到来的记录,避免先构造完整列表
records = (f"row-{number}" for number in range(1, 6))

# 每批最多取两个元素,结果仍然是可继续迭代的对象
for batch in batched(records, 2):
    # 下游可以在这里提交、写入或处理当前批次
    print(type(batch).__name__, batch)
这个例子里的批次形态是 ('row-1', 'row-2')、('row-3', 'row-4') 和 ('row-5',)。因此,批次大小是上限,不代表每个返回元组都一定有两个元素。
n、惰性消费与最后一批怎么判断
n 必须大于或等于 1。传入 0 或负数时,函数会抛出 ValueError;空输入则不会产生任何批次。由于读取是惰性的,调用 batched() 本身不会立刻消费全部数据,真正开始消费发生在遍历返回对象时。
from itertools import batched

def consume_in_batches(source, size):
    # 先让标准库处理 size 的合法性,再逐批处理输入
    for batch in batched(source, size):
        # 尾批可能短于 size,下游不要无条件访问固定下标
        if not batch:
            continue
        print(f"本批数量: {len(batch)}")

# 空输入没有输出;五个元素按 3 个一批时,最后一批只有两个
consume_in_batches([], 3)
consume_in_batches(range(1, 6), 3)
工程上不要把 batched() 的结果当成可重复遍历的序列:消费一次后,输入迭代器已经向前移动。若下游需要多次访问,应在明确可接受内存成本后,把单个批次保存下来,而不是重新遍历同一个批次迭代器。
strict=True 适合整批输入吗
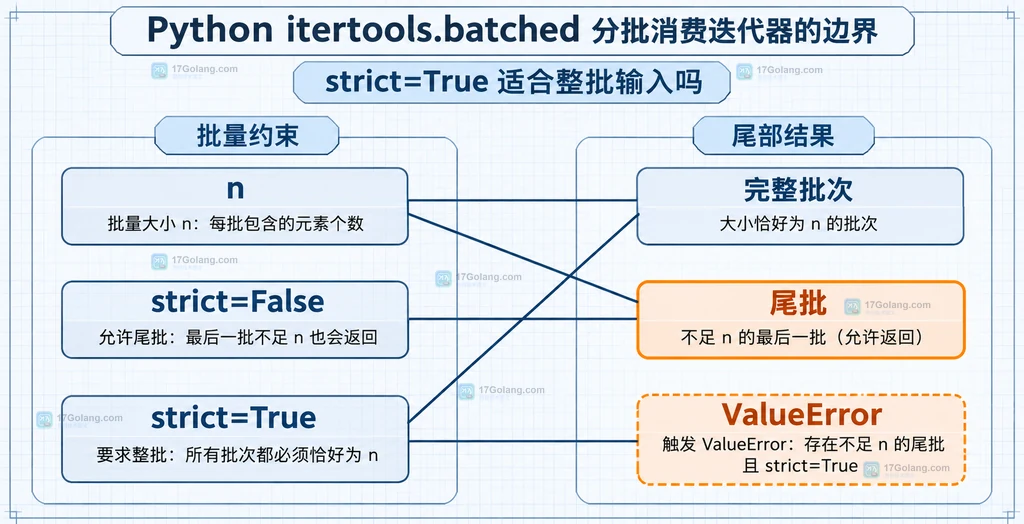
当业务要求“每次提交必须正好有 n 条”时,可以使用关键字参数 strict=True。完整批次会正常产生;一旦最后一批不足 n,就抛出 ValueError。这适合固定宽度文件、成组协议记录或必须成批提交的任务,不适合自然允许尾批的分页读取。
from itertools import batched

def full_batches(source, size):
    # strict=True 把不完整尾批变成显式错误,避免静默少处理
    for batch in batched(source, size, strict=True):
        # 只有完整批次才会到达这里
        yield batch

try:
    list(full_batches(range(5), 2))
except ValueError as exc:
    # 调用方可以记录输入数量不足,并决定补齐或回滚
    print(f"批次不完整: {exc}")
注意异常出现的位置:前面的完整批次可能已经被消费并交给下游,异常发生在发现不完整尾批时。因此,如果“全部成功后才提交”是硬要求,应把批次处理放进事务或先把输入分成可回滚的工作单元,不能只依赖捕获异常来撤销已经完成的副作用。
把边界写进实际消费代码
可以按下面的约束选择参数:
| 输入与业务要求 | 建议写法 | 需要留意 |
|---|---|---|
| 流式输入,尾部允许不足 | batched(source, n) | 下游按实际长度处理 |
| 每批必须完整 | batched(source, n, strict=True) | 准备错误处理或回滚 |
| 输入可能为空 | 直接遍历结果 | 不要假设至少有一批 |
| 需要重复读取 | 显式保存批次 | 评估内存与生命周期 |
最后检查四件事:n 是否来自可信配置、尾批是否允许变短、下游是否会产生不可逆副作用、异常后是否有补偿动作。这样使用 batched() 时,真正的边界就从隐含行为变成了代码中的明确约束。
相关问题
batched() 会把输入一次性读入内存吗?
不会。它按批次惰性消费输入,遍历到哪一批才读取到哪一批。
最后一批不足 n 个元素会怎样?
默认返回一个较短的元组;设置 strict=True 后会抛出 ValueError。
 Python 正则原子组避免回溯放大的写法
- 上一篇
- Python 正则原子组避免回溯放大的写法
- 下一篇
- Python hashlib.file_digest 怎样直接计算文件摘要
-
- 文章 · python教程 | 15分钟前 | 并发编程 · Python教程 · Python multiprocessing Pool initializer spawn initargs 多进程配置
- Python multiprocessing spawn 传递初始化配置的方案
- 295浏览 收藏
-
- 文章 · python教程 | 18分钟前 | 文件处理 · 标准库 · csv · python · 数据导入 · Python csv DictReader DictWriter 空行 newline lineterminator
- Python csv newline 参数避免空行的文件处理
- 365浏览 收藏
-
- 文章 · python教程 | 22分钟前 |
- Python 正则原子组避免回溯放大的写法
- 267浏览 收藏
-
- 文章 · python教程 | 42分钟前 | 标准库 · python · Python map sorted 对象属性 operator.attrgetter itemgetter
- Python operator.attrgetter 怎样批量读取对象属性
- 305浏览 收藏
-
- 文章 · python教程 | 1小时前 | python · 异步编程 · Python asyncio timeout CancelledError TimeoutError
- Python asyncio.timeout 区分超时与主动取消的边界
- 172浏览 收藏
-
- 文章 · python教程 | 1小时前 | python · 异步编程 · Python asyncio CancelledError TaskGroup ExceptionGroup
- Python asyncio.TaskGroup 取消兄弟任务的处理方式
- 289浏览 收藏
-
- 文章 · python教程 | 1天前 | 日志 · 标准库 · python · 工程实践 · Python logging request_id LogRecord setLogRecordFactory
- Python logging.setLogRecordFactory 怎样统一注入关联字段
- 306浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1014次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1019次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1143次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1119次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 960次使用
-
- Python TaskGroup 怎样让子任务失败统一收敛
- 2026-11-12 501浏览
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览


