
泛型 sort.SliceFunc 复用比较逻辑的实现方式
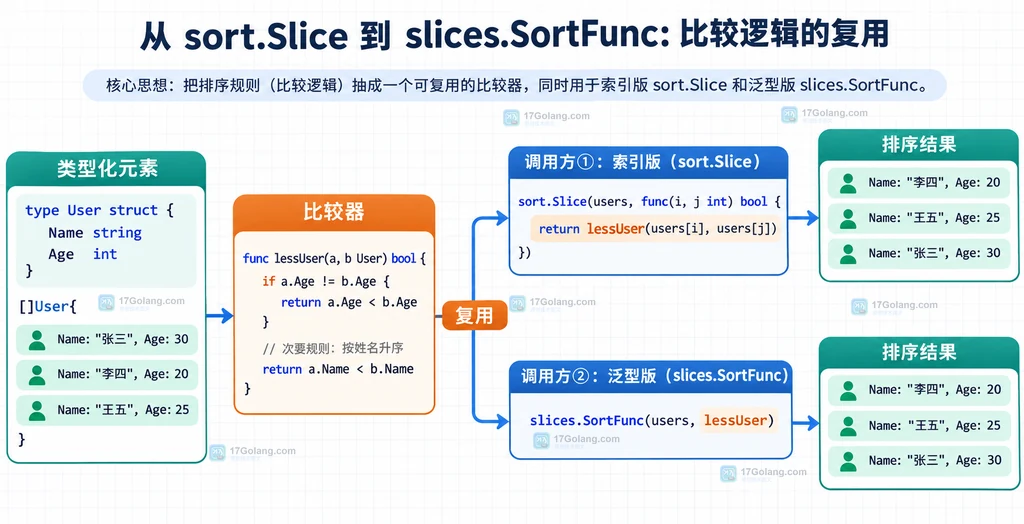
如果你搜索的是“泛型 sort.SliceFunc”,先记住一个容易混淆的点:Go 标准库里并没有这个函数名。旧的索引式 API 是 sort.Slice,接收 func(i, j int) bool;泛型排序对应的是 slices.SortFunc,接收 func(a, b T) int。真正要复用比较逻辑时,应把比较器独立出来,再交给一个或多个排序调用方。
在 Go 1.21 及更高版本中,优先用slices.SortFunc表达结构体切片排序;比较器返回负数、0、正数分别代表小于、相等或大于。需要保留相等元素原顺序时,改用slices.SortStableFunc。
官方文档:https://pkg.go.dev/slices#SortFunc
先把 API 名称和调用方需求对齐
sort.Slice 仍然可用,它通过反射接收任意切片,比较函数拿到的是两个下标。这个接口适合维护旧代码,或者调用方必须兼容较老 Go 版本的场景;但每个比较器都要重复写一次 items[i] 和 items[j],复用时容易把切片变量绑定进闭包。
package main

import (
	"fmt"
	"sort"
)

type Task struct {
	Name string
	Cost int
}

func main() {
	tasks := []Task{
		{Name: "report", Cost: 30},
		{Name: "build", Cost: 10},
		{Name: "test", Cost: 20},
	}

	// sort.Slice 的比较函数只拿下标,元素访问依赖外层切片。
	sort.Slice(tasks, func(i, j int) bool {
		return tasks[i].Cost
而 slices.SortFunc 直接把两个元素传给比较器,调用方不必关心下标。比较规则可以独立成普通函数值,也可以封装成泛型高阶函数,让同一套规则服务不同的切片。
把比较规则提取成泛型函数值
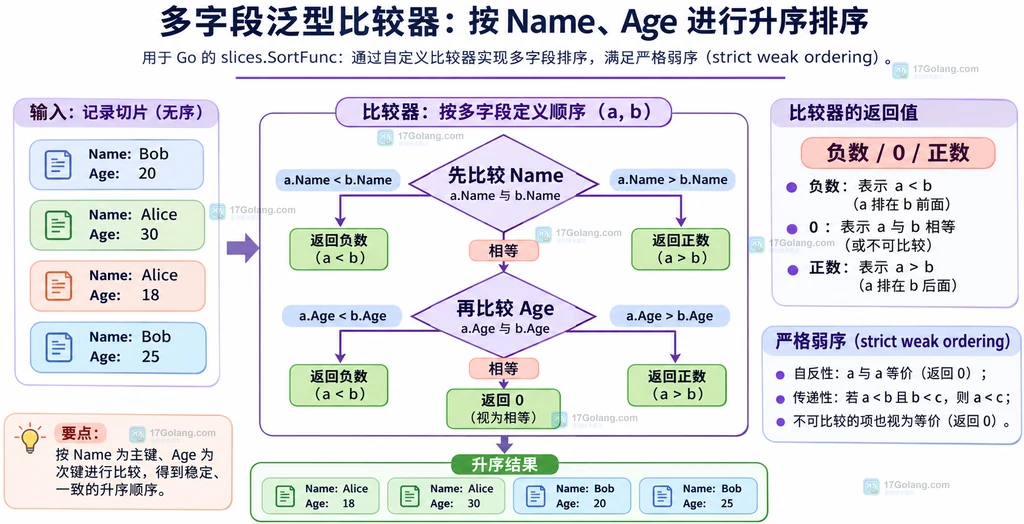
比较器的核心是参数语义,不是函数名字。对任意类型 T,可以约定 func(a, b T) int 返回负数、0、正数。这样一个比较器既能交给 slices.SortFunc,也能交给搜索或排序检查类 API,调用方的职责更清楚。
package main

import (
	"fmt"
	"slices"
)

type Task struct {
	Name string
	Cost int
}

// CompareByCost 只描述 Task 的成本顺序,不绑定某个具体切片。
func CompareByCost(a, b Task) int {
	if a.Cost  b.Cost {
		return 1 // a 应排在 b 后面。
	}
	return 0 // 成本相同,交给稳定性或下一个规则处理。
}

func main() {
	first := []Task{{"report", 30}, {"build", 10}, {"test", 20}}
	second := []Task{{"lint", 20}, {"deploy", 40}, {"unit", 10}}

	// 同一比较器可以复用于不同的同类型切片。
	slices.SortFunc(first, CompareByCost)
	slices.SortFunc(second, CompareByCost)

	fmt.Println(first)
	fmt.Println(second)
}
这种写法的直接收益是:排序规则不再捕获某个外层切片,也不需要为每个业务列表复制一份闭包。调用方只负责选择要排序的切片,规则函数负责解释两个元素的顺序。
组合多字段条件时先处理主字段
真实列表通常不是只按一个整数排序。常见需求是先按名称升序,名称相同再按成本升序。实现时先计算主字段比较结果;只有结果为 0,才进入次字段。不要直接把两个布尔表达式相加,也不要在相等时随意返回 1 或 -1,否则比较器可能不再满足排序要求。
package main

import (
	"cmp"
	"fmt"
	"slices"
	"strings"
)

type User struct {
	Name string
	Age  int
}

// CompareUser 先比较名称,再用年龄打破同名记录的平局。
func CompareUser(a, b User) int {
	if nameOrder := strings.Compare(a.Name, b.Name); nameOrder != 0 {
		return nameOrder // 主字段不同,立即确定顺序。
	}
	return cmp.Compare(a.Age, b.Age) // 主字段相等时比较次字段。
}

func main() {
	users := []User{
		{Name: "Kai", Age: 30},
		{Name: "Ana", Age: 28},
		{Name: "Ana", Age: 22},
	}

	// SortFunc 原地重排 users;需要新切片时先复制再排序。
	slices.SortFunc(users, CompareUser)

	// 结果是 Ana/22、Ana/28、Kai/30。
	fmt.Println(users)
}
cmp.Compare 适合处理满足 cmp.Ordered 的基础类型;字符串可以使用 strings.Compare。如果比较的是自定义结构体或需要忽略大小写,就把那一层转换放在比较器内部,不要让排序调用方重复实现。
错误处理要放在比较器之外
排序比较器只能回答“两个已经可比较的元素谁在前面”。它不适合承担网络请求、文件读取、随机数生成或会修改共享状态的工作。比较函数可能被调用很多次,且调用顺序不应作为业务逻辑依据。遇到无法解析的字段,先在进入排序前完成清洗或把错误封装在元素状态里,再让比较器使用确定的值。
package main

import (
	"fmt"
	"slices"
)

type ScoreRow struct {
	Name  string
	Score int
	Valid bool
}

// CompareScore 只比较预先解析好的字段,不在排序阶段返回 error。
func CompareScore(a, b ScoreRow) int {
	// 无效记录统一排到末尾,保证比较器对同一输入保持一致。
	if a.Valid != b.Valid {
		if a.Valid {
			return -1
		}
		return 1
	}
	if a.Score  b.Score {
		return -1
	}
	return 0
}

func main() {
	rows := []ScoreRow{{"A", 80, true}, {"bad", 0, false}, {"B", 95, true}}
	slices.SortFunc(rows, CompareScore)
	fmt.Println(rows)
}
如果业务上必须报告解析错误,先用独立函数返回 ([]ScoreRow, error),错误处理完成后再排序。这样排序 API 的签名保持简单,失败路径也不会被隐藏在比较回调里。
稳定性和版本兼容怎么选
slices.SortFunc 不保证稳定:比较结果为 0 的元素,排序后可能改变原有相对顺序。如果相等项的原始顺序有意义,例如同一批次内的到达顺序,就使用 slices.SortStableFunc,或者把业务上的唯一字段追加到比较规则中。
package main

import (
	"fmt"
	"slices"
)

type Event struct {
	Group string
	Seq   int
}

func main() {
	events := []Event{{"A", 2}, {"B", 1}, {"A", 1}}

	// 稳定排序只按 Group 比较,Group 相同的事件保留原相对顺序。
	slices.SortStableFunc(events, func(a, b Event) int {
		if a.Group  b.Group {
			return 1
		}
		return 0
	})

	fmt.Println(events)
}
如果项目必须支持没有 slices.SortFunc 的旧 Go 版本,就继续使用 sort.Slice,并将元素级比较器适配为索引式闭包。适配层应尽量薄,让规则仍然集中在一个地方。
package main

import "sort"

type Task struct {
	Name string
	Cost int
}

// LessByCost 保留元素级规则,适配旧版 sort.Slice 的下标签名。
func LessByCost(tasks []Task, i, j int) bool {
	return tasks[i].Cost
需要注意的是,sort.Slice 的官方文档也提示,在许多场景下新的 slices.SortFunc 更符合人体工学且运行更快。迁移时优先看项目的 Go 版本和稳定性要求,再决定是否替换 API。
一张表记住比较器的设计边界
| 问题 | 推荐做法 | 原因 |
|---|---|---|
| 需要泛型元素比较 | slices.SortFunc | 比较器直接接收元素,便于复用 |
| 必须保留相等项顺序 | slices.SortStableFunc | 稳定排序显式表达业务意图 |
| 兼容旧 Go 版本 | sort.Slice + 薄适配器 | 保留索引式签名,集中元素规则 |
| 字段可能解析失败 | 排序前清洗并返回错误 | 比较回调不隐藏失败路径 |
| 多字段排序 | 主字段非 0 就返回,否则比较次字段 | 形成稳定、可解释的决策链 |
常见问题
sort.SliceFunc 在哪个包里?
标准库没有名为 sort.SliceFunc 的函数。通常要找的是 slices.SortFunc;如果代码必须使用索引比较,使用 sort.Slice。
比较器为什么不能返回 bool?
slices.SortFunc 需要负数、0、正数三态结果,便于表达相等和多字段比较;返回 bool 的签名属于 sort.Slice 这类索引式 API。
相等项顺序变了怎么办?
如果原顺序是业务信息,使用 slices.SortStableFunc;如果顺序本来就应由第二字段决定,就在比较器中明确追加第二字段。
比较器可以在内部修改元素吗?
不建议。比较函数应保持确定性和无副作用,否则排序过程可能因调用次数和调用顺序变化而产生难以复现的结果。
相关官方文档可复制查看:https://pkg.go.dev/sort#Slice、https://pkg.go.dev/slices#SortFunc、https://pkg.go.dev/slices#SortStableFunc、https://pkg.go.dev/cmp。
 slices.Compact 删除相邻重复值的实现方式
- 上一篇
- slices.Compact 删除相邻重复值的实现方式
- 下一篇
- 泛型约束处理可选字段排序的设计方法
-
- Golang · Go教程 | 22分钟前 |
- Go pipeline 用 done 信号回收中间 goroutine 的实践示例
- 291浏览 收藏
-
- Golang · Go教程 | 22分钟前 |
- maps.Clone 复制配置映射并隔离后续修改的方法
- 265浏览 收藏
-
- Golang · Go教程 | 26分钟前 |
- 通道关闭责任划分与多生产者退出的设计方法
- 186浏览 收藏
-
- Golang · Go教程 | 27分钟前 | Go并发 WaitGroup sync.WaitGroup.Go 任务生命周期
- sync.WaitGroup.Go 管理并发任务生命周期的实现方式
- 219浏览 收藏
-
- Golang · Go教程 | 32分钟前 |
- atomic.Pointer 热更新只读配置的原子切换方案
- 162浏览 收藏
-
- Golang · Go教程 | 33分钟前 | 标准库 · Go教程 · Go 结构化日志 log/slog HandlerOptions LevelVar slog.Leveler slog.Level
- Go slog.Leveler 自定义日志级别映射的实现方式
- 490浏览 收藏
-
- Golang · Go教程 | 38分钟前 | CLI · 命令行工具 · 环境变量 · Go教程 · 环境变量 Go 命令行参数 urfave/cli EnvVars StringFlag
- Go urfave/cli 怎样把环境变量绑定到命令参数
- 327浏览 收藏
-
- Golang · Go教程 | 1小时前 | 日志 · 标准库 · Go教程 · slog · 工程实践 · Go 结构化日志 JSONHandler log/slog slog.Group
- slog.Group 将结构化日志按业务域分组的方法
- 468浏览 收藏
-
- Golang · Go教程 | 1小时前 |
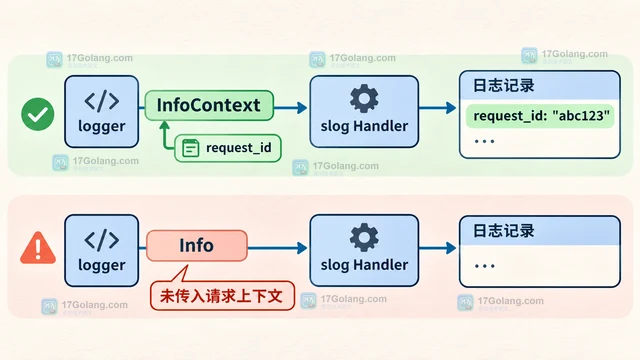
- slog.Handler 添加请求 ID 属性的工程实现
- 278浏览 收藏
-
- Golang · Go教程 | 1小时前 | Go http.Transport http.Client TLS握手超时 TLSHandshakeTimeout
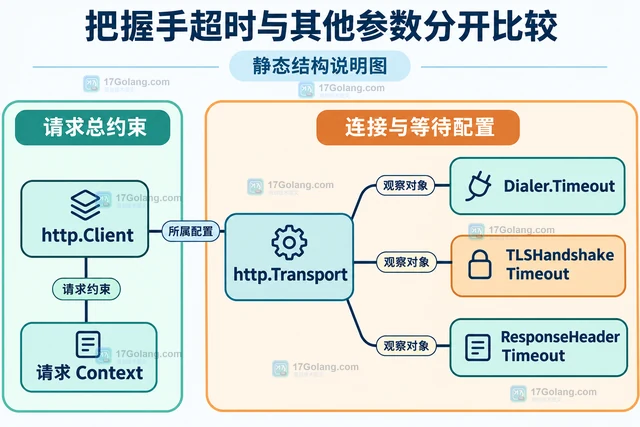
- http.Transport 控制 TLS 握手超时的参数对比
- 373浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 998次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1000次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1121次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1096次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 939次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览


