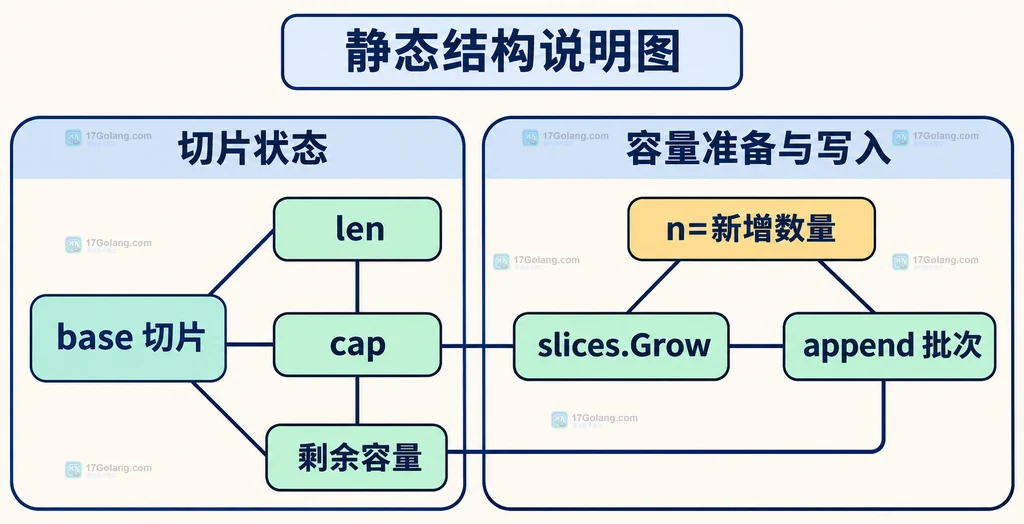
如果一个切片已经积累了一部分数据,接下来明确知道还要追加多少元素,可以用 slices.Grow 提前为这批元素准备容量。它的第二个参数 n 表示“还要追加的元素数量”,不是目标容量;函数返回的切片必须重新接住,因为预留不足时可能换了底层数组。
官方地址:https://pkg.go.dev/slices
slices.Grow(s, n)保证随后至少可以向s追加n个元素而不再因容量不足分配。- 当现有剩余容量已经够用时,它不会为了凑整额外扩容;容量超过需求时也不会主动裁剪。
n为负数或所需内存无法分配时会 panic,调用方仍要控制输入。
先看懂 slices.Grow 的参数和返回值
标准库的泛型签名是 func Grow[S ~[]E, E any](s S, n int) S。它计算的是当前可用余量 cap(s)-len(s) 与 n 的差:余量足够就原样返回,不足才准备更多空间。因此 n 应该和“本轮即将 append 的数量”对应。
例如当前 len=4、cap=8,还要追加 3 个元素,剩余容量是 4,调用 slices.Grow(s, 3) 不需要扩容;如果还要追加 6 个,函数会准备更大的容量,但最终容量由运行时分配策略决定,不要把它当作精确的 len+n。
批量追加前预留一段容量
最适合 slices.Grow 的场景是“已有结果,再接收一批已知数量的数据”。下面的代码用返回值覆盖原切片,然后再执行 append;注释里的计数是本轮新增数量,而不是整个切片的最终长度。
package main

import (
	"fmt"
	"slices"
)

func mergeBatch(base []string, batch []string) []string {
	// n 是本轮新增元素数量,不是 base 的目标容量。
	base = slices.Grow(base, len(batch))
	// Grow 只负责准备空间,真正写入仍由 append 完成。
	base = append(base, batch...)
	return base
}

func main() {
	items := []string{"旧记录"}
	newItems := []string{"订单-101", "订单-102"}
	items = mergeBatch(items, newItems) // 接住可能变化的底层数组
	fmt.Println(items)
}
这里的收益不是“任何 append 都会更快”,而是把已知的批次大小一次告诉切片。若 base 当前的剩余容量不够,Grow 可以把这次容量准备和后续追加分开表达;若容量本来就足够,则不会因为调用 Grow 而再分配。
和 make 初始容量、直接 append 怎么选
三种写法解决的时间点不同。创建结果切片前就知道大致总量时,make([]T, 0, expected) 更直接;切片已经存在、后面才知道一批数据大小时,slices.Grow 更贴合;数量完全未知时,直接 append 让运行时按需增长通常更简单。
| 场景 | 写法 | 关注点 |
|---|---|---|
| 创建时知道总量 | make([]T, 0, total) | 初始容量表达整体预估 |
| 中途知道下一批大小 | s = slices.Grow(s, len(batch)) | n 表示本轮新增数量 |
| 数量无法预估 | s = append(s, value) | 保持代码简单,避免猜容量 |
不要为了追求“少一次分配”而盲目把 n 写得很大。过度预留会让内存占用提前上升;如果后续数据并不一定到来,直接追加或按真实批次调用 Grow 往往更稳妥。
四个参数边界要提前处理
1. n 是追加量
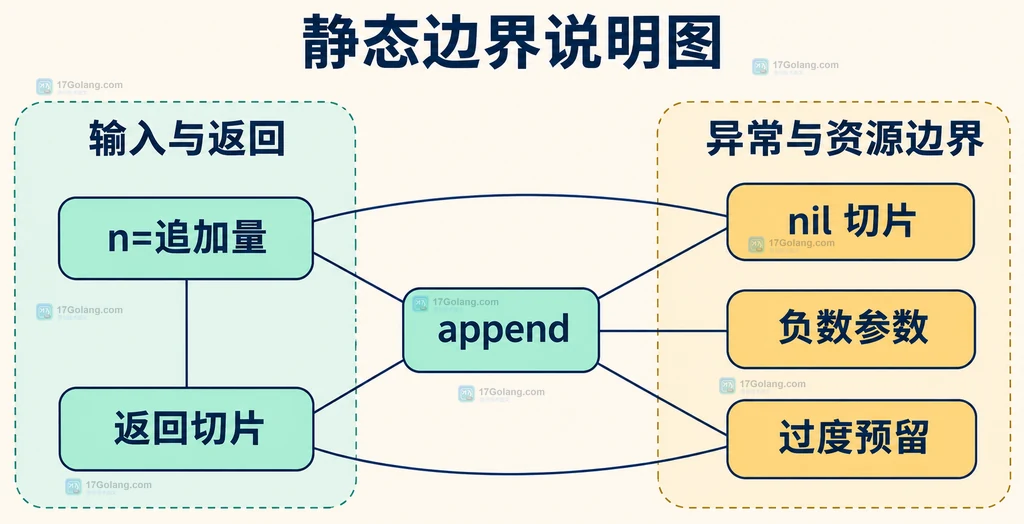
想让最终容量达到某个数时,要先减去当前长度,例如目标是容纳 target 个元素,追加量应按业务实际计算,不能直接把 target 当成 n,否则会多预留一段空间。
2. 必须使用返回值
slices.Grow(s, n) 的结果可能指向新的底层数组。只调用而不写回 s,后面的 append 仍可能基于旧切片继续扩容。
3. 负数不是“无需扩容”
负数参数会触发 panic。若 n 来自外部配置或差值计算,应先校正或拒绝非法输入;不要把负数当作关闭预留的开关。
4. nil 切片也可以传入
对 nil 切片调用 Grow 后再 append 是合法的,结果仍由返回值决定。只有在确实知道未来会追加多少时才预留;否则 nil 加 append 的表达更清楚。
常见问题
Grow 会把容量精确设置成 len 加 n 吗?
不会。它只保证随后至少能追加 n 个元素而不因容量不足再分配,实际容量可能更大。
调用 Grow 后还需要 append 吗?
需要。Grow 只准备容量,不增加切片长度,也不写入元素;真正的元素追加仍由 append 完成。
总结:把 slices.Grow 放在“已存在切片、即将追加已知批次”的位置,传入本轮新增数量并接住返回值。创建时已知总量用 make,数量未知就直接 append;同时控制负数和过度预留,才能让容量优化保持可读和可控。
 Go pipeline 用 done 信号回收中间 goroutine 的实践示例