如果程序只拿到一段自然语言,再靠字符串查找字段,模型换一种表达就容易让下游代码失去依据。Gemini API 的 structured output 可以把返回目标写成 JSON Schema,让结果至少遵守对象、字段类型、数组和枚举这些结构约束。需要注意的是,它约束的是“返回长什么样”,不是替你证明内容一定真实。
官方地址:https://ai.google.dev/gemini-api/docs/structured-output
下面用一个小型工单抽取示例说明完整链路:输入工单文本,返回标题、优先级和标签,最后由本地代码完成 JSON 解析和业务层复核。示例采用官方 structured output 页面展示的 response_format 形态,模型名只作为示例,实际调用时应换成项目当前可用的模型。
先分清 structured output 能保证什么
结构化输出最适合数据抽取、分类以及给工具或接口准备参数。调用方把目标 schema 交给模型,模型返回的文本会朝着这个结构生成;调用方仍然要负责解析、记录原文,并对金额、权限、业务状态等关键事实做自己的判断。
| 层次 | 负责什么 | 不能替代什么 |
|---|---|---|
| 提示词 | 说明任务、字段含义和抽取范围 | 不能单独保证 JSON 一定可解析 |
| JSON Schema | 约束对象、字段类型、枚举和必填关系 | 不能证明模型抽取的事实正确 |
| 本地解析 | 把 JSON 文本转换成程序对象 | 不能替代权限、金额和业务规则 |
| 业务校验 | 检查值是否符合自己的系统约束 | 不能修复一个不完整或被截断的响应 |
把工单字段写成 JSON Schema
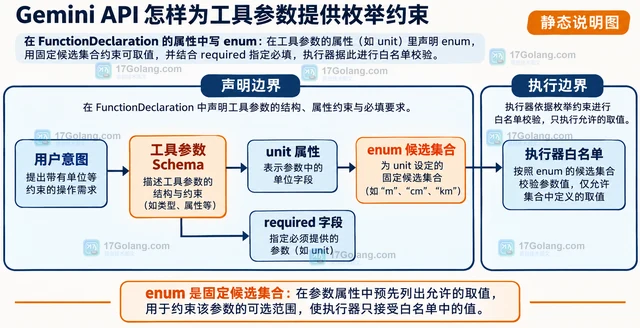
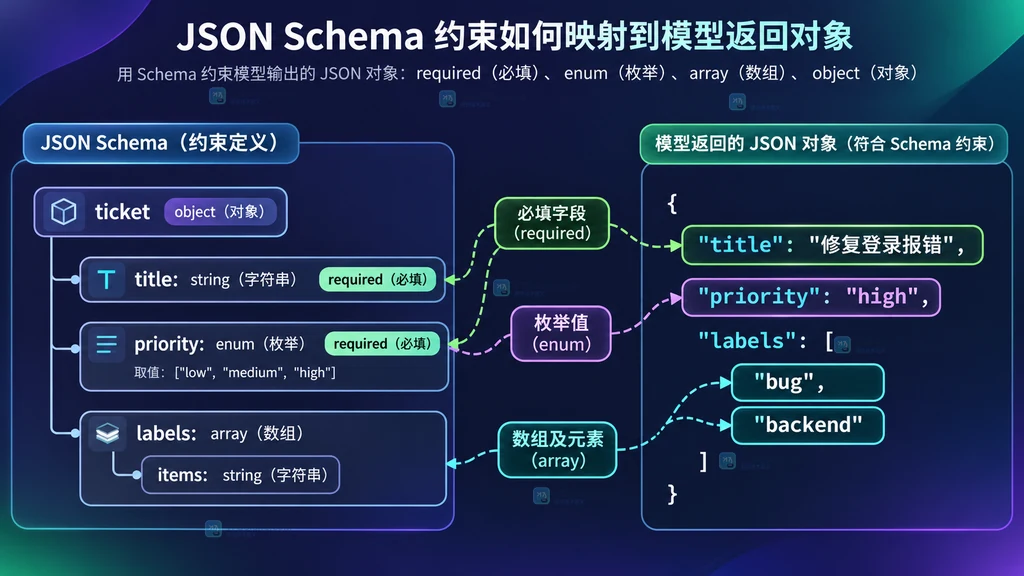
先把结果设计成一个小而稳定的对象:title 是字符串,priority 只能取有限枚举,labels 是字符串数组。required 表示调用方必须得到的字段;如果某个字段确实可以缺省,就不要为了“看起来完整”把它强行加入必填集合。
下面是严格 JSON,不能在其中加入注释。字段含义分别由 properties 描述,enum 把优先级限制为三个值,items 说明数组成员类型。
{
  "type": "object",
  "properties": {
    "title": {
      "type": "string",
      "description": "工单的简短标题"
    },
    "priority": {
      "type": "string",
      "enum": ["low", "medium", "high"],
      "description": "工单优先级"
    },
    "labels": {
      "type": "array",
      "items": {"type": "string"},
      "description": "工单标签"
    }
  },
  "required": ["title", "priority", "labels"]
}
Schema 越贴近下游真正需要的字段,后面的解析越简单。不要一开始就塞进几十个描述性字段;字段过多会提高维护成本,也会让“必填”失去边界。
在 Gemini API 请求中传入 schema
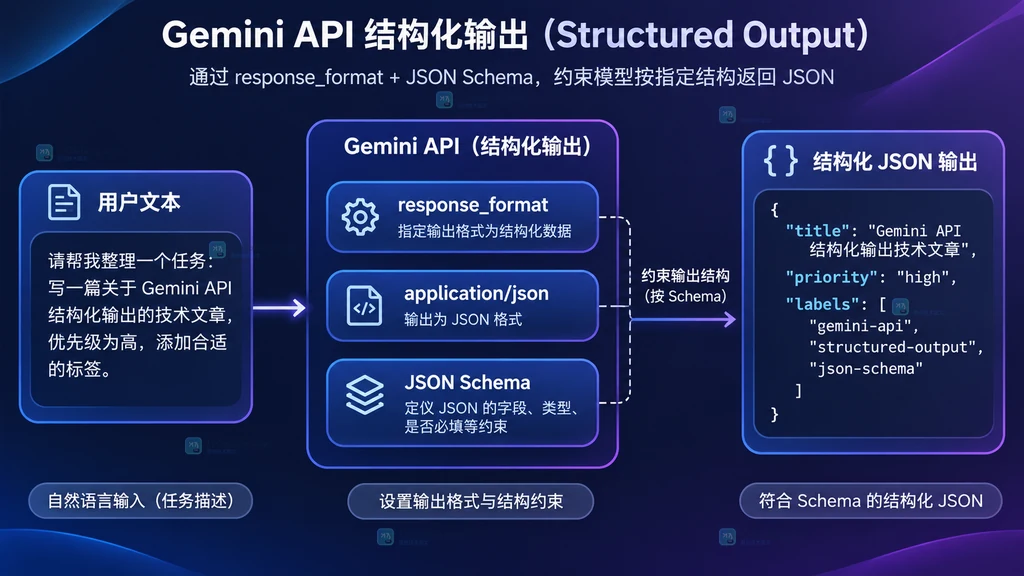
官方 Python 示例使用 google-genai 与 Pydantic:请求中的 mime_type 指定 JSON,schema 传入 Pydantic 生成的 JSON Schema。这样既能把 schema 交给模型,也能复用同一个模型做返回解析。
import os
from typing import List, Literal

from google import genai
from pydantic import BaseModel, Field


class Ticket(BaseModel):
    # 字段描述帮助模型理解抽取目标,也方便后续维护 schema。
    title: str = Field(description="工单的简短标题")
    priority: Literal["low", "medium", "high"] = Field(description="工单优先级")
    labels: List[str] = Field(description="工单标签")


def extract_ticket(text: str) -> Ticket:
    # 从环境变量读取密钥,避免把凭据写进代码或文章示例。
    client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

    # response_format 约束返回为 JSON 文本,并传入 Pydantic 生成的 schema。
    interaction = client.interactions.create(
        model="gemini-3.8-flash",
        input=(
            "请从下面的工单中抽取标题、优先级和标签,只依据原文:\n"
            + text
        ),
        response_format={
            "type": "text",
            "mime_type": "application/json",
            "schema": Ticket.model_json_schema(),
        },
    )

    # 解析失败时让异常向上层暴露,调用方可以记录原文并安排重试。
    return Ticket.model_validate_json(interaction.output_text)


ticket = extract_ticket("支付页面在晚高峰超时,影响线上订单,先标记为高优先级。")
print(ticket.model_dump())
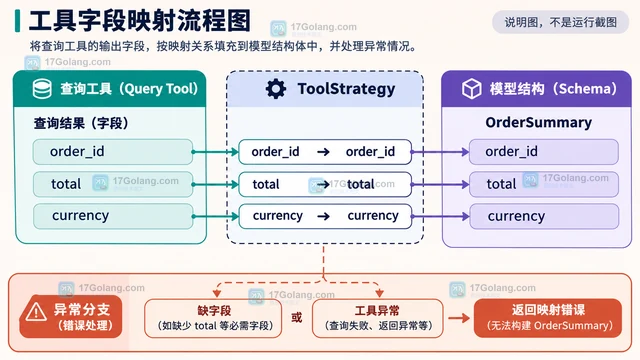
这里的 Ticket.model_json_schema() 负责把 Python 类型转换为 schema,Ticket.model_validate_json 负责把模型返回文本转换为强类型对象。两者配合起来,调用代码不需要手工从字符串中切字段。
解析成功后仍要做业务校验
“能解析”只说明文本符合结构,不代表所有业务结论都可以直接写库。比如模型返回了 priority=high,系统仍应判断当前操作者是否有权创建高优先级工单;标签数量、标题长度和敏感字段也应该由本地规则控制。
def validate_for_storage(ticket: Ticket) -> None:
    # 结构化输出不负责业务规则,这里检查写库前的本地边界。
    if not ticket.title.strip():
        raise ValueError("工单标题不能为空")
    if len(ticket.title) > 80:
        raise ValueError("工单标题不能超过 80 个字符")
    if len(ticket.labels) > 8:
        raise ValueError("工单标签不能超过 8 个")

    # 业务侧只允许这些标签,未知标签交给人工或补偿队列处理。
    allowed = {"支付", "订单", "性能", "客户"}
    unknown = set(ticket.labels) - allowed
    if unknown:
        raise ValueError(f"存在未登记标签: {sorted(unknown)}")


try:
    ticket = extract_ticket("支付接口超时,客户无法下单。")
    validate_for_storage(ticket)
except (ValueError, TypeError) as exc:
    # 记录输入和错误类型,避免把不确定结果直接写入业务表。
    print({"status": "needs-review", "error": str(exc)})
生产环境还要记录请求 ID、模型名、schema 版本和原始响应摘要。这样出现字段缺失、解析失败或业务拒绝时,才能知道是提示词、schema、接口返回还是本地规则发生了变化。
几个容易混淆的边界
Schema 能不能让模型“绝对不出错”?
不能。它主要解决输出结构的稳定性,不能替代事实核对、权限判断和领域规则。尤其是从模糊文本抽取数据时,结构正确的值也可能是错误判断。
所有字段都应该放进 required 吗?
不应该。只有下游没有它就无法继续的字段才适合设为必填;可选字段可以在 schema 中明确类型,并在本地模型里提供默认值或单独的缺省处理。
为什么还要保留原始响应?
因为解析和业务校验失败时,原文是定位问题的依据。保存时注意脱敏,不要把 API 密钥、个人隐私或无关的完整上下文写入普通日志。
落地时的最小清单
- 先列出下游真正要用的字段,再决定哪些字段必填。
- 用
object、string、array、enum描述结构,并给复杂字段写清楚描述。 - 请求中同时设置 JSON MIME 类型和 schema,不要只在提示词里说“请返回 JSON”。
- 收到结果后先做 JSON 解析,再做长度、权限、枚举和业务状态检查。
- 把 schema 版本、原始响应摘要和错误分类纳入可观察性记录。
一句话总结:Gemini API structured output 负责把模型回答约束到可消费的 JSON 形状,JSON Schema 负责表达字段契约,而业务代码仍要负责解析后的真实性、权限和落库边界。
相关问题
只设置 application/json,不传 schema 可以吗?
可以得到 JSON 方向的输出,但字段结构仍然缺少明确契约。需要稳定消费时,应把对象属性、数组成员和必填字段写进 schema。
Pydantic 和手写 JSON Schema 选哪个?
Python 项目已有数据模型时,Pydantic 更方便复用类型和解析;跨语言或需要与接口文档共享时,手写 JSON Schema 更容易作为独立契约维护。
解析失败应该自动重试吗?
先区分网络错误、空响应、截断和 schema 不匹配,再决定是否重试。重试必须保留次数上限和原始输入,不能把同一结果无限写回业务系统。
资料来源:https://ai.google.dev/gemini-api/docs/structured-output;https://ai.google.dev/gemini-api/docs
 Postman mock server怎样用示例响应模拟接口