如果一批任务都已经准备好,而且结果不需要立刻返回,Gemini API Batch 通常比逐条同步调用更合适。它把大量 generateContent 请求交给异步批处理,官方文档给出的目标周转时间是 24 小时以内,价格按对应交互式调用的约 50% 计算。这里的关键不是把循环改成“批量”两个字,而是把输入、任务状态、单条结果和重试边界分开管理。
官方地址:https://ai.google.dev/gemini-api/docs/batch-api
下面用 Python 和 google-genai SDK 做一个文件型 Batch 示例,重点放在大量离线生成请求的组织方式。示例不会把 Batch 当成实时接口,也不会把一个失败的请求误判成整批失败。
先看清 Batch 适合解决什么
我在设计离线生成任务时,会先问三个问题:输入能不能提前准备、结果能不能晚一些拿到、任务是否值得与在线流量隔离。如果三个答案大致都是“可以”,Batch 就有价值;如果用户正在等待聊天回复,或者每一步都依赖前一步的结果,异步批处理反而会增加复杂度。
| 任务特征 | 更适合的方式 | 原因 |
|---|---|---|
| 用户正在等待一条回复 | 同步或流式调用 | 延迟比吞吐更重要 |
| 夜间一次生成数万条摘要 | 文件型 Batch | 输入可预先准备,结果可延后处理 |
| 离线评测同一组提示词 | Batch | 请求相互独立,适合统一提交和汇总 |
| 后一条请求依赖前一条输出 | 拆成在线编排 | 批任务不提供实时的逐条依赖控制 |
Batch 省下的是调度和等待成本,不是业务设计成本。业务侧仍然要保存任务批次号、输入行号、自己的业务键以及最终结果位置。
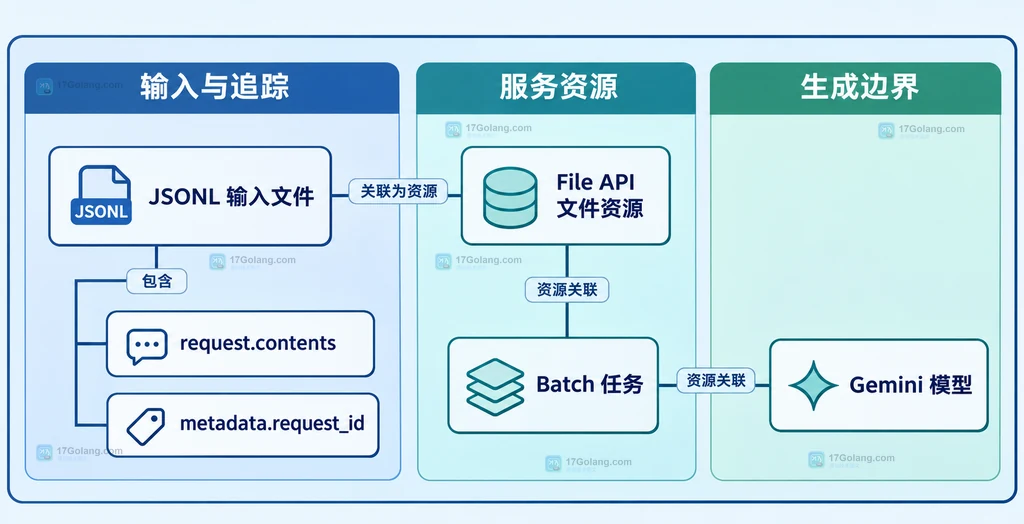
用 JSONL 把每条请求变成可追踪单元
文件型 Batch 的输入是 JSON Lines:每一行都是一个完整请求对象。为了让结果可以回写业务表,我建议在每行旁边保留自己的 request_id 或 metadata。不要把几十万条请求先拼成一个巨大 JSON 数组再上传,那样不利于流式生成、定位单行错误和拆分批次。
下面的文件示例保持 JSONL 有效,不在 JSON 中插入注释;字段含义写在代码块外,避免破坏解析。
{"request":{"contents":[{"role":"user","parts":[{"text":"请把下面的工单摘要成三句话:订单延迟,仓库已出库,客户要求改地址。"}]}]},"metadata":{"request_id":"ticket-1001","source":"nightly-summary"}}
{"request":{"contents":[{"role":"user","parts":[{"text":"请把下面的工单分类为物流、售后或地址变更,并只返回分类名。"}]}]},"metadata":{"request_id":"ticket-1002","source":"nightly-summary"}}
request 是标准的 GenerateContentRequest,可以按模型支持情况带上系统指令、生成配置或多模态输入。metadata 是业务侧的追踪信息,读取文件结果时先拿它关联原始记录,再处理模型响应。
上传文件并创建一个 Batch
使用 Python SDK 时,可以先通过 File API 上传 JSONL,再把返回的文件名交给 client.batches.create。这里的 model 要换成当前项目实际支持 Batch 的模型,不能因为普通接口支持某个模型,就默认它一定支持批处理。
import os
from google import genai

# API 密钥从环境变量读取,避免把凭据写进脚本或输入文件。
client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

# 上传已经准备好的 JSONL;每行是一条完整的 GenerateContentRequest。
uploaded = client.files.upload(file="batch_requests.jsonl")

# 创建异步批任务;display_name 用来在日志和后台列表中识别业务批次。
batch_job = client.batches.create(
    model="gemini-2.5-flash",
    src={"file_name": uploaded.name},
    config={"display_name": "nightly-ticket-summary"},
)

# 只保存资源名和输入文件名,后续查询与结果下载都依赖这个标识。
print({"batch_name": batch_job.name, "input_file": uploaded.name})
创建动作本身不是幂等的:相同输入重复调用创建接口,可能产生两个独立的 Batch。生产任务应该先写一条“待提交”记录,拿到 batch_job.name 后再更新为“已提交”,重启恢复时优先查询已有资源名。
小批量也可以直接使用内联请求,但官方建议较大的请求使用输入文件。文档还给出了单个输入文件 2GB 的限制;这不意味着应该把所有任务都塞到一个文件里,文件越大,结果等待和失败重放的粒度也越粗。
轮询时区分任务状态与单条结果
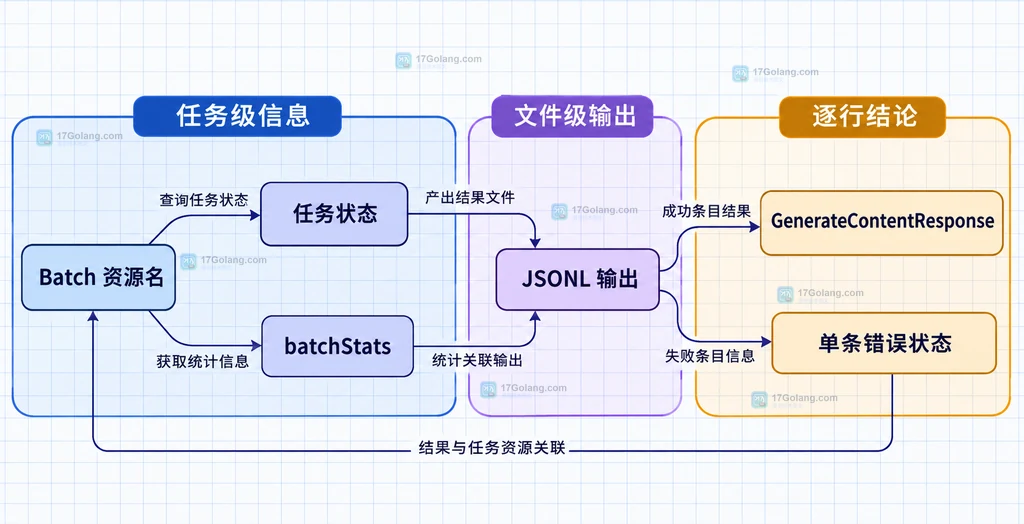
提交成功只表示批任务已经创建,并不代表每条生成都成功。轮询时至少要保存批任务的状态、创建时间、更新时间和统计信息。任务完成后,如果使用文件输出,还要逐行读取结果:其中既可能有正常的 GenerateContentResponse,也可能有描述某一行失败原因的状态对象。
import time

# 这些状态表示服务已经给出最终结论,具体枚举以当前 API 返回为准。
terminal_states = {
    "JOB_STATE_SUCCEEDED",
    "JOB_STATE_FAILED",
    "JOB_STATE_CANCELLED",
}

while True:
    # 用资源名查询同一个 Batch,不重新创建任务。
    current = client.batches.get(name=batch_job.name)
    state = getattr(current, "state", None)
    print({"batch_name": current.name, "state": state})

    if state in terminal_states:
        break

    # 轮询间隔只影响观察频率,不会让服务更快完成批任务。
    time.sleep(30)

# 成功完成后再读取 batch_stats,判断是否存在单条失败。
stats = getattr(current, "batch_stats", None)
print({"batch_stats": stats})
这里故意把“批任务完成”和“每条请求可用”拆开。即使最终状态是成功,也应该查看失败计数;如果输出是 JSONL,还要对每一行区分响应对象和错误状态,不能用“文件存在”作为结果完整的依据。
大量任务怎样拆分才容易恢复
当一批任务需要很久才能完成时,我更关心“中间结果是否要尽快落库”,而不是单个文件能装多少请求。可以按业务日期、数据来源或预计 token 数拆分,让每个子批次都有明确的输入范围和输出位置。这样做有三个好处:
- 某个子批次失败时,只重建对应输入,不用重放整夜数据。
- 需要先展示一部分结果时,可以按子批次逐段上线。
- 统计成本、失败率和平均等待时间时,维度更清楚。
拆分不是越碎越好。批次过多会增加资源记录和调度管理成本,也可能让同一类请求被分散到很多难以比较的窗口。可以先按“结果时效”和“故障隔离”定一个合理粒度,再根据实际等待时间调整。
几个容易踩到的边界
不要把 Batch 当成低延迟接口
官方定位是大规模、非紧急任务,目标周转时间是 24 小时。它适合离线预处理、评测、批量摘要和分类,不适合把用户点击后的首屏回复交给 Batch。
不要只看批任务的最终状态
完成状态、统计信息和逐行响应是三层信息。最终状态告诉你批任务的结论,统计信息告诉你整体是否有失败,逐行结果才告诉你哪条业务记录需要人工处理或单独重试。
不要无条件重发相同创建请求
创建接口不是幂等操作。程序超时后应先用本地记录的批任务名查询,再决定是否需要补建。只有在确认服务端没有创建成功、并且输入仍然可重放时,才重新提交。
不要把官方限制写死成业务承诺
文档中的目标周转时间、输入大小和模型支持范围会随服务变化。文章写作时可以按官方文档说明当前边界,但线上系统仍应把模型、配额和错误码当成可配置、可观察的运行条件。
最后的落地清单
如果你的任务是夜间生成、离线评测或批量预处理,可以按下面的顺序落地:
- 确认结果不要求实时返回,并记录输入总量、可接受等待时间和失败重试策略。
- 用 JSONL 一行一条请求,为每行附带可以回写业务表的标识。
- 上传文件后创建 Batch,把批任务名、模型名和输入文件名保存到任务表。
- 轮询同一个批任务,完成后同时读取状态、统计信息和逐行输出。
- 将成功结果与失败行分开落库,只对明确失败的行做后续处理。
一句话总结:Gemini API Batch 的价值在于把“可提前准备、可延后收集”的大量请求交给异步调度;真正可靠的实现,则取决于 JSONL 输入、任务资源名、逐行结果和恢复策略是否彼此对应。
相关问题
内联请求和 JSONL 文件怎么选?
请求数量少、总请求体能控制在较小范围内时可以用内联请求;大量或单条内容较长时优先用 JSONL 文件,便于拆分、上传和逐行处理。
Batch 完成后还需要看失败计数吗?
需要。任务级完成不等于每条请求都成功,尤其是文件输出场景,必须读取统计信息并解析每一行结果。
同一批请求能不能边生成边给用户看?
不应这样设计。需要即时反馈时使用同步或流式接口;Batch 更适合统一提交、延后收集和离线处理。
资料来源:https://ai.google.dev/gemini-api/docs/batch-api;https://ai.google.dev/api/batch-api;https://ai.google.dev/gemini-api/docs/files
 Gemini API 怎样为工具参数提供枚举约束