
Ollama API 怎样流式读取模型响应
读取 Ollama 原生 API 的流式响应时,应把响应体当作 application/x-ndjson:按换行读取一条 JSON,解析其中的文本增量并及时显示,直到收到 done: true。不要对整个响应体只调用一次 JSON 解析,也不要把一次网络读取等同于一条消息。HTTP 200 后仍可能出现带 error 的错误记录。
官方地址:https://docs.ollama.com/api/streaming
保护增量文本与完成状态
对一个本地写作助手,真正要保留的是两类资产:已经显示的文本,以及这段文本是否完整结束的状态。它们不能合成一个“有文字就成功”的布尔值。请求中途断开时,界面可能已有几句话,但这几句话只能标记为未完成草稿。
本文只使用原生 /api/generate,文本字段为 response,请求中显式设置 stream: true。/api/chat 的字段结构不同,不能直接照搬;OpenAI 兼容接口的事件格式也不在本文范围内。
本地请求地址采用 http://127.0.0.1:11434/api/generate。运行示例前应已启动 Ollama,并准备一个本机可用的模型,模型名通过环境变量 OLLAMA_MODEL 传入。本文不指定下载模型,也不假设读者已经拥有某个标签。
识别分帧和输出渲染风险
网络层读取的块大小由传输和客户端缓冲决定:一块可能包含多个 JSON 记录,也可能只含半条记录。NDJSON 的记录边界是换行,JSON 字符串里的换行会按 JSON 规则转义。因此本例使用逐行读取,把完整的一行交给解析器。
UTF-8 也可能在任意网络块中被拆开;直接对每个随意分块调用独立的解码操作,可能误报编码错误。逐行累积字节后再严格解码,避免把传输分块误认为字符边界。增量文字不等于一个词或一个 token,不应按照“每条记录恰好一个 token”计算进度。
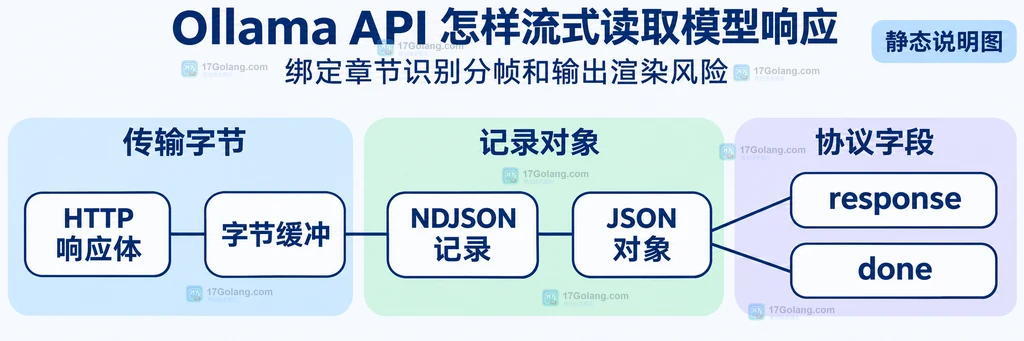
若把文字放进网页,应通过文本节点展示,或经受控的 Markdown 渲染与清理流程;不要把原始模型文本直接写成可执行 HTML。以下命令行示例只是把文本写到 stdout,并不提供网页渲染器。
区分请求失败与半途失败
| 情况 | 读取逻辑 | 业务状态 |
|---|---|---|
| HTTP 非成功状态 | 处理 HTTP 异常 | 请求失败 |
| 流中含 error 字段 | 停止当前读取并关闭响应 | 生成失败,已有文本保留为未完成 |
| EOF 前未见 done=true | 报告缺少完成记录 | 中断,不能算成功 |
| 收到 done=true | 处理本条文本后结束 | 流式生成结束,另看 done_reason |
官方错误文档说明,流开始后发生错误不会再改变原先的 HTTP 状态码。因此只检查 HTTP 200、随后忽略 error 对象,会漏掉真正的半途失败。完成记录也不一定代表回答符合业务要求:例如生成受到长度限制时,仍应结合结束原因提示用户。
用逐行解析和完成标记控制响应
下面的 Python 示例只依赖标准库。请求、读取和结束处理都在同一个上下文中,异常、用户中断和正常结束均会退出 with 块并关闭响应。它限制单行字节数和累计文本字符数,避免客户端无界缓冲;限制数值是示例的业务策略,不是 Ollama 协议上限。
import json
import os
import socket
import sys
from urllib.error import HTTPError, URLError
from urllib.request import Request, urlopen

MAX_LINE_BYTES = 1024 * 1024
MAX_TEXT_CHARS = 100_000

def consume(model, prompt):
    request = Request(
        "http://127.0.0.1:11434/api/generate",
        data=json.dumps({
            "model": model,
            "prompt": prompt,
            "stream": True,
        }, ensure_ascii=False).encode("utf-8"),
        headers={"Content-Type": "application/json"},
        method="POST",
    )
    total_chars = 0
    completed = False
    reason = None

    # timeout 约束阻塞操作,不是整段生成的总时长预算
    with urlopen(request, timeout=60) as response:
        while True:
            # 限长读取;超长记录直接报错,不继续拼接成无限大对象
            raw = response.readline(MAX_LINE_BYTES + 1)
            if not raw:
                break
            if len(raw) > MAX_LINE_BYTES:
                raise RuntimeError("单条记录超过客户端上限")
            if not raw.strip():
                continue

            part = json.loads(raw.decode("utf-8"))
            if not isinstance(part, dict):
                raise RuntimeError("流记录必须是 JSON 对象")
            if "error" in part:
                # 对外只报固定说明,避免把服务端原文写入公共日志
                raise RuntimeError("服务端返回流内错误,已输出文本不完整")

            text = part.get("response", "")
            if not isinstance(text, str):
                raise RuntimeError("response 字段必须是字符串")
            total_chars += len(text)
            if total_chars > MAX_TEXT_CHARS:
                raise RuntimeError("累计文本超过客户端上限")

            # 先输出本条文本,避免丢掉完成记录可能携带的末尾文字
            sys.stdout.write(text)
            sys.stdout.flush()
            if part.get("done") is True:
                completed = True
                reason = part.get("done_reason")
                break

    if not completed:
        raise RuntimeError("连接结束但没有完成记录,答案不完整")
    return reason

if __name__ == "__main__":
    try:
        # 使用本机已有模型;不在源码里保存密钥或私有服务地址
        selected_model = os.environ["OLLAMA_MODEL"]
        end_reason = consume(
            selected_model,
            "为海边图书角写三条简短的阅读活动建议,不编造日期和价格。",
        )
        print("\n生成结束,原因:" + str(end_reason), file=sys.stderr)
    except HTTPError as exc:
        print("\n请求失败,HTTP 状态:" + str(exc.code), file=sys.stderr)
        sys.exit(1)
    except (URLError, TimeoutError, socket.timeout, OSError,
            ValueError, RuntimeError, KeyError):
        # stdout 中可能已存在部分文字;错误不能将其标成完整回答
        print("\n读取失败,已显示内容应视为未完成草稿。", file=sys.stderr)
        sys.exit(1)
    except KeyboardInterrupt:
        print("\n用户取消,保留已显示草稿。", file=sys.stderr)
        sys.exit(130)
将代码保存为 stream_answer.py,在环境中设置已有模型的名称后运行。stdout 输出文本,stderr 输出结束或错误状态;代码没有在本文中实际执行,也没有附上虚构模型回答。
# OLLAMA_MODEL 应由当前环境设置为本机已有的模型名
python3 stream_answer.py
若所选模型单独返回 thinking 字段,本例不会把它混入答案,只输出 response。把思考内容展示成另一种产品状态,需要另行处理,不应把它当作正文增量拼接。连接关闭也不代表模型一定立即卸载,模型驻留配置与客户端响应关闭是不同职责。
记录结束原因与异常状态
应用至少应区分生成中、已结束、失败和用户取消。可以记录业务请求编号、收到的记录数、累计字数、是否收到完成记录以及结束原因;不必为了排障把完整提示词和生成文本写进公共日志。网页断开或用户取消时,转发服务也应结束相应的上游读取。
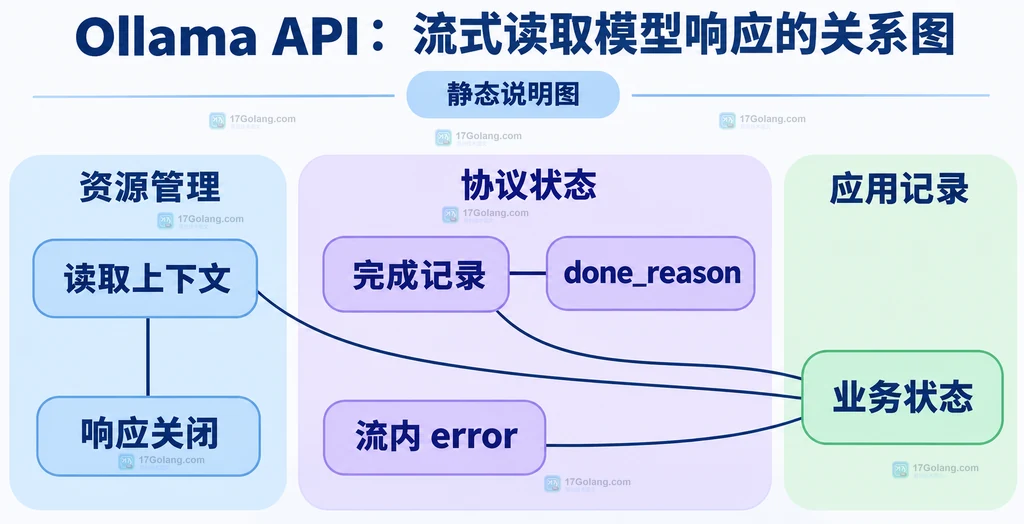
不要把 timeout=60 解读为整个回答最多生成 60 秒:本例是阻塞式标准库客户端,网络操作超时和总时长预算不是一回事。需要严格总时长与即时取消的服务,应采用支持取消和明确 deadline 的客户端设计。
同样,不要在已经显示部分回答后无提示地重试并继续追加。重新生成可能给出不同开头,直接拼接会制造重复或语义断裂。重试应作为新的生成尝试,明确清空、替换或保留旧草稿。
用合成片段判断读取逻辑
下面是人为构造的协议片段,用来解释逻辑,不是真实模型输出。第一条提供正文增量,第二条完成并携带末尾文字,因此阅读器应输出“先列提纲。”并记录结束原因。
{"response":"先列","done":false}
{"response":"提纲。","done":true,"done_reason":"stop"}
若第二条换成 {"error":"example failure"},则不能宣称第一条文字已经构成完整答案;若第二条完全缺失,EOF 也不能替代 done。严格 JSON 记录不支持注释,因此片段中的字段说明放在正文里。
为什么还是最后一次性显示?除客户端有没有 flush,还需考虑服务端、反向代理或前端读取层是否缓冲;curl 的显示选项也不能替代应用中的逐条解析。
能不能直接读取 data: 开头的行?本文原生接口使用 NDJSON,没有 SSE 的 data: 前缀。不要混用不同接口的解析器。
stream=false 怎么处理?它返回一个完整 JSON 对象,适合不需要增量显示的场景;处理方式应与流模式明确分开。
官方生成接口:https://docs.ollama.com/api/generate;流内错误规则:https://docs.ollama.com/api/errors。
 vLLM OpenAI 兼容服务怎样限制并发请求
- 上一篇
- vLLM OpenAI 兼容服务怎样限制并发请求
- 下一篇
- AI 代理怎样记录工具调用链路和失败原因
-
- 科技周边 · 人工智能 | 59分钟前 | python · 异步任务 · gemini · 批处理 · JSONL Batch API Gemini API 离线生成 google-genai
- Gemini API Batch 怎样处理大量离线生成请求
- 486浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 | enum 工具调用 Gemini API Function Calling FunctionDeclaration
- Gemini API 怎样为工具参数提供枚举约束
- 322浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 | ai · 可观测性 · 链路追踪 OpenTelemetry AI代理 工具调用
- AI 代理怎样记录工具调用链路和失败原因
- 250浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 | 并发控制 · 并发请求 vLLM 推理服务 OpenAI兼容服务
- vLLM OpenAI 兼容服务怎样限制并发请求
- 392浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- RAG 应用怎样用检索评估区分召回和生成问题
- 476浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- OpenTelemetry OTTL 怎样按条件修改日志属性
- 172浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 | go · 可观测性 · Go OpenTelemetry OTLP otelc 编译期插桩
- OpenTelemetry Go 编译期插桩怎样接入服务
- 348浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- Gemini API 内置 URL Context 怎样处理网页资料
- 204浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- Gemini Interactions API 怎样保存多轮会话状态
- 187浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- Gemini API 函数调用怎样串联多个工具
- 265浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 855次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 859次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 938次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 914次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 744次使用
-
- 量化模型本地推理的显存估算方法
- 2026-10-17 501浏览
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览


