
Java virtual threads 适合阻塞 I/O 的哪些场景
Java virtual threads 最适合的不是“任何并发任务”,而是大量任务大部分时间都在等待阻塞 I/O的服务:例如每个请求都要访问 HTTP 服务、读取文件或执行 JDBC 查询。它能让等待中的 Java 线程以更低的承载成本存在,从而提高整体吞吐;它不会把单个 CPU 计算跑得更快,也不会自动扩大数据库或下游服务的容量。
本文用一个可落地的判断顺序回答“哪些场景适合”:先看等待占比,再看是否能保持同步阻塞的请求模型,接着把连接池和下游配额单独限流,最后用吞吐、延迟、CPU、连接池和 pinning 指标做对比。示例基于 Java 21+ 的 API,配图均为静态说明图,不是运行截图。
- 阻塞 HTTP、JDBC、文件 I/O 占主要时间,并且并发任务很多:优先考虑 virtual threads。
- 纯 CPU 计算、低并发任务或下游资源已是瓶颈:不要期待仅换线程模型就有收益。
- virtual threads 不做线程池;有限资源用连接池自身的上限或 Semaphore 表达。
一、先用等待占比判断,而不是看线程数量
判断适配性时,先把一次请求拆成两类时间:真正占用 CPU 的时间,以及等待网络、数据库、文件或锁的时间。如果请求的大部分生命周期都在等待,并且系统需要同时挂起很多请求,传统平台线程会把大量 OS 线程长期占住;virtual thread 则可以在阻塞 I/O 时暂时脱离 carrier thread,让 carrier 承载别的 virtual thread。
这解释了它最典型的适用场景:同步的“一请求一任务”服务。代码仍然可以按调用顺序执行 HTTP 客户端和 JDBC 查询,读起来像普通同步代码,但大量等待任务不必各自长期占据一个平台线程。Oracle 的官方指南也把这种模式概括为:virtual threads 适合高吞吐、等待时间占比高的服务,而不是长时间 CPU 密集型工作。
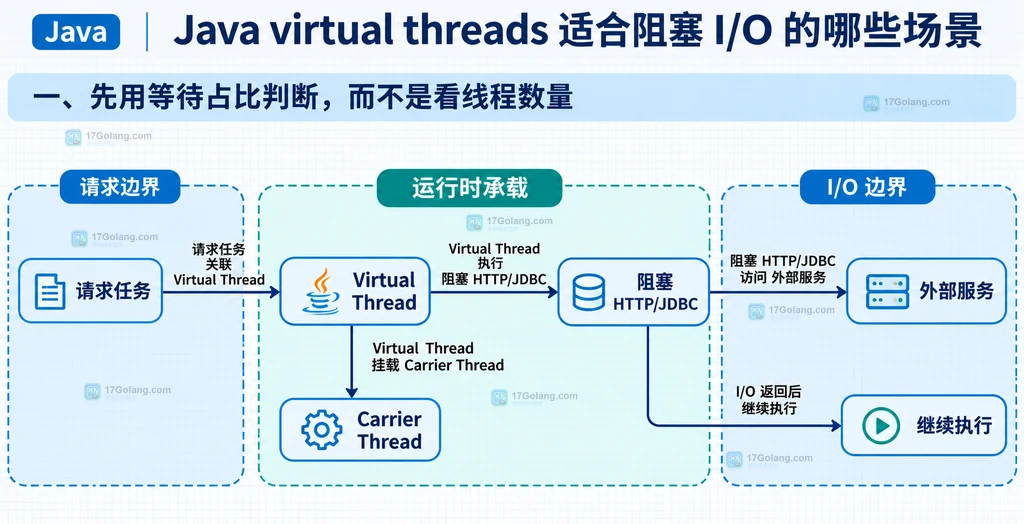
可以用下面的表格先做粗筛:
| 工作类型 | 等待占比 | virtual threads 的预期 | 优先关注 |
|---|---|---|---|
| HTTP 聚合、JDBC 查询、文件读写 | 高 | 提高并发承载和整体吞吐 | 连接池、超时、下游配额 |
| 大量短任务但几乎全是 CPU 计算 | 低 | 通常不是主要收益来源 | CPU 并行度、算法、批处理 |
| 低并发后台任务 | 不确定 | 收益可能小于迁移成本 | 真实负载和可观测性 |
二、把一个请求映射成一个 virtual thread
Java 21 提供了 Executors.newVirtualThreadPerTaskExecutor()。它为每个提交的任务创建一个 virtual thread,而不是维护一个等待复用的 virtual thread 池。对阻塞 I/O 服务来说,任务就是更合适的抽象:每个请求、每个短生命周期的 fan-out 调用,都可以直接成为一个任务。
import java.util.concurrent.ExecutionException;
import java.util.concurrent.Executors;
import java.util.concurrent.Future;

public final class ProfileLoader {
    public String load(String userId) throws Exception {
        try (var executor = Executors.newVirtualThreadPerTaskExecutor()) {
            // 两个独立的阻塞 I/O 调用各自代表一个并发任务。
            Future profile = executor.submit(() -> fetchProfile(userId));
            Future orders = executor.submit(() -> fetchOrders(userId));

            try {
                // get 只等待结果,不把业务改写成回调链。
                return profile.get() + "\n" + orders.get();
            } catch (ExecutionException ex) {
                // 保留下游异常的 cause,便于定位具体 I/O 失败。
                throw new IllegalStateException("加载用户资料失败", ex.getCause());
            } catch (InterruptedException ex) {
                // 恢复中断标记,避免吞掉上层的取消信号。
                Thread.currentThread().interrupt();
                throw ex;
            }
        }
    }

    private String fetchProfile(String userId) {
        // 这里代表阻塞 HTTP 调用,实际项目应复用已配置超时的客户端。
        return "profile:" + userId;
    }

    private String fetchOrders(String userId) {
        // 这里代表阻塞 JDBC 或 HTTP 调用,不表示已在本地执行。
        return "orders:" + userId;
    }
}
这段写法的重点不是把固定线程池替换成另一个固定大小的池,而是让并发任务直接对应 virtual thread。ExecutorService 用 try-with-resources 关闭时,会等待提交的任务结束;对于 fan-out 场景,这个生命周期边界比散落的线程管理更清楚。
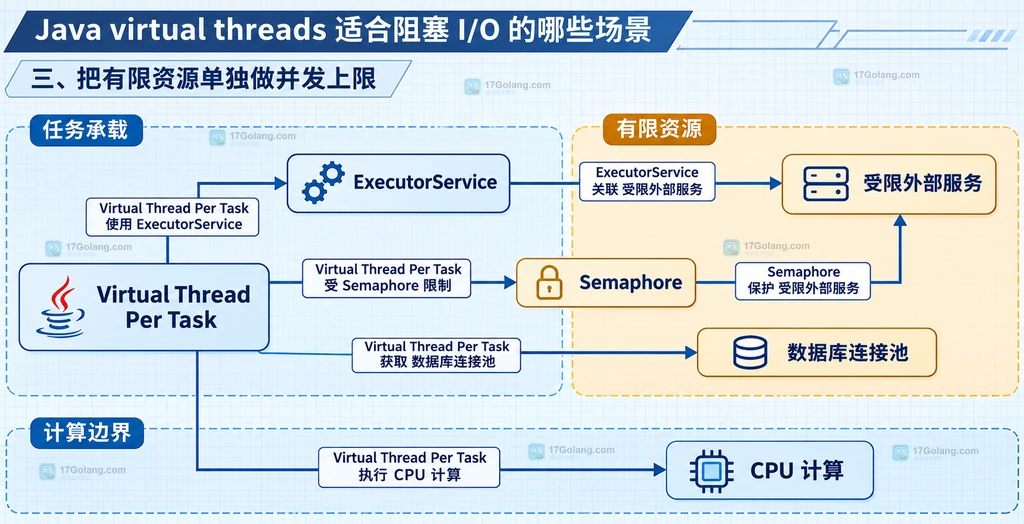
三、把有限资源单独做并发上限
virtual thread 很便宜,并不意味着数据库、第三方 API 或 CPU 也变得无限。线程池经常被误用来同时表达“执行任务”和“限制下游并发”两件事。迁移后应拆开:任务继续用 virtual thread 表达;连接数由数据库连接池表达;外部服务的固定配额用 Semaphore 表达。
import java.util.concurrent.Semaphore;

public final class PartnerClient {
    // 只限制合作方的并发访问,不限制整个应用创建任务。
    private final Semaphore partnerSlots = new Semaphore(20);

    public String call(String request) throws InterruptedException {
        partnerSlots.acquire();
        try {
            // 这里代表可能阻塞的 HTTP 调用;等待时只阻塞当前 virtual thread。
            return blockingHttpCall(request);
        } finally {
            // 无论调用成功还是失败,都必须归还合作方配额。
            partnerSlots.release();
        }
    }

    private String blockingHttpCall(String request) {
        // 示例只表达资源边界,不伪造真实网络返回值。
        return "response:" + request;
    }
}
如果瓶颈是数据库连接,连接池本身已经是一个资源闸门,不要在它外面盲目再套一层同样大小的线程池。更重要的是检查连接获取、查询执行和结果读取是否都有明确超时;virtual thread 只能降低等待线程的成本,不能修复下游慢查询或连接泄漏。
四、用指标验证吞吐收益和代价
“适合”不能只凭代码感觉判断。建议固定请求数据、下游响应时间和连接池上限,分别压测平台线程版本与 virtual thread 版本,至少观察以下指标:
- 吞吐量:单位时间完成的请求数,最能体现等待型服务是否扩大了承载规模。
- 延迟分位数:比较 p50、p95、p99,避免平均值掩盖排队和下游抖动。
- CPU 与堆:virtual thread 不是免费资源,任务数、栈和上下文数据仍会占用 JVM 内存。
- 连接池等待:如果请求线程都卡在连接池,继续增加 virtual threads 只会增加排队任务。
- 调度与 pinning:用 JFR 的
jdk.VirtualThreadPinned事件和 JDK 的线程观测命令定位 carrier 未释放的情况。
结果应写成“在固定负载下,吞吐和资源曲线发生了什么”,不要把官方示例或经验值包装成本机压测数据。尤其要区分吞吐与延迟:virtual threads 的目标是提高高并发等待场景的吞吐,不承诺让单个请求的网络往返更快。
# 用 JFR 记录运行期间的 virtual thread 事件,Application 替换为实际启动类。
java -XX:StartFlightRecording:dumponexit=true,filename=recording.jfr Application

# 从录制文件中查看 pinning 事件,重点关注持续时间较长的记录。
jfr print --events jdk.VirtualThreadPinned recording.jfr
五、识别不适合直接迁移的边界
有几类场景不应把“能创建 virtual thread”误判为“应该迁移”:第一,长时间 CPU 密集计算仍受 CPU 核数限制,应优先优化算法和并行度;第二,阻塞发生在 native/foreign function 或不合适的同步临界区时,virtual thread 可能被 pin 到 carrier,削弱可扩展性;第三,ThreadLocal 中缓存昂贵可变对象的旧习惯,可能在大量 virtual threads 下放大内存消耗;第四,下游容量已经是瓶颈时,需要限流、超时和降级,而不是无限创建任务。
迁移时还要检查框架和驱动是否真正使用可被 JDK 调度器处理的阻塞 API,并用实际指标确认。不要为了“用上新特性”把原本已经稳定的异步模型和同步阻塞模型混在一条调用链里;混合后若缺少清晰的取消、超时和资源边界,排障成本可能反而上升。
总结
Java virtual threads 适合“任务很多、每个任务大部分时间在等待阻塞 I/O、代码可以保持一请求一任务”的场景。落地时用 newVirtualThreadPerTaskExecutor() 表达任务,用数据库连接池和 Semaphore 表达稀缺资源,再用吞吐、延迟、CPU、堆、连接池等待和 pinning 事件判断收益。它提升的是并发规模和吞吐空间,不是 CPU 速度,也不是下游容量。
官方资料:https://openjdk.org/jeps/444;https://docs.oracle.com/en/java/javase/26/core/virtual-threads.html;https://docs.oracle.com/en/java/javase/21/docs/api/java.base/java/util/concurrent/Executors.html
相关问题
virtual threads 会让单个 HTTP 请求更快吗?
不一定。它主要减少等待期间对平台线程的占用,目标是提高高并发服务的整体吞吐;网络 RTT、下游处理时间和 CPU 计算本身不会因为换线程类型自动变短。
使用 virtual threads 还需要线程池吗?
不要把 virtual threads 再做成共享线程池。可以使用 ExecutorService 管理每任务创建的 virtual thread;若要限制合作方或数据库等有限资源,应使用 Semaphore 或资源池自身的容量。
如何发现 virtual thread 被 pin 住?
可以结合 JFR 的 jdk.VirtualThreadPinned 事件与 JDK 的线程观测命令,检查 native/foreign 调用或阻塞同步区是否长期占住 carrier。
 Java Stream Gatherers 怎样实现自定义流聚合
- 上一篇
- Java Stream Gatherers 怎样实现自定义流聚合
- 下一篇
- Java Locale.forLanguageTag 怎样解析 BCP 47 语言标签
-
- 文章 · java教程 | 13分钟前 | Java · 线程池 · 并发编程 · java 线程池 ExecutorService shutdownnow 任务中断
- Java ExecutorService shutdownNow 怎样处理未完成任务
- 103浏览 收藏
-
- 文章 · java教程 | 15分钟前 |
- Java Pattern UNICODE_CHARACTER_CLASS 怎样影响匹配
- 305浏览 收藏
-
- 文章 · java教程 | 16分钟前 |
- Java BigInteger.modInverse 为什么会抛 ArithmeticException
- 159浏览 收藏
-
- 文章 · java教程 | 34分钟前 | 字符串 · java 字符串处理 function String.transform
- Java String.transform 怎样把文本处理交给函数
- 257浏览 收藏
-
- 文章 · java教程 | 37分钟前 | 版本迁移 · Java 25 预览特性 --enable-preview --release
- Java 25 升级后怎样检查预览特性开关
- 439浏览 收藏
-
- 文章 · java教程 | 40分钟前 | java 数值范围 Math.clamp 边界处理
- Java Math.clamp 怎样把数值限制在指定范围
- 176浏览 收藏
-
- 文章 · java教程 | 43分钟前 |
- Java URI.create 怎样解析相对 URI 并处理非法输入
- 388浏览 收藏
-
- 文章 · java教程 | 59分钟前 | Java · 输入校验 · java 国际化 BCP 47 语言标签 Locale.forLanguageTag
- Java Locale.forLanguageTag 怎样解析 BCP 47 语言标签
- 280浏览 收藏
-
- 文章 · java教程 | 1小时前 |
- Java Stream Gatherers 怎样实现自定义流聚合
- 439浏览 收藏
-
- 文章 · java教程 | 1小时前 |
- Java Double.isFinite 怎样判断计算结果是否为有限值
- 461浏览 收藏
-
- 文章 · java教程 | 1小时前 |
- Java StackWalker 怎样获取调用者类
- 105浏览 收藏
-
- 文章 · java教程 | 1天前 | Java · java httpclient completablefuture sendAsync
- Java HttpClient 怎样用 sendAsync 读取异步响应
- 468浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 857次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 860次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 938次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 918次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 747次使用
-
- Go Java 算法之字符串解码示例详解
- 2023-01-07 479浏览
-
- Go Java算法之单词搜索示例详解
- 2022-12-30 337浏览
-
- Gojava算法之括号生成示例详解
- 2023-02-22 128浏览
-
- GoJava算法之累加数示例详解
- 2023-01-07 149浏览
-
- GoJava算法最大单词长度乘积示例详解
- 2023-01-12 202浏览