
Java Double.isFinite 怎样判断计算结果是否为有限值
我在处理统计比例、评分和金额换算时,最容易忽略的不是小数位数,而是一次计算已经变成了 NaN 或正负无穷。它们仍然是合法的 double 值,却不一定能继续进入业务字段、日志指标或序列化结果。Java 里可以把 Double.isFinite(value) 放在计算结果边界:返回 true 才继续使用,返回 false 就转入拒绝、降级或记录原因的分支。
官方地址:https://docs.oracle.com/en/java/javase/25/docs/api/java.base/java/lang/Double.html#isFinite(double)
语言规范:https://docs.oracle.com/javase/specs/jls/se25/html/jls-4.html
这篇只解决有限值判断和结果分流,不讨论浮点数精度理论,也不把示例代码描述成已经在本机运行过的结果。
Double.isFinite 到底判断什么
Double.isFinite(double) 是静态方法。参数是有限浮点数时返回 true;参数是 NaN、Double.POSITIVE_INFINITY 或 Double.NEGATIVE_INFINITY 时返回 false。它的价值在于把“能否作为普通数值继续传递”表达成一个明确的边界。
| 输入 | Double.isFinite | 更具体的判断 | 常见业务动作 |
|---|---|---|---|
| 普通有限值 | true | 不是 NaN,也不是 Infinity | 继续计算或保存 |
Double.NaN | false | Double.isNaN 为 true | 记录输入或计算原因 |
| 正、负 Infinity | false | Double.isInfinite 为 true | 拒绝、截断或改走降级策略 |
0.0、-0.0 | true | 仍然是有限值 | 按业务规则处理零值 |
这里的“有限”不是“符合业务范围”。例如 1.0E100 仍可能远超订单金额字段允许的范围,但它在 IEEE 754 分类上是有限值。因此通常要先用 isFinite 拦截非有限结果,再用最小值、最大值或业务区间做第二层校验。
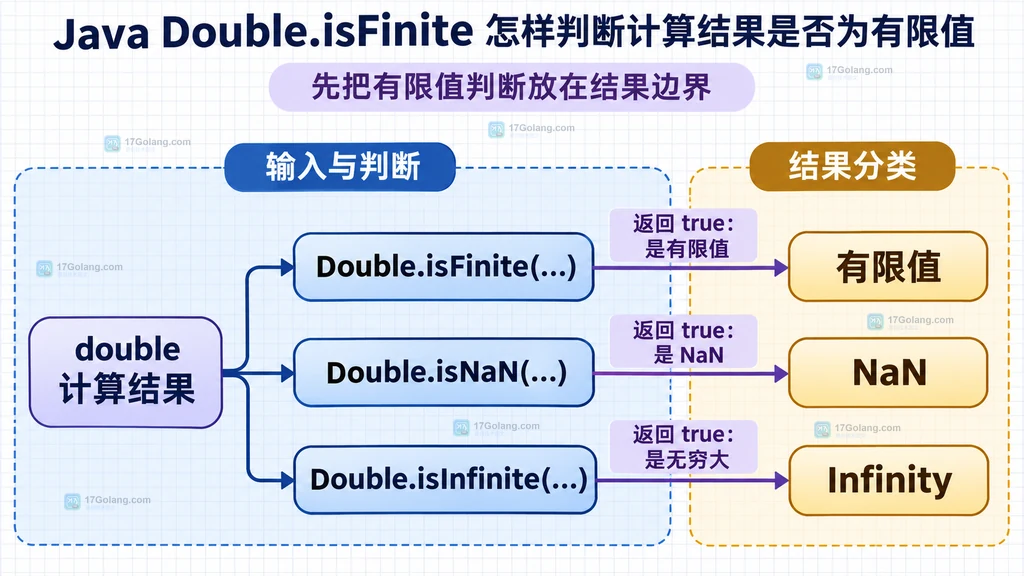
先把有限值判断放在结果边界
我更倾向于让产生结果的方法负责返回一个已经经过有限性判断的值,而不是让每个调用方猜测是否需要检查。这样做的重点不在于多写一个 if,而在于把责任固定在“计算完成、写入下游之前”的位置。
public final class RatioCalculator {
    private RatioCalculator() {
    }

    public static double requireFiniteRatio(double numerator, double denominator) {
        // 先计算原始结果,让 0/0 与非零数除以 0 保留不同的 IEEE 754 语义。
        double value = numerator / denominator;
        // 非有限结果不能继续进入金额、比例或序列化字段。
        if (!Double.isFinite(value)) {
            throw new IllegalArgumentException("比例计算得到非有限值");
        }
        return value;
    }
}
这个边界把两种问题分开了:除法本身产生什么结果由 Java 浮点规则决定,业务是否接受这个结果由 Double.isFinite 决定。调用方不需要再分别判断 NaN 和正负 Infinity,失败原因也集中在一个位置。
如果业务不希望抛异常,也可以让方法返回一个带状态的对象,或返回 OptionalDouble。但无论采用哪种接口,非有限结果都应在进入持久化、消息发送和外部响应之前完成分流。
NaN 和 Infinity 应该怎样区分
Double.isFinite 适合回答“这个结果能不能作为普通有限数继续走”;当需要记录更具体的原因时,再用 Double.isNaN 和 Double.isInfinite。
static String classify(double value) {
    // NaN 不等于自身,不能用 value == Double.NaN 判断。
    if (Double.isNaN(value)) {
        return "NaN:输入或计算结果不可表示";
    }
    // isInfinite 同时覆盖正无穷和负无穷。
    if (Double.isInfinite(value)) {
        return value > 0 ? "正无穷:结果超过上界" : "负无穷:结果低于下界";
    }
    // -0.0 也会走到这里,因为它仍属于有限值。
    return "有限值";
}
最常见的误区是写成 value == Double.NaN。这条比较不会按预期识别 NaN;判断 NaN 应使用 Double.isNaN。Infinity 虽然可以和对应常量比较,但 Double.isInfinite 能直接表达“无论正负都属于无穷”的意图,代码更适合做统一分支。
需要注意的是,有限性判断只描述数值分类,不会告诉你 NaN 是由哪个输入导致的,也不会自动恢复一个合理结果。原因追踪仍应在解析输入和计算入口保留必要的字段。
把非有限结果挡在序列化和统计边界之外
非有限值一旦进入公共 DTO、JSON、CSV 或指标标签,问题就从“一个计算分支”扩散成“多个系统的格式兼容”。不同序列化器和协议对 NaN、Infinity 的支持并不等价,所以更稳妥的做法是在输出适配层前再次确认。
record ScoreResult(double score, boolean accepted, String reason) {
}

static ScoreResult prepareScore(double rawScore) {
    // 先挡住 NaN 和 Infinity,再判断业务允许的分数区间。
    if (!Double.isFinite(rawScore)) {
        return new ScoreResult(0.0, false, "非有限结果");
    }
    // 有限不等于业务合法,这里继续执行范围约束。
    if (rawScore  100.0) {
        return new ScoreResult(rawScore, false, "超出分数范围");
    }
    return new ScoreResult(rawScore, true, "ok");
}
示例把“数值分类”和“业务区间”分成两层:第一层拒绝无法稳定表达的结果,第二层判断有限值是否满足分数范围。这样日志可以区分“计算出了 NaN”和“计算结果是 120 但业务只允许 0 到 100”。
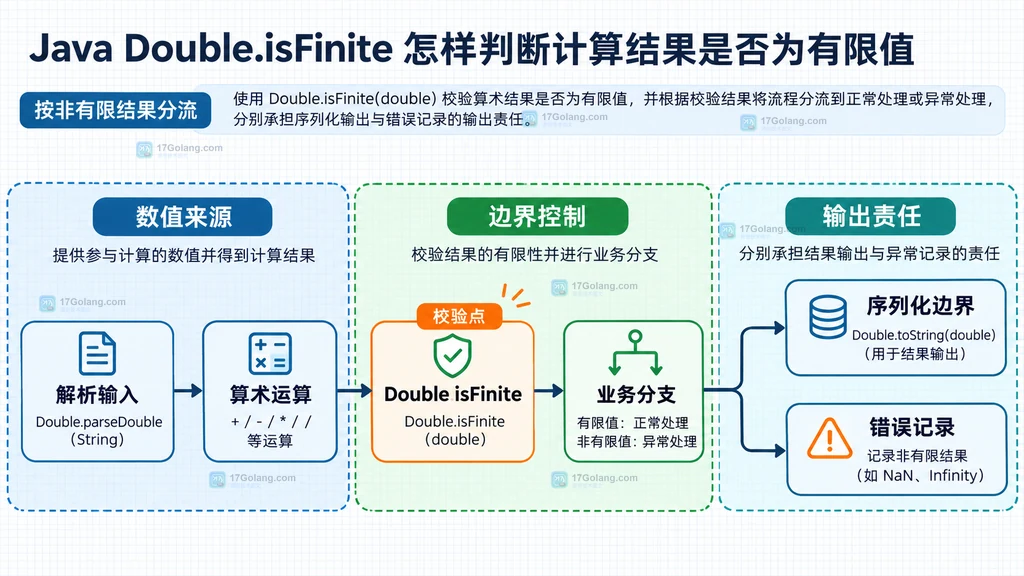
几个容易混淆的边界
- 有限值不等于业务可接受:
Double.isFinite通过后,仍可能需要检查金额精度、比例范围和单位。 - 零除法要保留原因:零除以零可能得到 NaN,非零数除以零可能得到正负 Infinity,统一返回一个“非法数字”会丢掉排查线索。
- 负零是有限值:
-0.0会通过Double.isFinite;如果符号零对展示或算法有影响,应额外处理。 - 不要把 isFinite 当作溢出修复:它只能识别结果,不能恢复溢出前的业务值,也不能替代输入范围和单位校验。
我的落地判断
如果一个 double 结果要跨越方法、线程、消息或存储边界,我会把 Double.isFinite 当作第一道门:通过后再检查业务区间,失败时记录 NaN 或 Infinity 的具体类型,并在输出适配层保留一次保护。这样做的代价很小,却能避免一个特殊浮点值在系统下游才暴露成格式错误或统计异常。
最小选择可以记成一句话:只关心能否继续传递,用 Double.isFinite;要区分原因,用 Double.isNaN 或 Double.isInfinite;要判断业务是否合法,再加范围与单位规则。
Double.isFinite 能判断 BigDecimal 吗?
不能。它的参数是基本类型 double。使用 BigDecimal 时应按十进制数值和业务范围处理,不能先无条件转换为 double 再把精度问题交给 isFinite。
Double.isFinite 返回 true 就一定能写入 JSON 吗?
不一定。true 只说明结果是有限浮点数,序列化格式、字段范围、精度和协议约束仍需要单独满足。
为什么不只判断 Double.isNaN?
因为正负 Infinity 不是 NaN,却同样属于非有限结果。如果目标是拦截所有不能作为普通有限数传递的结果,直接使用 Double.isFinite 更完整。
 Java StackWalker 怎样获取调用者类
- 上一篇
- Java StackWalker 怎样获取调用者类
- 下一篇
- Java Stream Gatherers 怎样实现自定义流聚合
-
- 文章 · java教程 | 19分钟前 | 版本迁移 · Java 25 预览特性 --enable-preview --release
- Java 25 升级后怎样检查预览特性开关
- 439浏览 收藏
-
- 文章 · java教程 | 21分钟前 | java 数值范围 Math.clamp 边界处理
- Java Math.clamp 怎样把数值限制在指定范围
- 176浏览 收藏
-
- 文章 · java教程 | 25分钟前 |
- Java URI.create 怎样解析相对 URI 并处理非法输入
- 388浏览 收藏
-
- 文章 · java教程 | 41分钟前 | Java · 输入校验 · java 国际化 BCP 47 语言标签 Locale.forLanguageTag
- Java Locale.forLanguageTag 怎样解析 BCP 47 语言标签
- 280浏览 收藏
-
- 文章 · java教程 | 43分钟前 | Java · 性能优化 · 并发编程 · java 并发 阻塞I/O Virtual Threads
- Java virtual threads 适合阻塞 I/O 的哪些场景
- 218浏览 收藏
-
- 文章 · java教程 | 50分钟前 |
- Java Stream Gatherers 怎样实现自定义流聚合
- 439浏览 收藏
-
- 文章 · java教程 | 54分钟前 |
- Java StackWalker 怎样获取调用者类
- 105浏览 收藏
-
- 文章 · java教程 | 23小时前 | Java · java httpclient completablefuture sendAsync
- Java HttpClient 怎样用 sendAsync 读取异步响应
- 468浏览 收藏
-
- 文章 · java教程 | 1天前 | Java · 故障排查 · java 死锁排查 jcmd Thread.print 线程栈 Thread.dump_to_file JVM线程
- Java jcmd 怎样查看运行中进程的线程信息
- 452浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Spring WebFlux 怎样限制并发请求的背压范围
- 187浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Spring Boot Actuator 怎样按端点暴露健康信息
- 389浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 857次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 860次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 938次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 918次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 747次使用
-
- Java 时间格式兼容多个输入格式的方法
- 2026-10-18 501浏览
-
- Java try-with-resources 多个资源关闭顺序是什么
- 2026-09-10 501浏览
-
- 矩阵主副对角线快速定位技巧
- 2026-05-31 501浏览
-
- Java多态优化流程代码与行为分发改进
- 2026-05-26 501浏览
-
- JVM 类元数据双亲委派链表深度解析
- 2026-05-21 501浏览