我在解析网络帧和文件头时,最容易先写错的往往不是 Go 代码,而是把“字段占几字节”和“字节按什么顺序解释”混在了一起。固定长度字段要先确定区间,再选择 binary.BigEndian 读取;如果输入来自流,还要把短读和完整读完区分开。
官方文档:https://pkg.go.dev/encoding/binary#ByteOrder
这篇文章只讨论固定长度的整数与结构体字段,不展开完整协议设计。实践上,我会先用切片方式确认协议偏移,再决定是否交给 binary.Read 读取固定尺寸结构体,这样字段边界更容易复盘。
第 1 步:先确定字节序和字段长度
大端序的核心是高位字节放在前面。例如四字节 00 00 01 2c 解释为整数 300。ByteOrder 只负责“怎样解释这些字节”,不会替你判断字段起止位置;偏移和长度仍由协议格式决定。
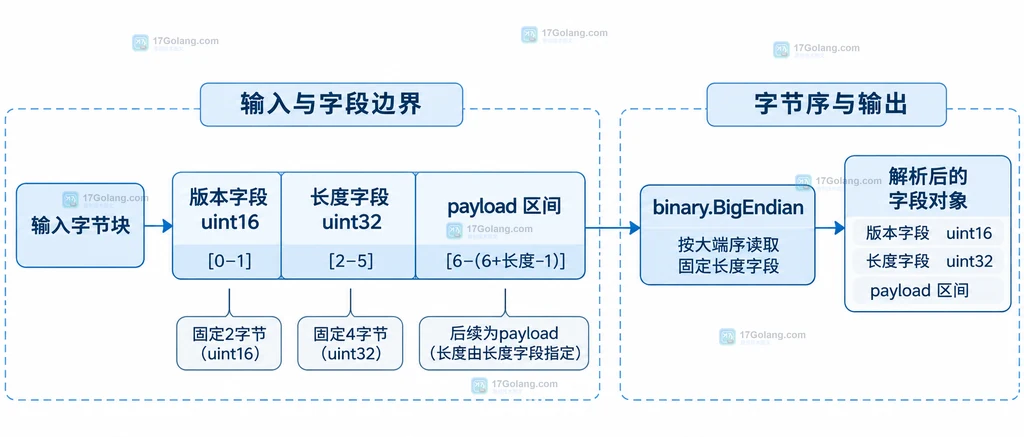
下面假设一个很小的帧头:前 2 字节是版本号,接着 4 字节是 payload 长度。这里的切片边界是示例协议的一部分,不是 encoding/binary 自动推断出来的。
package main

import (
    "encoding/binary"
    "fmt"
)

func main() {
    frame := []byte{0x00, 0x02, 0x00, 0x00, 0x01, 0x2c, 0x68, 0x69}

    version := binary.BigEndian.Uint16(frame[0:2]) // 前 2 字节按大端序读取版本
    payloadLen := binary.BigEndian.Uint32(frame[2:6]) // 接着 4 字节读取长度
    payload := frame[6:] // 剩余区间才是负载,不能把头部重复算进去

    fmt.Println(version, payloadLen, string(payload))
}
这个写法的优点是字段边界显式可见。代价是调用方必须保证切片至少有对应长度,否则切片表达式可能直接触发越界 panic。来自不可信输入时,先做长度判断。
第 2 步:用 ByteOrder 方法读取整数
binary.BigEndian 实现了 ByteOrder,常用读取方法是 Uint16、Uint32 和 Uint64。它们都要求输入切片包含足够字节;这类方法适合字段偏移已经被协议解析器掌握的场景。
func readHeader(buf []byte) (version uint16, payloadLen uint32, err error) {
    if len(buf) < 6 {
        return 0, 0, fmt.Errorf("帧头长度不足: got=%d want=6", len(buf)) // 先挡住切片越界
    }

    version = binary.BigEndian.Uint16(buf[0:2]) // 固定长度字段使用对应的字节区间
    payloadLen = binary.BigEndian.Uint32(buf[2:6]) // 大端序决定数值解释方式
    return version, payloadLen, nil
}
我通常把“长度检查”和“数值读取”放在同一个小函数里。这样后续接入 TCP、文件或消息队列时,调用方只需要处理一个明确的错误,不会在业务层散落多个魔法偏移。
第 3 步:用 binary.Read 读取固定结构
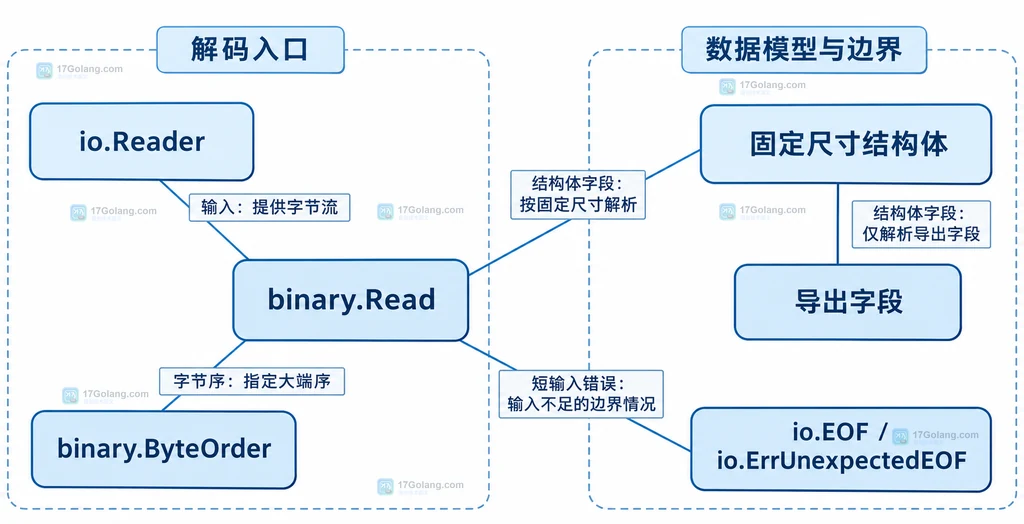
当字段都是固定尺寸,并且顺序与 Go 结构体一致时,可以用 binary.Read 直接解码。官方文档说明,目标应是固定尺寸值、固定尺寸切片,或者指向这类值的指针;结构体中的非空白字段需要导出。
type header struct {
    Version uint16 // 导出字段才能被 binary.Read 写入
    Flags   uint16 // 固定宽度字段保持协议布局稳定
    Length  uint32 // 大端序下占用 4 个字节
}

func decodeHeader(r io.Reader) (header, error) {
    var h header
    if err := binary.Read(r, binary.BigEndian, &h); err != nil {
        return header{}, fmt.Errorf("读取帧头失败: %w", err) // 保留底层 EOF 类型供上层判断
    }
    return h, nil
}
这里的关键不是结构体名称,而是内存布局必须能被 encoding/binary 明确计算。不要把字符串、切片、指针或带不确定长度的字段直接塞进这个结构体;变长 payload 应在头部读取完成后,按长度单独读取。
第 4 步:处理短输入和字段边界
手工调用 Uint32 时,先判断切片长度。使用 binary.Read 读取流时,则要区分“一个字节都没读到”和“读到一半就结束”:前者通常是 io.EOF,后者是 io.ErrUnexpectedEOF。上层可以据此判断是正常结束,还是截断帧。
func readExactHeader(r io.Reader) (header, error) {
    var h header
    err := binary.Read(r, binary.BigEndian, &h)
    if err == io.EOF {
        return header{}, err // 流在读取前结束,可按调用协议判断是否正常
    }
    if errors.Is(err, io.ErrUnexpectedEOF) {
        return header{}, fmt.Errorf("帧头被截断: %w", err) // 已读到部分字段,不能当作空流
    }
    if err != nil {
        return header{}, fmt.Errorf("帧头解码失败: %w", err) // 保留其它 I/O 错误
    }
    return h, nil
}
如果长度字段来自外部输入,还需要在读取 payload 前判断它是否超过业务允许范围,并确认剩余数据确实足够。字节序正确并不等于输入可信,字段边界仍然是协议层的责任。
第 5 步:按场景选择读取方式
| 场景 | 建议 | 原因 |
|---|---|---|
| 已知偏移的少量整数 | binary.BigEndian.Uint16/32/64 | 边界显式,适合解析头部字段 |
| 连续固定字段组成的结构体 | binary.Read | 把字段顺序集中在数据模型中 |
| 已有完整字节缓冲区并希望控制消费量 | binary.Decode | 按缓冲区返回消费字节数,适合明确的切片输入 |
| 变长字符串或 payload | 先读长度,再单独处理 | 避免把不定长内容误当成固定尺寸字段 |
我的取舍是:协议头越短、字段越少,越倾向于手工切片;字段逐渐增多且布局固定时,再把它们收拢到结构体。这样既能保留偏移可读性,也不会让每个字段都重复写边界检查。
常见问题
大端序和网络字节序是一回事吗?
在常见网络协议语境里,网络字节序通常指大端序,但最终仍应以具体协议定义为准。binary.BigEndian 只表达大端解释,不会替你确认协议约定。
为什么结构体字段要大写?
binary.Read 读取结构体时,非空白字段需要导出;使用小写字段可能无法按预期写入。需要填充时,可以用空白字段名表达固定尺寸的跳过区域。
读取 payload 能不能继续用 binary.Read?
如果 payload 本身也是固定尺寸结构,可以继续使用;如果它是变长文本或字节流,建议根据已读出的长度做上限判断,再使用明确的读取策略。
总结
按大端序解析固定长度字段可以拆成三件事:先明确字段区间,再用 binary.BigEndian 解释数值,最后根据输入来源处理短数据。少量头部字段用 Uint16/32/64 更直观,连续固定布局用 binary.Read 更集中;无论哪种方式,都不要把字节序判断和输入边界检查省略掉。
 Go encoding/hex.InvalidByteError 怎样定位非法十六进制字符