Go fuzz 测试怎样读取生成的种子参数
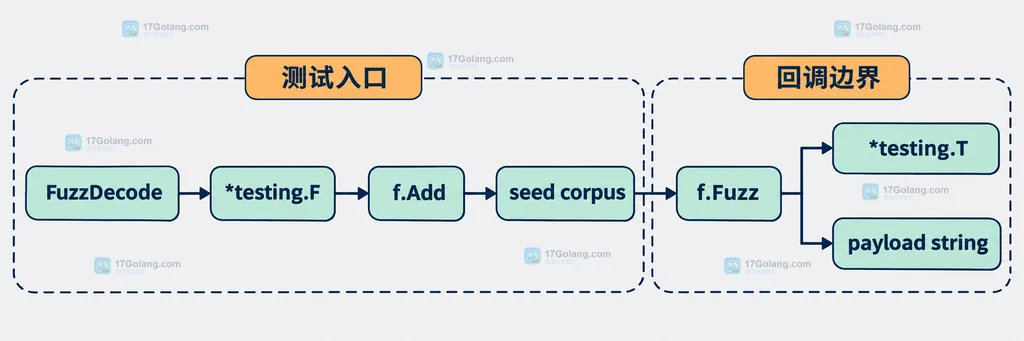
我第一次把 Go fuzz 测试接进一个解析函数时,最容易混淆的一点是:f.Add 放进去的种子值,并不是之后再从 *testing.F 里取出来的配置。真正接收种子值和 fuzz 引擎新输入的位置,是 f.Fuzz 注册的回调函数参数。
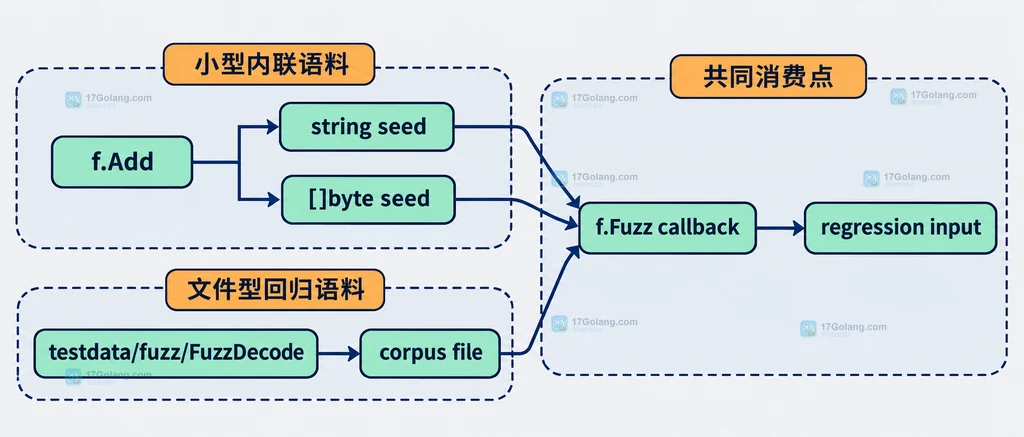
因此可以先记住一句话:种子参数由回调参数直接读取,f.Add 只负责把初始样本加入 seed corpus。小参数适合写在 f.Add 中;大块二进制或失败后留下的回归样本,则适合放到 testdata/fuzz/FuzzXxx。两条路径最后都会进入同一个 fuzz 回调。
官方地址:https://go.dev/doc/security/fuzz/
如果你的问题是“怎样读取 Go fuzz 生成的种子参数”,答案不是调用某个读取 API,而是在f.Fuzz(func(t *testing.T, 参数...) { ... })中声明并使用参数。f.Add和语料文件中的类型、顺序必须与这些参数一致。
我先把“种子”与“回调参数”分开
Go 的 fuzz 测试有两个容易被混在一起的层次:
- 语料层:
f.Add和testdata/fuzz/FuzzXxx提供初始输入,组成 seed corpus。 - 执行层:
f.Fuzz接收一个回调,回调中声明的参数就是当前这一次调用拿到的输入。
默认执行 go test 时,种子语料会先作为普通测试样本跑过回调;使用 go test -fuzz=FuzzDecode 时,Go 才会在基线覆盖率之后继续生成和变异输入。无论输入来自手写种子还是 fuzz 引擎,回调的读取方式都不变。
最小写法:在 f.Fuzz 回调里直接接收参数
下面用一个只关心输入长度的例子说明读取位置。f.Add 提供一个字符串种子,回调的第二个参数 input 就是本次测试实际收到的值。第一个参数必须是 *testing.T,后面的参数才对应要 fuzz 的类型。
package decoder

import (
    "strings"
    "testing"
)

func FuzzTrimmedToken(f *testing.F) {
    // 这个值进入种子语料库,但不会通过 f 再读取一次。
    f.Add("  go-fuzz  ")

    // input 就是当前种子或引擎生成的字符串参数。
    f.Fuzz(func(t *testing.T, input string) {
        trimmed := strings.TrimSpace(input)
        // 断言和日志应使用本次回调的 t,不要在回调里操作外层的 *testing.F。
        if strings.Contains(trimmed, "\\x00") {
            t.Fatalf("输入包含不允许的空字符: %q", trimmed)
        }
    })
}
这里没有 f.Get、f.Read 之类的步骤。每次回调开始时,input 已经是 Go 测试框架传入的当前参数。把它传给解析函数、做断言或用 t.Logf 记录,都是“读取种子参数”的正常方式。
f.Add 的参数怎样和回调一一对应
f.Add 可以添加多个参数,但必须和回调的 fuzzing arguments 保持数量、类型、顺序一致。回调里的 *testing.T 不算在 f.Add 的参数列表里。
func FuzzPacket(f *testing.F) {
    // 三个种子字段分别对应 payload、version、compressed。
    f.Add([]byte("hello"), int64(1), false)

    f.Fuzz(func(t *testing.T, payload []byte, version int64, compressed bool) {
        // 当前调用的三个 fuzz 参数直接来自这三个回调变量。
        if version < 0 {
            t.Skip("负版本号不属于这个协议的输入域")
        }
        if compressed && len(payload) == 0 {
            t.Log("压缩标志为真但载荷为空,交给解析器决定是否接受")
        }
    })
}
如果把回调改成 (t *testing.T, version int64, payload []byte, compressed bool),即使变量名称看起来合理,也已经改变了位置关系。种子和文件语料仍然按原顺序提供,结果就会在注册或运行时暴露不匹配。
可用的基础类型包括字符串、字节切片、布尔值、整数和浮点数等。不要把自定义结构体指针直接当成 fuzz 参数;需要测试结构化数据时,通常把它编码成 []byte 或 string,再在回调中解析。
在回调里判断输入,别把状态带到下一次调用
fuzz 回调会被重复调用,调用顺序也可能是不确定的。我的经验是把“输入读取、解析、判断、必要日志”都放在一次回调里,避免把当前参数写进包级变量、共享切片或异步任务中。官方文档也要求 fuzz target 尽量快速、确定,并且不要依赖跨调用的全局状态。
func FuzzDecodeHeader(f *testing.F) {
    // 用一个合法的最小头部作为回归起点。
    f.Add([]byte{0x47, 0x4f, 0x01})

    f.Fuzz(func(t *testing.T, data []byte) {
        // data 只在本次调用中使用,不保存底层切片引用。
        header, err := decodeHeader(data)
        if err != nil {
            // 模糊测试允许解析器拒绝输入,只有违反不变量时才失败。
            return
        }
        if header.Version == 0 {
            t.Errorf("已接受的头部不能使用零版本")
        }
    })
}
尤其要注意 []byte:不要把回调收到的切片直接保存到下一次调用还要使用的缓存里,也不要把它交给可能异步持有的 goroutine。若业务确实需要跨边界保存,应在回调内复制数据,并明确这已经不再是“直接读取当前 fuzz 参数”。
默认 go test 和 -fuzz 的读取体验有什么区别
两种命令都使用同一个 f.Fuzz 回调,区别在于输入来源和运行时长:
| 命令 | 会读取什么 | 适合用途 |
|---|---|---|
go test | 先执行 f.Add 和目录语料里的每个条目 | 快速回归,确认种子参数能被正确接收 |
go test -fuzz=FuzzDecode -fuzztime=30s | 先跑种子,再让引擎生成和变异新的参数 | 探索种子没有覆盖到的边界 |
go test -run=FuzzDecode/哈希 | 只重放一个失败语料条目 | 修复问题后的回归确认 |
因此,如果你只是想确认手写种子有没有传进来,先用默认 go test 就够了;如果你要观察生成输入,则在回调中记录当前参数的摘要或关键字段,再使用 -fuzz。不要把“开启 fuzz”误解成需要另一套读取 API。
# 先只跑种子语料,验证回调签名和初始输入
go test -run=^$ ./...

# 在指定 fuzz target 中继续生成输入,并限制本次探索时长
go test -fuzz=FuzzPacket -fuzztime=30s ./...
失败输入怎样变成下一次可读取的种子
当 fuzz 发现失败输入并完成最小化后,Go 会把它写入对应 fuzz 测试的 testdata/fuzz/FuzzXxx 目录。这个文件不是普通文本样例,而是带有 fuzz corpus 编码的语料条目;其中每个字段仍然必须与回调参数的类型和顺序一致。
go test fuzz v1
[]byte("hello\\xbd\\xb2=\\xbc ⌘")
int64(572293)
下次运行默认 go test 时,这个失败输入会作为回归种子重新传进同一个回调。也就是说,失败文件被写入语料目录后,读取方式并没有变化:仍然是回调里的 payload []byte、version int64 等变量。
f.Add 还是 testdata/fuzz:我会这样选
这两种方式不是二选一的“不同 fuzz API”,而是两种语料管理入口。小而稳定、读者一眼能看懂的参数适合 f.Add;大块二进制、字符编码边界或已经发现的失败样本,更适合单独放在 testdata/fuzz/FuzzXxx 中。
| 情况 | 推荐入口 | 原因 |
|---|---|---|
| 短字符串、少量整数、协议最小样例 | f.Add | 和 fuzz 函数放在一起,审查和修改直接 |
| 大块二进制、复杂编码样本 | testdata/fuzz/FuzzXxx | 避免测试源码膨胀,也便于保留原始 corpus |
| fuzz 发现的失败输入 | 让 Go 写入 fuzz 目录 | 自动进入后续默认回归测试 |
无论选择哪条入口,最终都要回到同一个检查点:文件语料中的字段类型和顺序,是否与 f.Fuzz 的参数完全一致。只要这一点成立,回调就能以同样的方式读取手写种子、文件种子和引擎生成的值。
几个我会避开的误区
- 误区一:从
*testing.F读取当前参数。*testing.F用来注册 fuzz 目标和种子;当前值由回调参数提供。 - 误区二:只检查
f.Add的值。 持续 fuzz 还会传入引擎生成的值,业务不变量必须对所有回调输入成立。 - 误区三:把任何解析错误都判为测试失败。 fuzz 输入本来就可能非法;应先定义哪些错误是可接受的,哪些错误代表代码不变量被破坏。
- 误区四:在回调外保存可变输入。 尤其是
[]byte,不要跨调用保留底层引用或依赖调用顺序。 - 误区五:用文件语料绕过类型约束。 corpus 文件只是另一种输入载体,编码后的字段仍然要和回调参数一一对应。
最后的判断清单
- 确认 fuzz 函数形如
FuzzXxx(f *testing.F),并且只注册一个f.Fuzz目标。 - 确认
f.Add的参数不包含*testing.T,且和回调的 fuzz 参数数量、类型、顺序一致。 - 确认当前输入只从回调变量读取,断言和日志使用回调里的
*testing.T。 - 先用
go test回归种子,再按需要使用-fuzz探索新输入。 - 发现失败输入后保留
testdata/fuzz/FuzzXxx条目,让修复后的默认测试继续覆盖它。
相关问题
f.Add 的参数和 f.Fuzz 回调参数必须完全一样吗?
必须保持数量、类型和顺序一致;回调最前面的 *testing.T 不计入这组 fuzz 参数。
生成的新输入能在 f.Fuzz 外面读取吗?
通常不应该这样设计。把处理逻辑放在回调内,输入就是回调参数;如果需要复现具体失败值,应使用 Go 写入的 fuzz corpus 条目或命令输出中的复现路径。
为什么种子参数是 []byte 还要小心保存?
fuzz 引擎会重复调用回调,输入底层存储不适合被跨调用持有或异步修改。需要长期保存时,在当前回调中复制并明确所有权。
 Go encoding/binary 怎样按大端序解析固定长度字段