
Go atomic.Value 存储配置快照的类型约束
我第一次把进程内配置从 sync.RWMutex 攧到 atomic.Value,出发点很朴素:读取发生在每个请求上,更新却可能几分钟才来一次。真正迁移时,最先遇到的并不是性能,而是一次 panic: sync/atomic: store of inconsistently typed value into Value。原因是初始化存了 Config,热更新却存了 *Config。
这件事让我把 atomic.Value 看成一个“首个 Store 决定类型”的发布槽。它能原子地替换一个接口值,但不会替你深拷贝 map、slice,也不会把运行时类型错误变成编译错误。只有把类型一致、非空初始化和快照不可变三件事同时做好,读路径才真正简单。
官方地址:https://pkg.go.dev/sync/atomic#Value
- 第一次成功 Store 会固定具体动态类型;后续类型不一致或直接 Store(nil) 都会 panic。
- 推荐统一存
*Config,构造函数立即放入非空初始快照,之后只通过封装入口更新。 - 原子发布只保护快照引用的替换;map、slice 等可变字段必须在 Store 前深拷贝,发布后只读。
先把第一次 Store 当成类型契约
官方文档对 Value 的描述很明确:它提供“类型一致”的原子 Load 与 Store;零值在尚未 Store 时,Load 返回 nil;第一次 Store 后,Value 不能再复制。对同一个 Value 的所有 Store 必须使用相同的具体类型,类型不一致或 Store(nil) 都会 panic。
这里比较的是接口值里的具体动态类型,不是字段是否相同。Config 与 *Config 是两种类型;两个字段完全相同、名字不同的结构体类型也不是同一类型。因此,我会把第一次 Store 放进构造函数,并把 Value 留在不导出的字段里。
| 写入方式 | 结果 | 建议 |
|---|---|---|
| 首次 Store(&Config{}) | 后续类型固定为 *Config | 推荐作为初始化方式 |
| 之后 Store(Config{}) | 类型不一致,panic | 不要混用值和指针 |
| Store(nil) | 直接 panic | 用构造函数保证初值 |
| Store((*Config)(nil)) | 类型一致但 Load 得到空指针 | 合法但危险,应拒绝 |
用一个封装固定所有读写入口
下面的封装只允许保存非空 *Config。初始化和更新都会复制输入,调用方拿到的对象按只读快照使用。这样既避免零值 Load 的分支扩散,也把类型断言集中在一个地方。
package config

import (
	"errors"
	"sync/atomic"
)

type Config struct {
	Version   uint64
	Endpoints []string
	Limits    map[string]int
}

type Store struct {
	current atomic.Value // 从第一次写入开始始终保存 *Config。
}

func NewStore(initial *Config) (*Store, error) {
	if initial == nil {
		return nil, errors.New("initial config is nil")
	}
	s := &Store{}
	s.current.Store(cloneConfig(initial)) // 首次 Store 锁定具体类型 *Config。
	return s, nil
}

func (s *Store) Load() *Config {
	return s.current.Load().(*Config) // 构造函数已保证完成首次写入。
}

func (s *Store) Store(next *Config) error {
	if next == nil {
		return errors.New("next config is nil")
	}
	s.current.Store(cloneConfig(next)) // 始终写入同一具体类型。
	return nil
}
不要在 Value 第一次使用后复制 Store 实例。最直接的做法是让构造函数返回指针,业务层也只传递 *Store。如果结构体需要嵌入到更大的组件中,同样应通过指针共享,而不是按值复制。
原子替换不等于深度不可变
Store 与 Load 能保证发布槽的替换是原子的。Go 内存模型还规定,原子操作表现为顺序一致;当读取观察到新值时,构建新快照时已经完成的写入对读者可见。但这并不允许发布后继续修改新快照内部的 map 或 slice。
如果写者 Store 之后仍然执行 next.Limits["upload"] = 20,而读者正在访问同一个 map,仍可能发生数据竞态。解决办法不是再加一个零散的锁,而是把“构建区”和“只读区”彻底分开:复制所有引用字段,完成校验,然后一次发布。
func cloneConfig(src *Config) *Config {
	dst := &Config{
		Version:   src.Version,
		Endpoints: append([]string(nil), src.Endpoints...), // 复制 slice 底层数组。
		Limits:    make(map[string]int, len(src.Limits)),
	}
	for name, limit := range src.Limits {
		dst.Limits[name] = limit // 复制 map,避免发布后共享写入。
	}
	return dst
}
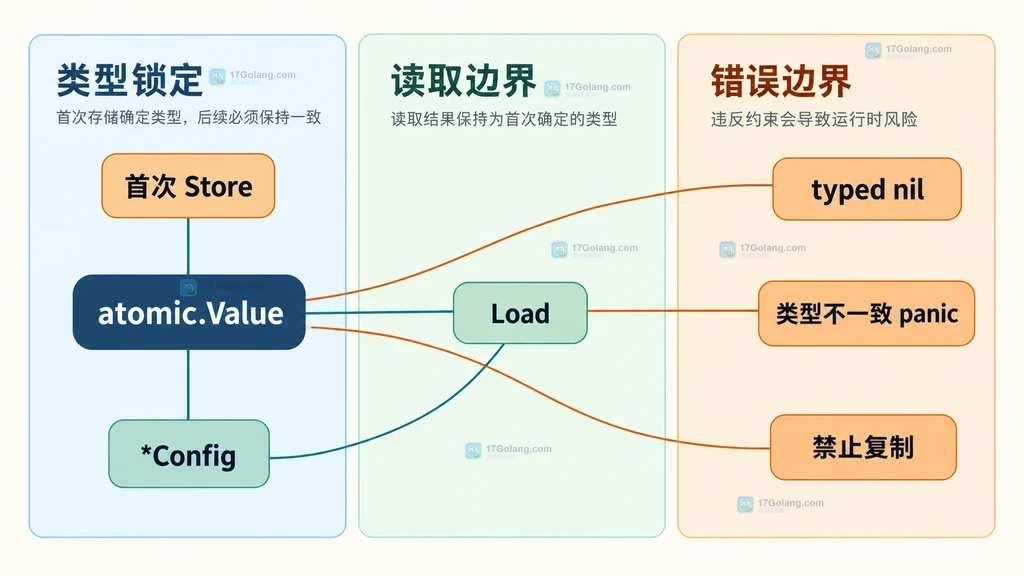
图中的静态连线强调所有权:cloneConfig 在构建区创建独立的 *Config,其中 Endpoints 与 Limits 不再引用调用方的底层数据;发布后,Readers 只读取。若字段里还有嵌套指针、map 的值也是结构体指针,复制函数也要继续向下复制。
类型陷阱集中处理,不让 panic 漏到热更新
最隐蔽的是 typed nil。下面的 p 虽然是空指针,但放进接口后携带具体类型 *Config,所以 Store(p) 不等于 Store(nil),不会因为 nil 接口而 panic;后续 Load 却会得到空指针。对配置快照来说,这种状态几乎没有价值,应在入口拒绝。
var value atomic.Value
var p *Config

value.Store(p)              // 合法:接口的具体类型是 *Config,但其中指针为空。
loaded := value.Load().(*Config)
if loaded == nil {
	// 业务层会在解引用时失败,因此封装入口应提前拒绝 typed nil。
}
另一个不适合的工具是对包含 map、slice 的配置值直接做 CompareAndSwap。接口比较要求底层值可比较,不可比较的动态值会 panic。配置快照通常只需要“构建新对象后整体 Store”;如果确实需要基于旧版本的条件更新,可以比较版本号并在外层串行化写者,或改用可比较的指针。
用可复现基准决定是否替换 RWMutex
我不会预设 atomic.Value 一定更快。它通常适合读远多于写、每次更新能构建完整快照的路径;如果读取并不热,或者更新必须组合多个共享对象,RWMutex 往往更清楚。下面的基准让两种实现读取同一份 Config,并由 RunParallel 施加并行读压力。
func BenchmarkReadAtomic(b *testing.B) {
	store, _ := NewStore(&Config{Version: 1})
	b.ReportAllocs()
	b.RunParallel(func(pb *testing.PB) {
		for pb.Next() {
			_ = store.Load().Version // 只测热路径读取,不混入配置解析。
		}
	})
}

func BenchmarkReadRWMutex(b *testing.B) {
	var mu sync.RWMutex
	cfg := &Config{Version: 1}
	b.ReportAllocs()
	b.RunParallel(func(pb *testing.PB) {
		for pb.Next() {
			mu.RLock()
			_ = cfg.Version // 与 atomic 版本读取同一字段。
			mu.RUnlock()
		}
	})
}
# 在不同 CPU 并行度下比较读路径,并输出分配指标。
go test -run='^$' -bench='BenchmarkRead' -benchmem -cpu=1,8,32
| 指标 | 观察重点 | 决策边界 |
|---|---|---|
| ns/op | 1、8、32 CPU 下读开销变化 | 只有稳定且可复现的下降才算收益 |
| B/op | 读取是否意外分配 | 理想热读路径应为 0 |
| allocs/op | 接口或克隆是否进入读路径 | 复制应留在低频写入侧 |
| 更新耗时 | 深拷贝与校验成本 | 写频繁时要纳入整体判断 |
表里没有预填“漂亮数字”,因为结果受 Go 版本、CPU、GOMAXPROCS、字段大小和真实读取逻辑影响。保留原始 bench 输出并重复运行;如果差异小到会被噪声覆盖,我会继续使用更容易表达复合不变量的 RWMutex。
竞态检测验证的是对象图,不只是发布槽
基准只能回答成本,不能证明没有共享写。测试中应让一个 goroutine 重复构建和发布新配置,让多个 goroutine 读取 Endpoints 与 Limits,再运行竞态检测。它最有价值的地方,是能抓到“Store 已经原子,但发布后又修改 map”的错误。
# 对包含真实更新与读取路径的全部包运行竞态检测。
go test -race ./...
通过 race detector 也不代表业务不可变性自动成立:测试必须覆盖修改路径。工程上还可以让 Config 字段保持不导出,只暴露复制后的查询结果,减少调用方意外改写的机会。
只存指针时可以优先考虑 atomic.Pointer
如果容器永远只保存 *Config,Go 1.19 起的 atomic.Pointer[Config] 往往更直接:编译器会拒绝错误类型,不需要接口断言,零值 Load 自然返回 nil。它同样不能在第一次使用后复制,也同样要求已发布对象保持只读。
type PointerStore struct {
	current atomic.Pointer[Config]
}

func (s *PointerStore) Store(next *Config) error {
	if next == nil {
		return errors.New("next config is nil") // 业务契约仍然拒绝空快照。
	}
	s.current.Store(cloneConfig(next))
	return nil
}
选择可以很朴素:只存一种指针类型,优先评估 atomic.Pointer;需要在同一个抽象里保存某个统一但并非指针专用的具体类型,atomic.Value 仍然合适。无论选哪一个,快照构建、深拷贝和发布后只读才是正确性的主体。
上线前检查表
- 第一次 Store 是否由构造函数完成,并且写入非空 *Config?
- 后续更新是否始终使用同一具体类型,而不是混用 Config 与 *Config?
- map、slice、指针字段是否完成了与业务结构匹配的深拷贝?
- 发布后的快照是否对所有 goroutine 只读?
- atomic.Value 所在结构是否始终通过指针传递、没有按值复制?
- 是否同时跑过基准与
go test -race?
常见问题
Load 会不会读到一半更新的 Config?
不会读到“半个接口值”;读者会获得某次完整发布的旧指针或新指针。但如果指针指向的对象发布后还在被修改,内部字段仍可能出现数据竞态,所以快照必须不可变。
可以先不 Store,让读者处理 nil 吗?
技术上可以,零值 Value 的 Load 会返回 nil;但配置系统通常更适合在构造阶段提供有效初值,把未初始化状态挡在服务启动之前。
配置只有几个整数,还要深拷贝吗?
纯值字段复制一个结构体即可;只有 map、slice、指针及其继续引用的可变对象需要按对象图复制。关键不是机械深拷贝,而是发布后不再共享可变存储。
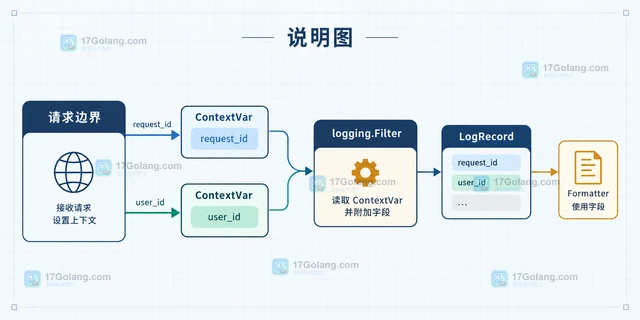 Python logging.Filter 注入请求上下文的做法
- 上一篇
- Python logging.Filter 注入请求上下文的做法
- 下一篇
- 表盘自定义工具重复安装会顶替旧表盘吗?自定义表盘 ID 与恢复说明
-
- Golang · Go教程 | 1小时前 |
- Go sync/atomic Uint64 对齐与无锁计数方案
- 165浏览 收藏
-
- Golang · Go教程 | 2小时前 | 性能优化 · 并发编程 · sync.Pool · 内存管理 · Go教程 · 垃圾回收 对象池 bytes.Buffer 临时对象 Go sync.Pool
- Go sync.Pool 缓存临时对象的回收边界
- 393浏览 收藏
-
- Golang · Go教程 | 2小时前 |
- Go sync.Cond 生产者消费者唤醒策略
- 224浏览 收藏
-
- Golang · Go教程 | 3小时前 |
- Go sync.OnceValue 延迟初始化结果的复用方式
- 132浏览 收藏
-
- Golang · Go教程 | 3小时前 | go · Context · 并发编程 · Go context.WithoutCancel context取消传播
- Go context.WithoutCancel 脱离父取消的使用边界
- 396浏览 收藏
-
- Golang · Go教程 | 3小时前 | go · Context · 并发编程 · Go context.AfterFunc 幂等清理
- Go context.AfterFunc 取消回调的幂等设计
- 367浏览 收藏
-
- Golang · Go教程 | 4小时前 | 错误处理 · go · Context · Go context.WithCancelCause context.Cause
- Go context.WithCancelCause 传递根因的错误链
- 431浏览 收藏
-
- Golang · Go教程 | 4小时前 |
- Go ResponseController 设置写超时的适用边界
- 277浏览 收藏
-
- Golang · Go教程 | 4小时前 |
- Go encoding/csv Reader FieldsPerRecord 处理变长列
- 189浏览 收藏
-
- Golang · Go教程 | 2天前 | Go教程 · Go encoding/xml 空元素 指针字段
- Go encoding/xml 空元素与指针字段的处理方式
- 142浏览 收藏
-
- Golang · Go教程 | 2天前 | Go教程 · Go encoding/xml 字段映射 Unmarshaler
- Go encoding/xml 自定义 Unmarshaler 的字段映射
- 189浏览 收藏
-
- Golang · Go教程 | 2天前 |
- Go encoding/xml Token 流式读取大型 XML
- 424浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 290次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 342次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 344次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 308次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 130次使用
-
- Go中的应用配置管理详解
- 2023-02-16 218浏览
-
- go zero微服务实战性能优化极致秒杀
- 2022-12-27 207浏览
-
- SingleFlight模式的Go并发编程学习
- 2023-01-01 285浏览
-
- golang配置管理神器Viper使用教程
- 2022-12-27 266浏览
-
- Go并发编程之sync.Once使用实例详解
- 2022-12-27 484浏览