
Python multiprocessing共享状态与进程安全队列的选择
Python 的 multiprocessing 里,Queue 和 Manager 都能让进程“互相看到东西”,但它们解决的不是同一个问题:Queue 传递消息或任务,接收方拿到的是序列化后重建的对象;Manager 维护一份由服务器进程托管的共享对象,其他进程通过代理访问。生产任务分发优先选 Queue,只有确实需要多个进程共同读写一份小型状态时才考虑 Manager。
- 任务、结果、事件通知适合用 Queue,数据边界清晰,生产者和消费者解耦。
- 计数器、少量配置、共享字典适合用 Manager,但每次代理读写都有跨进程通信成本。
- 大对象、热点写入和高频共享状态不要靠 Manager 硬撑,应改成消息聚合、批量提交或专门的共享内存方案。
先区分消息传递和共享状态
我在拆分批处理脚本时,最容易犯的错误是把“结果要汇总”理解成“所有进程都要共享一个列表”。如果 worker 只是把完成项交回主进程,Queue 已经足够;如果多个进程必须读取并更新同一个小字典,Manager 才有明确价值。
这条边界也解释了为什么普通的全局变量不行:进程有各自的地址空间,子进程修改自己的副本,不会自动改到父进程。Queue 的代价是对象会经过 pickle,拿到的是副本;Manager 的代价是代理方法要访问管理器进程,不能当成本地字典无限次调用。
Queue适合把任务交给进程,而不是共享可变对象
下面的结构把任务输入和结果输出分成两条消息通道。它适合一个主进程派发多个独立任务,worker 只处理消息并返回结果。示例刻意用小字典传递业务数据,不依赖共享列表。
from multiprocessing import Process, Queue

def worker(tasks, results):
    # worker 只消费消息,不直接修改主进程里的容器
    while True:
        job = tasks.get()
        if job is None:
            break  # None 是本例约定的停止标记
        try:
            value = job["value"] * 2
            results.put({"id": job["id"], "value": value})
        except (KeyError, TypeError) as exc:
            # 把可预期的输入错误作为结果返回,避免静默丢任务
            results.put({"id": job.get("id"), "error": str(exc)})

if __name__ == "__main__":
    tasks, results = Queue(), Queue()
    workers = [Process(target=worker, args=(tasks, results)) for _ in range(2)]
    for process in workers:
        process.start()
    for job_id, value in enumerate([3, 5, 8], 1):
        tasks.put({"id": job_id, "value": value})
    for _ in workers:
        tasks.put(None)  # 每个 worker 都需要一个停止标记
    for _ in range(3):
        print(results.get(timeout=5))  # 读取结果时设置超时,避免永久等待
    for process in workers:
        process.join()  # 主进程明确回收子进程
这里不要用 empty() 判断“已经没有结果”,因为生产者和队列底层 feeder thread 之间可能存在短暂间隔。更稳妥的做法是根据任务数量收集结果,或用明确的结束消息和超时策略。
Manager适合共享小型状态,但代理调用要收敛
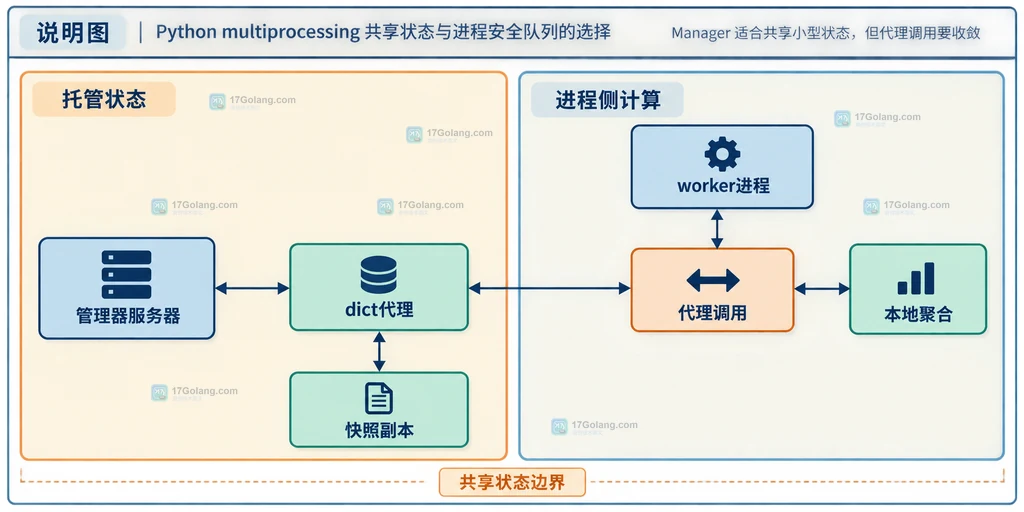
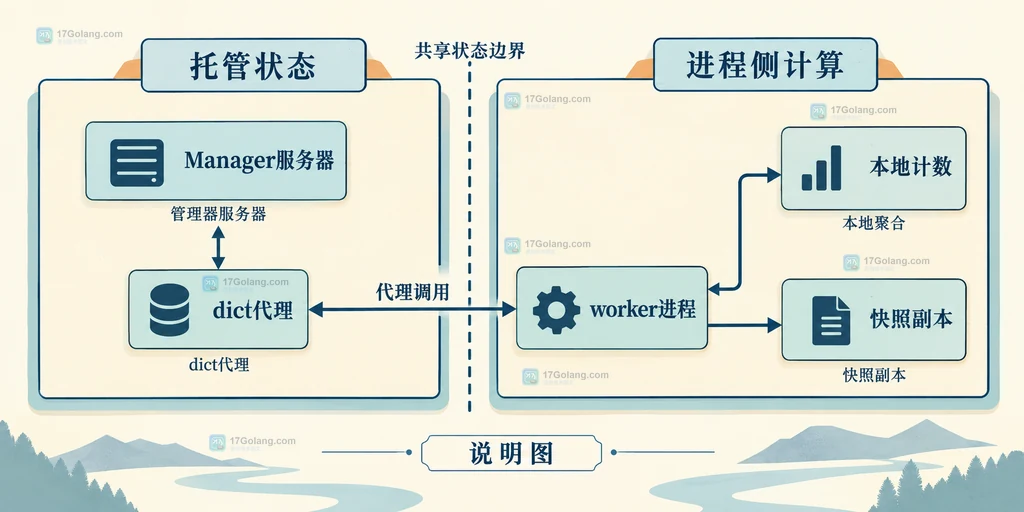
Manager() 会启动一个管理器进程,dict()、list() 等返回的是代理对象。它适合共享少量状态,例如每个 worker 的完成计数或一份小配置。不要在循环里对代理对象做数十万次细粒度更新;可以让 worker 本地聚合,最后一次性提交。
from multiprocessing import Manager, Process

def worker(worker_id, shared):
    # 先在本地累加,减少对 Manager 代理的往返调用
    local_count = 0
    for _ in range(100):
        local_count += 1
    shared[worker_id] = local_count  # 最后只写入一次共享状态

if __name__ == "__main__":
    with Manager() as manager:
        progress = manager.dict()
        workers = [Process(target=worker, args=(i, progress)) for i in range(2)]
        for process in workers:
            process.start()
        for process in workers:
            process.join()  # 先确认 worker 结束,再读取最终快照
        snapshot = dict(progress)  # 尽早转成本地副本,后续计算不再走代理
        print(snapshot)
还有一个常见坑:把普通嵌套字典放进 Manager 列表后,直接修改嵌套字典通常不会自动触发代理同步。需要把嵌套容器也做成 Manager 代理,或者取出对象、修改后重新赋回。共享状态越复杂,越应该回到 Queue 的事件/快照模型。
按数据量和一致性做选择
| 场景 | 优先方案 | 原因与边界 |
|---|---|---|
| 任务分发、结果回收 | Queue | FIFO、多生产者多消费者,消息所有权清楚 |
| 少量计数、状态快照 | Manager.dict/list | 写法直观,但代理访问有通信成本 |
| 大块数组或高频数值读写 | shared_memory 等专用方案 | 避免把大量对象反复 pickle 或代理调用 |
| 跨机器共享 | 外部队列或存储服务 | Manager 可以远程访问,但认证、可用性和运维边界更重 |
最后检查三件事:是否给每个 worker 发送了停止信号;是否对 get()、put() 设置了合适的超时;是否对启动的进程逐个 join()。如果答案是否定的,先补齐生命周期,再讨论 Queue 还是 Manager。
常见问题
Queue 里的对象修改后会同步回原对象吗?
不会。对象会被序列化,接收端拿到的是重建后的副本;要传回修改结果,需要再次放入结果队列。
Manager 一定比 Queue 慢吗?
不能简单下结论,但代理访问要经过管理器进程,细粒度高频读写通常更贵。先本地聚合,再批量提交,通常更容易控制成本。
什么时候不该使用 Manager?
共享对象很大、更新频繁、需要高吞吐,或状态可以通过事件重放得到时,不要把 Manager 当数据库使用,优先采用 Queue、共享内存或专门存储。
 表盘自定义工具登录账号怎么处理?授权入口与权限安全核对
- 上一篇
- 表盘自定义工具登录账号怎么处理?授权入口与权限安全核对
- 下一篇
- 画质怪兽官网展示的数据能证明安全吗?下载用户、解锁次数与判断边界
-
- 文章 · python教程 | 1天前 |
- Python re用分组字典解析可选日志字段的实现
- 470浏览 收藏
-
- 文章 · python教程 | 1天前 | JSON · python · Python NaN json.loads Infinity parse_constant
- Python json.loads解析非标准数字的容错边界
- 267浏览 收藏
-
- 文章 · python教程 | 4天前 |
- Python csv.DictReader处理缺失列与额外列的办法
- 105浏览 收藏
-
- 文章 · python教程 | 4天前 |
- Python logging按请求注入上下文字段的过滤器方案
- 324浏览 收藏
-
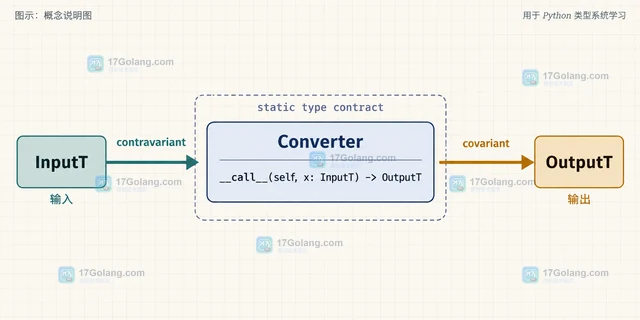
- 文章 · python教程 | 4天前 | Python教程 · Python 泛型 callable typing.Protocol 结构化子类型
- Python typing.Protocol配合泛型描述可调用对象的方式
- 355浏览 收藏
-
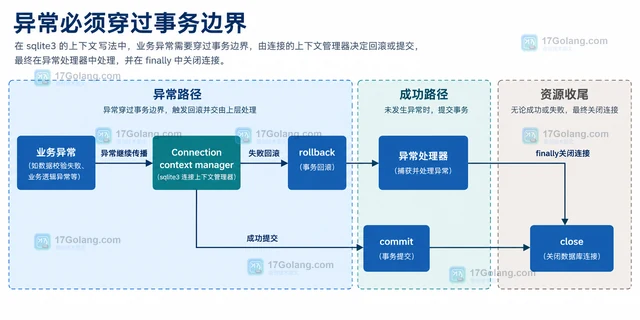
- 文章 · python教程 | 4天前 |
- Python sqlite3事务提交与异常回滚的上下文写法
- 357浏览 收藏
-
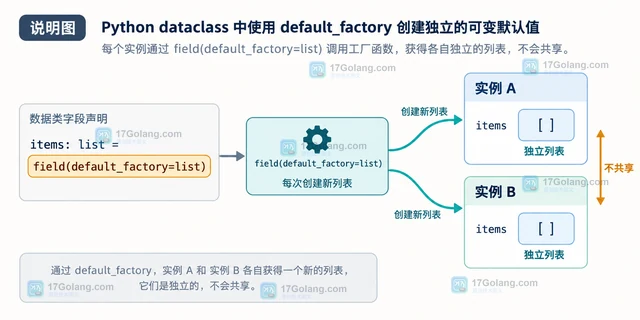
- 文章 · python教程 | 4天前 |
- Python dataclass用field配置默认工厂的对象设计
- 114浏览 收藏
-
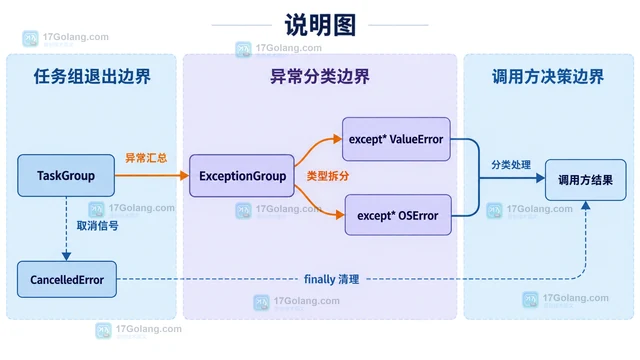
- 文章 · python教程 | 4天前 | 并发 · python · 异步编程 · asyncio TaskGroup ExceptionGroup
- Python asyncio.TaskGroup组织并发任务与异常取消
- 322浏览 收藏
-
- 文章 · python教程 | 4天前 | python · pathlib ·
- Python pathlib批量改名并保留冲突回滚点的脚本
- 422浏览 收藏
-
- 文章 · python教程 | 4天前 |
- Python argparse让位置参数与子命令独立解析的实现方法
- 298浏览 收藏
-
- 文章 · python教程 | 4天前 | 并发 · python · logging · 异步日志 QueueHandler QueueListener Python logging
- Python logging用 QueueHandler 隔离日志 I/O的实现方法
- 323浏览 收藏
-
- 文章 · python教程 | 4天前 | 并发 · 线程池 · 异常处理 · python · Python threadpoolexecutor future concurrent.futures
- Python concurrent收集线程池异常并关闭执行器的实现方法
- 262浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 198次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 255次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 209次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 196次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 185次使用
-
- Golang 手写一个简单的并发任务 manager
- 2022-12-23 367浏览
-
- go格式“占位符”输入输出 类似python的input
- 2023-01-19 346浏览
-
- Golang如何调用Python代码详解
- 2023-01-07 235浏览
-
- Golang中数据结构Queue的实现方法详解
- 2023-01-07 323浏览
-
- HTTP 的 response 中的响应体和头部是分开发送的吗?
- 2023-01-28 387浏览


