
Python argparse让位置参数与子命令独立解析的实现方法
我在把一个只有几个参数的脚本改成多命令 CLI 时,最容易踩的坑不是参数类型,而是位置参数的归属:tool run target 里的 target 应该由 run 解析,还是被顶层解析器提前拿走?稳定的做法是把全局上下文放进选项,把每个命令自己的 positional 只定义在对应的 subparser 中。
官方地址:https://docs.python.org/3/library/argparse.html
add_subparsers()负责识别命令,add_parser()负责定义该命令的参数。- 工作区、配置文件这类跨命令信息优先写成
--workspace选项,不要和多个可变 positional 混在顶层。 - 解析完成后用
dest和set_defaults()明确分发,错误会更容易定位。
先把三层参数边界分清楚
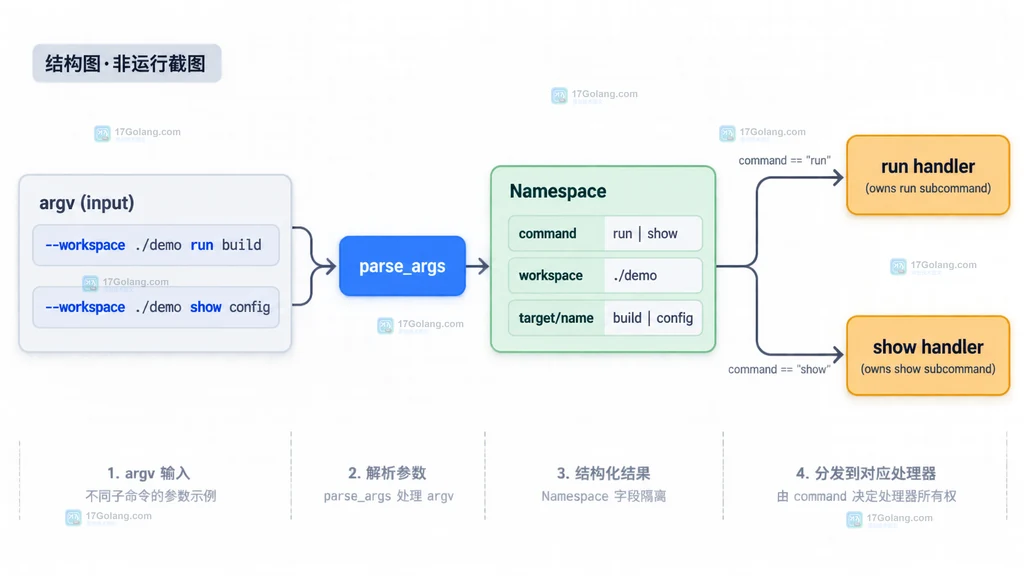
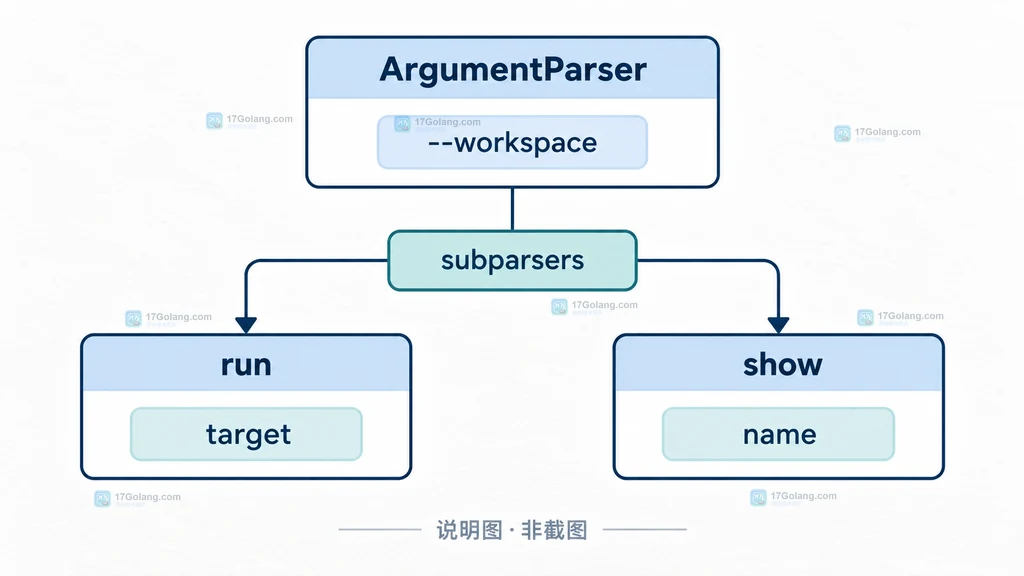
一个命令行工具可以先按下面的形状设计:顶层是程序级选项,中间是命令名,最后是某个命令的参数。
| 层级 | 例子 | 建议放置位置 |
|---|---|---|
| 全局上下文 | --workspace ./demo | 顶层 ArgumentParser |
| 命令选择 | run、show | add_subparsers(dest="command") |
| 命令目标 | target、name | 对应的子解析器 |
尤其要避免在顶层放一个 nargs="*" 或 nargs="+" 的 positional,再期待它自动把后面的单词让给子命令。它们都在争夺同一段输入,帮助信息和错误位置会变得不直观。需要跨命令传递的值,用带名字的选项表达,用户也更容易读懂。
用 subparser 让位置参数各归其位
下面这个最小结构把 run 和 show 的目标分别交给两个子解析器。代码中的注释只解释关键边界,实际业务函数可以替换成项目自己的实现。
import argparse


def run_command(args):
    # run 只读取自己的 target,同时继承顶层的 workspace。
    print(f"run {args.target} in {args.workspace}")


def show_command(args):
    # show 的 name 与 run 的 target 互不复用,避免语义混淆。
    print(f"show {args.name} in {args.workspace}")


parser = argparse.ArgumentParser(description="处理项目目标")
# 这是跨子命令的上下文,因此使用有名字的选项而不是顶层 positional。
parser.add_argument("--workspace", default=".", help="项目工作目录")
subparsers = parser.add_subparsers(dest="command", required=True)

run_parser = subparsers.add_parser("run", help="执行一个目标")
run_parser.add_argument("target", help="要执行的目标名")
run_parser.set_defaults(handler=run_command)

show_parser = subparsers.add_parser("show", help="查看一个目标")
show_parser.add_argument("name", help="要查看的目标名")
show_parser.set_defaults(handler=show_command)

args = parser.parse_args()
# 先由 subparser 选择 handler,再让 handler 消费自己的字段。
args.handler(args)
因此,python tool.py --workspace ./demo run build 得到的是 command=run、target=build;换成 show config 时,结果字段变为 command=show、name=config。两条路径共享 workspace,却不会互相读取位置参数。
解析顺序决定了哪些写法可靠
命令名本身是 subparser 的选择值,通常应当放在全局选项之后、命令目标之前。推荐把接口固定成:
# 全局选项 + 子命令 + 子命令位置参数
python tool.py --workspace ./demo run build
python tool.py --workspace ./demo show config
如果某个参数只服务于 run,就定义在 run_parser 上,例如 --retry;不要为了“统一”把它提升到顶层。反过来,所有命令都需要的配置才留在主解析器。这样生成的帮助文本也会按层级显示,用户能直接判断参数属于哪里。
还要注意 nargs:单个目标使用默认值即可,多个目标使用 nargs="+" 时,应确认它不会吞掉本来应作为命令名的输入。一个简单规则是:命令名之前不要放可变数量 positional;可变列表尽量放在已经确定的子命令内部。
常见问题与边界处理
为什么缺少子命令时看起来像位置参数错误?
因为子命令选择本身就是顶层 parser 的一个位置入口。设置 required=True 后,缺少 run 或 show 会在顶层尽早失败,帮助信息会列出允许的命令。
两个子命令可以使用同名 positional 吗?
可以。它们属于不同的 Namespace 语义域;但如果业务分发代码需要统一读取字段,最好统一命名,或者在 handler 内做明确转换,不要依赖隐式字段存在。
什么时候才适合顶层 positional?
只有当它对所有命令都有同一含义、且数量固定时才考虑。只要它可能和子命令名混淆,就改用选项或把它下沉到具体 subparser。
把 positional 看成“已经确定上下文后的局部输入”,把 option 看成“跨命令的命名配置”,argparse 的层级就会清楚很多。先固定这条边界,再扩展别名、类型转换和错误提示,后续维护成本会低得多。
 Go testing/fstest发现 FS 实现的路径错误的检查方法
- 上一篇
- Go testing/fstest发现 FS 实现的路径错误的检查方法
- 下一篇
- LibTV做节点式视频编辑效果不好怎么办?提示与参数排查
-
- 文章 · python教程 | 1天前 |
- Python 3.14 升级后怎样检查扩展模块兼容
- 373浏览 收藏
-
- 文章 · python教程 | 1天前 | 标准库 · uuid · Python教程 · Python 自定义字段 RFC 9562 uuid.uuid8 UUIDv8 uuid.uuid4
- Python uuid.uuid8 怎样生成带自定义字段的 UUID
- 152浏览 收藏
-
- 文章 · python教程 | 1天前 | 标准库 · xml · Python教程 · Python xml 流式解析 ElementTree xml.etree.ElementTree iterparse
- Python xml.etree.ElementTree.iterparse 怎样流式读取大 XML
- 339浏览 收藏
-
- 文章 · python教程 | 1天前 |
- Python json.loads 怎样处理重复键
- 424浏览 收藏
-
- 文章 · python教程 | 1天前 | SQLite · 事务管理 · Python教程 · Python 事务 上下文管理器 sqlite3 autocommit isolation_level Connection
- Python sqlite3 怎样使用上下文管理事务
- 257浏览 收藏
-
- 文章 · python教程 | 1天前 |
- Python EmailMessage 怎样同时发送纯文本和 HTML
- 177浏览 收藏
-
- 文章 · python教程 | 1天前 |
- Python compression.zstd 怎样用 ZstdDict 压缩重复数据
- 184浏览 收藏
-
- 文章 · python教程 | 1天前 | 位置参数 partial Python 3.14 functools.Placeholder partialmethod
- Python functools.Placeholder 怎样组合非首位参数
- 237浏览 收藏
-
- 文章 · python教程 | 1天前 |
- Python concurrent.interpreters 怎样创建解释器实例
- 480浏览 收藏
-
- 文章 · python教程 | 1天前 |
- Python typing.ReadOnly 怎样标记 TypedDict 中不可修改字段
- 218浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 883次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 880次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 965次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 947次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 775次使用
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览