
正则提取版本号技巧分享
2026-04-30 22:07:14
0浏览
收藏
本文深入讲解了如何利用正则表达式中的非捕获分组(?:...)精准提取文本中的版本号,强调其核心作用是“占位不存值”——用它剥离无关上下文(如前缀v、冒号、空格等),而将真正要获取的版本号严格置于普通捕获组()中,再通过match()返回数组的[1]索引安全提取;同时覆盖多匹配场景下的matchAll()应用、常见陷阱(如括号嵌套、量词作用域、含括号文本处理)及实用技巧,帮助开发者写出更健壮、可读性更强、性能更优的版本号提取逻辑。

要用 String.prototype.match() 配合非捕获分组 (?:...) 提取复杂文本中的特定版本号,关键是用非捕获分组“占位”不关心的上下文,只让目标版本号落在**捕获组**(即带括号但不加 ?: 的括号)中,再通过 match() 返回的数组精准取值。
明确版本号格式,设计带捕获组的核心模式
非捕获分组本身不保存匹配内容,所以不能靠它提取;真正要提取的部分必须写在普通捕获组里。例如,想从 "Current build: v2.14.0-beta.3 (rev 9876)" 中提取 2.14.0-beta.3:
- 把固定前缀
v和可选空格/冒号等写成非捕获分组:(?:v\s*[::]?\s*) - 把实际要提取的版本部分用普通括号包住:
(\d+\.\d+\.\d+(?:-[a-z]+(?:\.\d+)?)?) - 完整正则:
/(?:v\s*[::]?\s*)(\d+\.\d+\.\d+(?:-[a-z]+(?:\.\d+)?)?)/i
调用 match() 并安全获取捕获结果
match() 在有捕获组时返回数组,[0] 是整个匹配字符串,[1] 是第一个捕获组内容(即你要的版本号):
const text = "Build info: v2.14.0-beta.3 (rev 9876)";
const pattern = /(?:v\s*[::]?\s*)(\d+\.\d+\.\d+(?:-[a-z]+(?:\.\d+)?)?)/i;
const result = text.match(pattern);
const version = result?.[1]; // "2.14.0-beta.3"
务必用可选链 ?.[1] 或先判断 result 是否存在,避免 null 报错。
处理多处版本号或模糊上下文
如果文本含多个候选(如日志混着旧版、测试版),可用 matchAll() 配合全局标志 g,再逐个过滤:
- 给正则加
g和matchAll():确保拿到所有匹配 - 非捕获分组仍用于忽略干扰结构,比如
(?:version|ver|v)\s*[::]?\s* - 对每个
match检查[1]是否符合业务规则(如主版本 ≥ 2)
示例:
const allMatches = [...text.matchAll(/(?:version|v)\s*[::]?\s*(\d+\.\d+\.\d+)/gi)];
const validVersions = allMatches
  .map(m => m[1])
  .filter(v => parseInt(v.split('.')[0]) >= 2);
注意点:非捕获分组不是万能“忽略”,括号层级仍影响匹配逻辑
非捕获分组只是不存结果,但它参与匹配、影响优先级和回溯。常见陷阱:
- 嵌套非捕获写法要配对:
(?:prefix(?:inner)suffix),别漏括号 - 量词作用于非捕获分组时,是整个分组重复,不是里面的内容单独重复
- 如果版本号本身含括号(如
v1.2.3 (stable)),需在非捕获分组里显式允许空格和括号:(?:v\s*\(?)[\s\S]*?(\d+\.\d+\.\d+)
非捕获分组让正则更清晰、性能略优,但提取动作始终依赖捕获组位置和 match() 返回结构。
今天关于《正则提取版本号技巧分享》的内容就介绍到这里了,是不是学起来一目了然!想要了解更多关于的内容请关注golang学习网公众号!
 PHP接收XML数组的实用方法
- 上一篇
- PHP接收XML数组的实用方法

- 下一篇
- Win11关闭睡眠设置方法详解
查看更多
最新文章
-
- 文章 · 前端 | 1小时前 | map · 前端 · 数据处理 · javascript · JavaScript 数组分组 Object.groupBy Map.groupBy
- Object.groupBy 与 Map.groupBy 应该怎么选
- 138浏览 收藏
-
- 文章 · 前端 | 4小时前 |
- Promise.withResolvers 适合封装哪些外部回调
- 418浏览 收藏
-
- 文章 · 前端 | 7小时前 |
- CSS 容器样式查询怎么读取自定义属性
- 414浏览 收藏
-
- 文章 · 前端 | 12小时前 | css · CSS anchor positioning 浮层定位
- CSS Anchor Positioning 怎么让浮层跟随触发元素
- 316浏览 收藏
-
- 文章 · 前端 | 14小时前 |
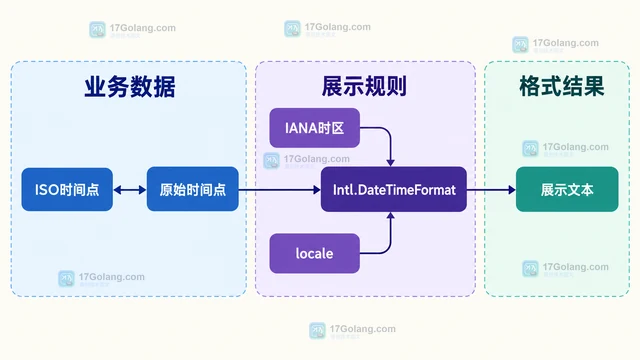
- Intl.DateTimeFormat按用户时区显示业务时间的实现
- 363浏览 收藏
-
- 文章 · 前端 | 3天前 | 前端 · 缓存 · Service Worker CacheStorage 缓存版本 activate
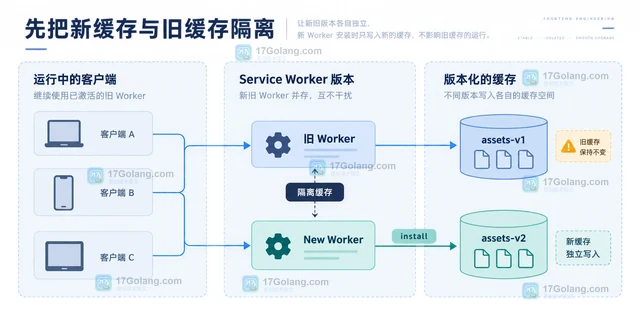
- Service Worker缓存版本切换与旧缓存清理流程
- 490浏览 收藏
-
- 文章 · 前端 | 6天前 |
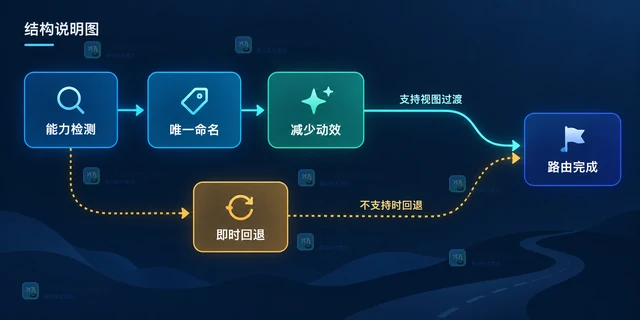
- View Transitions在路由切换中保留关键元素连续性
- 305浏览 收藏
-
- 文章 · 前端 | 6天前 |
- CSS :has选择器实现父级状态样式的边界
- 252浏览 收藏
-
- 文章 · 前端 | 6天前 |
- CSS container queries按组件宽度适配卡片布局
- 367浏览 收藏
-
- 文章 · 前端 | 6天前 | 前端 · 性能优化 · javascript · ArrayBuffer postMessage TypedArray 结构化克隆 Web Worker Transferable
- Web Worker传递大数组时选择Transferable降低复制
- 140浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 231次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 276次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 246次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 226次使用
-
- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 25次使用
查看更多
相关文章
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览