
ReadableStream.tee 怎样分发同一响应流
如果一次 fetch() 响应既要实时显示给用户,又要写入缓存,不能先把 response.body 交给第一个读取器,再把同一个流交给第二个读取器。ReadableStream 只能同时拥有一个活动读取者;正确的入口是先调用 response.body.tee(),得到两个可以独立读取的分支。
官方资料地址:https://developer.mozilla.org/en-US/docs/Web/API/ReadableStream/tee
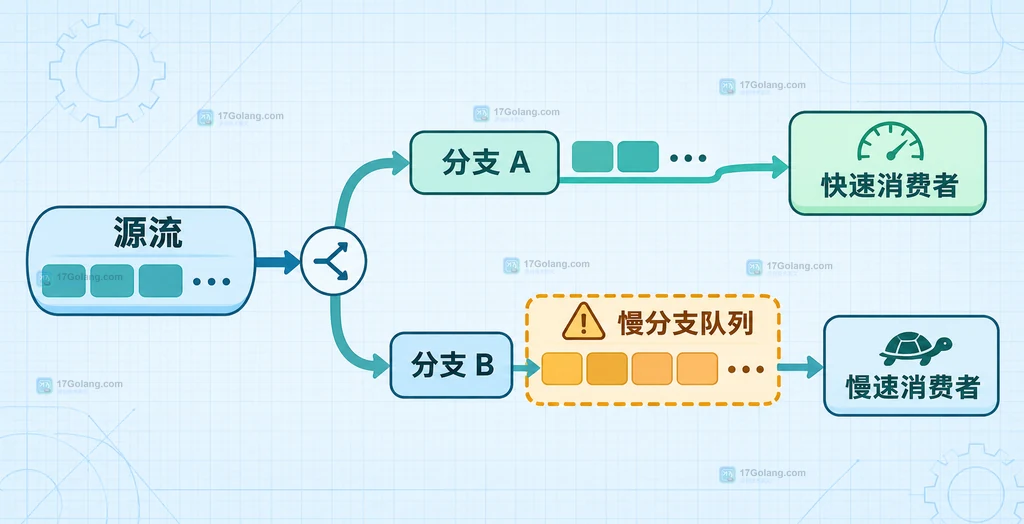
最小模型是 const [previewBranch, cacheBranch] = response.body.tee()。两个分支会收到同一源流的内容,但各自维护读取进度。需要特别记住:内置 tee() 只提供部分背压,慢分支未读取的块会在内部排队;如果两个消费者速度差异很大,就不适合把它当成无限缓冲的复制器。
先确认 tee() 解决了什么问题
tee() 的价值是把“一个流不能被两个 reader 同时读取”的限制,转换成“两个 branch 各自读取”。它返回长度为 2 的数组,不会返回一个可以被任意复制的普通数组数据,也不会把全部响应自动转换成字符串。
async function splitResponse(response) {
  // body 可能为空;没有可读流时不要调用 tee()。
  if (!response.body) {
    throw new Error("响应没有可读取的 body");
  }

  // tee() 只负责分出两个流,两个读取游标彼此独立。
  const [previewBranch, cacheBranch] = response.body.tee();

  return { previewBranch, cacheBranch };
}
如果直接对同一个 response.body 连续调用两次 getReader(),第二次会因为流已经被锁定而失败。调用 tee() 后,原始流也会在分流期间被占用;后续代码应该只把两个 branch 交给消费者,不要再尝试从原始流读取。
两个分支要分别读取和解码
网络响应通常是字节流,分支后的每一条路径都应该有自己的解码器。把同一个 TextDecoder 实例交给两个消费者,会让多字节字符的增量状态互相干扰;更直接的做法是先 tee,再在每条分支上分别接入 TextDecoderStream。
async function readTextBranch(branch, onChunk) {
  // 每条分支使用自己的 TextDecoderStream,避免 UTF-8 半字符状态串线。
  const textStream = branch.pipeThrough(new TextDecoderStream());
  const reader = textStream.getReader();

  try {
    while (true) {
      const { done, value } = await reader.read();
      // done 表示该分支已经正常结束,value 此时不再参与处理。
      if (done) break;
      await onChunk(value);
    }
  } finally {
    // 释放这条文本分支上的 reader 锁,便于明确结束后的资源收尾。
    reader.releaseLock();
  }
}

async function previewAndCache(response, render, writeCache) {
  // body 为空时给出明确错误,避免后面出现难定位的 TypeError。
  if (!response.body) throw new Error("响应体不可读");

  const [previewBranch, cacheBranch] = response.body.tee();

  // 两个消费者可以并行运行,但不能假设它们读取速度相同。
  await Promise.all([
    readTextBranch(previewBranch, async (chunk) => render(chunk)),
    readTextBranch(cacheBranch, async (chunk) => writeCache(chunk)),
  ]);
}
这个例子把“分流”和“消费”分开:tee() 只负责建立两个分支,readTextBranch() 负责独立读取,业务函数决定每个块如何渲染或写入。缓存写入如果需要批量提交,可以在 writeCache 内部聚合,但不能让聚合无限增长。
完成、失败和取消都要覆盖两个分支
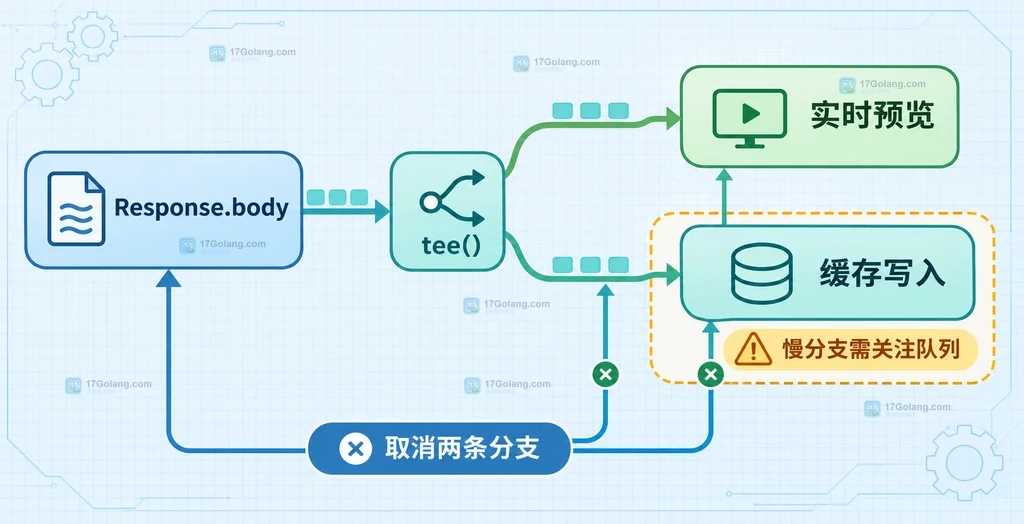
两个分支不是两个独立的网络请求,它们共享同一个源流。正常情况下两个消费者都读到结束;发生错误或用户中止时,业务层要把两个分支都纳入取消路径。只取消其中一个分支,不等于源流马上停止,因为另一条分支可能仍然处于读取状态。
async function consumeWithAbort(branch, signal, onChunk) {
  // reader 负责这条分支的读取和取消,避免对已锁定的 stream 直接 cancel。
  const reader = branch.getReader();
  const abort = () => {
    // 取消未完成的 read,让消费者尽快离开等待状态。
    void reader.cancel(signal.reason || new Error("用户取消读取"));
  };

  signal.addEventListener("abort", abort, { once: true });
  try {
    while (true) {
      const { done, value } = await reader.read();
      if (done) break;
      await onChunk(value);
    }
  } finally {
    signal.removeEventListener("abort", abort);
    // 释放锁;如果业务还要复用 reader,应该在这里先完成明确的 cancel。
    reader.releaseLock();
  }
}

async function mirrorResponse(response, signal, render, save) {
  // 没有 body 时不创建并行消费者。
  if (!response.body) throw new Error("响应体为空");
  const [previewBranch, cacheBranch] = response.body.tee();

  const results = await Promise.allSettled([
    consumeWithAbort(previewBranch, signal, render),
    consumeWithAbort(cacheBranch, signal, save),
  ]);

  // 任一分支失败都应让调用方知道镜像消费没有完整完成。
  const failed = results.find((result) => result.status === "rejected");
  if (failed) throw failed.reason;
}
示例中的 Promise.allSettled() 让两条分支都走到结束状态,再由调用方决定展示错误、删除不完整缓存或重新请求。真实项目里还应把网络错误、用户取消和缓存写入失败区分开;不要把所有拒绝都包装成“接口返回空数据”。
慢分支为什么会带来内存风险
内置 tee() 会按照较快分支的消费速度拉取源流;较慢分支尚未读取的块会排在它自己的内部队列里。MDN 明确提醒,这部分未读数据没有一个可以替代业务限流的固定上限。因此,一个分支实时显示、另一个分支被后台写入卡住时,响应越大,慢分支积压越多。
| 场景 | 内置 tee() 判断 | 更稳妥的做法 |
|---|---|---|
| 两个分支速度接近、响应较小 | 适合直接分流 | 分别读取,统一处理取消和错误 |
| 一个分支偶尔暂停 | 关注慢分支的积压 | 限制写入批次和并发,设置业务超时 |
| 超大响应、两个消费者速度长期不同 | 不应把内部队列当作无限缓存 | 设计真正按慢分支背压的管道,或改为可恢复的单次落盘流程 |
这里的关键不是“永远不能用 tee()”,而是先估计响应大小、消费者速度和取消策略。若必须完全按照较慢消费者的速度拉取,需要采用能让两个分支共同施加背压的实现,而不是只把 tee() 外面再包一层 Promise。
用五个问题排查 tee() 不生效
- body 是否为空?先判断
response.body,否则调用tee()会在错误位置失败。 - 原始流是否已经被读取?检查是否提前调用过
getReader()、json()、text()或arrayBuffer();这些操作都会消费响应体。 - 两条分支是否各自拥有 reader 和解码器?不要共享 reader,也不要把一个有增量状态的解码器交给两个分支。
- 慢分支是否持续积压?在大响应或写缓存变慢时,观察消费策略,必要时限制队列来源或改造管道。
- 取消是否覆盖两条分支?用户离开页面、请求超时或任一消费者失败时,都要让另一条分支结束,避免源流继续工作。
记住这条边界即可:tee() 解决的是“一次响应体需要两个读取方向”,不是“把任意大流复制成两份并自动获得完美背压”。先拆分,再分别消费;最后按两条分支的速度、错误和取消行为评估它是否适合当前任务。
相关问题
- ReadableStream.tee() 会复制全部数据吗?它会把后续块分发给两个分支,不是调用时立即生成两个完整内存副本;慢分支未读块会在内部排队。
- 为什么不能直接读取同一个 Response.body 两次?响应体是单个可读流,第一次读取会锁定或消费它;需要两个方向时应先 tee。
- 一个分支取消后另一个还能读吗?另一个分支可能仍能继续读,但业务不能据此假设源流已经停止;要结束整体消费,应让两条分支都进入取消或完成状态。
 Linux find -exec {} + 与逐个执行有什么区别
- 上一篇
- Linux find -exec {} + 与逐个执行有什么区别
- 下一篇
- CSS :where() 怎样降低组件选择器的优先级
-
- 文章 · 前端 | 19分钟前 | CSS 固定导航栏 锚点 scroll-padding-top
- CSS scroll-padding-top 怎样让锚点避开固定导航栏
- 189浏览 收藏
-
- 文章 · 前端 | 21分钟前 | javascript · 性能监控 buffered PerformanceObserver PerformanceEntry 资源计时
- PerformanceObserver buffered 怎样补采已经发生的性能条目
- 284浏览 收藏
-
- 文章 · 前端 | 23分钟前 |
- CSS :where() 怎样降低组件选择器的优先级
- 260浏览 收藏
-
- 文章 · 前端 | 1天前 | 前端 · csv · 编码 · javascript · 数据导入 · csv ReadableStream TextDecoderStream UTF-8 BOM IgnoreBOM 前端流式读取
- TextDecoderStream ignoreBOM 怎么处理 CSV 开头的 UTF-8 BOM
- 283浏览 收藏
-
- 文章 · 前端 | 1天前 |
- Astro after-swap 怎么在页面过渡后恢复焦点
- 240浏览 收藏
-
- 文章 · 前端 | 1天前 |
- Astro endpoint 怎样导出带缓存头的二进制响应
- 355浏览 收藏
-
- 文章 · 前端 | 1天前 |
- Astro middleware 怎样把请求上下文传给页面
- 132浏览 收藏
-
- 文章 · 前端 | 1天前 |
- Astro server:defer 怎么延迟服务端岛并显示 fallback
- 390浏览 收藏
-
- 文章 · 前端 | 1天前 | 前端 · javascript · 浏览器API · ArrayBuffer TypedArray ArrayBuffer.transfer detached JavaScript二进制缓冲区
- ArrayBuffer.transfer 后原缓冲区为什么变成不可用
- 500浏览 收藏
-
- 文章 · 前端 | 1天前 |
- Astro client:media 怎么按屏幕条件决定组件何时水合
- 332浏览 收藏
-
- 文章 · 前端 | 1天前 | javascript · ArrayBuffer.resize Resizable ArrayBuffer Uint8Array 网络分片 二进制缓冲区
- ArrayBuffer.resize 怎么扩容网络分片缓冲区而不频繁拷贝
- 472浏览 收藏
-
- 文章 · 前端 | 1天前 |
- Angular DestroyRef 怎么避免异步回调访问已销毁组件
- 453浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 992次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 996次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1117次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1092次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 932次使用
-
- Go Goja 怎么预编译脚本并在多个运行时执行
- 2026-10-13 306浏览
-
- 这样需求的表单一般要这么做?
- 2023-02-17 194浏览
-
- css 中的px 跟 video 中px 等同吗?
- 2023-01-09 427浏览
-
- 为什么使用了https还是可以被抓包
- 2023-02-16 480浏览
-
- 无法控制Websocket的send和receive事件
- 2023-02-16 486浏览


