
Scikit-learn词干提取:NLTK与CountVectorizer结合应用
本文深入解析了如何在Scikit-learn的CountVectorizer中安全、有效地集成NLTK的PorterStemmer实现英文词干提取,直击其默认不支持词干化的根本原因——追求轻量、可复现与语言中立性;文章不仅提供可直接运行的自定义分词器代码,更关键地揭示了停用词匹配失效、大小写与清洗顺序冲突、中英文处理陷阱等实战中极易踩坑的细节,并严肃提醒:词干化并非万能预处理,它可能扭曲语义、放大噪声,尤其在专业领域或小样本场景下务必先验证效果——想让文本向量化更精准,光“套用技巧”远远不够,理解原理与权衡代价才是关键。

CountVectorizer 本身不支持词干提取(stemming),它只做分词、小写化、停用词过滤等基础预处理,但不会调用 NLTK 的 PorterStemmer 或 LancasterStemmer。想在向量化前做词干化,必须手动接管分词环节。
为什么 CountVectorizer 默认不做词干提取
CountVectorizer 的设计目标是轻量、可复现、无语言依赖 —— 词干规则高度依赖语种(英文有效,中文无效),且不同 stemmer 实现结果不一致。所以它把分词逻辑完全开放给用户,通过 tokenizer 参数注入自定义函数。
如何用 NLTK 的 PorterStemmer 配合 CountVectorizer
关键不是“集成”,而是“替换默认分词器”。你需要:
- 提前初始化
NLTK的PorterStemmer(注意:不是WordNetLemmatizer,后者需要词性标注,开销大且不兼容默认流程) - 写一个接受字符串、返回词干列表的
tokenizer函数 - 禁用
CountVectorizer自带的小写化和标点清洗(否则会和 stemmer 冲突),或确保顺序可控
示例:
from nltk.stem import PorterStemmer from nltk.tokenize import word_tokenize from sklearn.feature_extraction.text import CountVectorizerstemmer = PorterStemmer()
def stem_tokenize(text): return [stemmer.stem(token) for token in word_tokenize(text.lower())]
vectorizer = CountVectorizer( tokenizer=stem_tokenize, lowercase=False, # 已在 stem_tokenize 里做了,关掉避免重复 stop_words='english', ngram_range=(1, 1) )
常见错误:stop_words 和 stemmer 的顺序问题
如果你用 stop_words='english',scikit-learn 会在分词后、计数前过滤停用词 —— 但此时词还是原形(如 'running'),而你的 stem_tokenize 返回的是词干(如 'run')。这会导致停用词表匹配失败('run' 不在 english 停用词列表里)。
解决办法只有两个:
- 改用自定义停用词列表,里面填入已词干化的词,比如
stop_words=['the', 'and', 'or', 'run', 'go', 'say'] - 放弃内置
stop_words,在stem_tokenize里手动过滤,例如:[stemmer.stem(t) for t in word_tokenize(text.lower()) if stemmer.stem(t) not in my_stemmed_stopwords]
中文文本不能直接套用 PorterStemmer
PorterStemmer 是为英文设计的,对中文字符会逐字切分再乱 stem,结果不可用。中文需先用 jieba 或 pkuseg 分词,再考虑是否做简略归一(如去除“们”“儿”“子”等后缀),但这不属于传统词干提取,也没有通用库支持。硬套 NLTK 只会得到一堆单字或空字符串。
真正要注意的点是:词干化会破坏语义粒度。比如 'university' → 'univers'、'better' → 'better'(Porter 对某些比较级不处理),这种不可逆压缩在小样本或专业领域可能放大噪声 —— 别为了“看起来更规范”而跳过验证。
文中关于的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《Scikit-learn词干提取:NLTK与CountVectorizer结合应用》文章吧,也可关注golang学习网公众号了解相关技术文章。
 抖音团购外卖骑手入口上线详解
- 上一篇
- 抖音团购外卖骑手入口上线详解

- 下一篇
- Linux引导修复方法全解析
-
- 文章 · python教程 | 4小时前 | python · Python tarfile extraction_filter data_filter
- Python tarfile extraction_filter 怎么阻止危险路径
- 232浏览 收藏
-
- 文章 · python教程 | 6小时前 |
- Python pathlib.Path.walk 怎么剪枝目录遍历
- 159浏览 收藏
-
- 文章 · python教程 | 9小时前 | python · SQLite · Python sqlite3 autocommit isolation_level SQLite事务
- Python sqlite3 autocommit 与 isolation_level 怎么配合
- 378浏览 收藏
-
- 文章 · python教程 | 14小时前 | 并发 · 异步编程 · Python教程 · Python 任务调度 asyncio eager_task_factory
- Python asyncio eager task factory 什么时候会改变执行顺序
- 497浏览 收藏
-
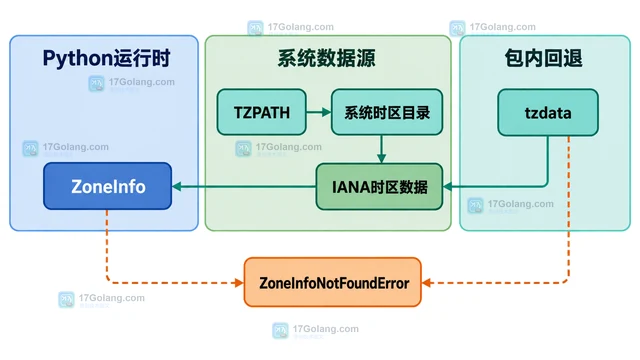
- 文章 · python教程 | 17小时前 |
- Python zoneinfo部署时区数据缺失的兼容处理
- 378浏览 收藏
-
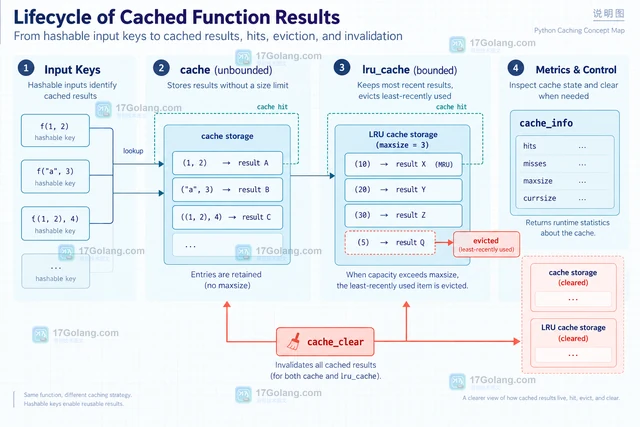
- 文章 · python教程 | 1天前 |
- Python functools.cache与lru_cache按场景选择的参数清单
- 211浏览 收藏
-
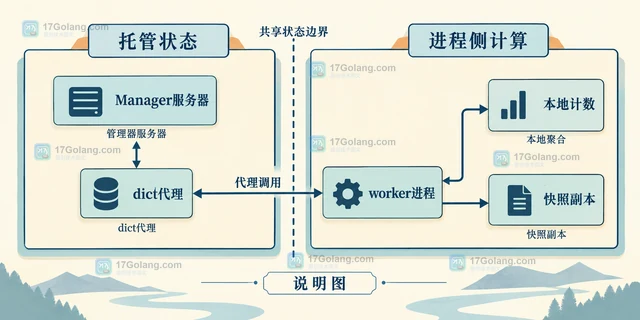
- 文章 · python教程 | 2天前 | python ·
- Python multiprocessing共享状态与进程安全队列的选择
- 316浏览 收藏
-
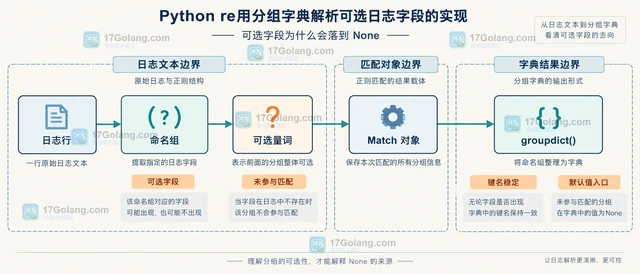
- 文章 · python教程 | 3天前 |
- Python re用分组字典解析可选日志字段的实现
- 470浏览 收藏
-
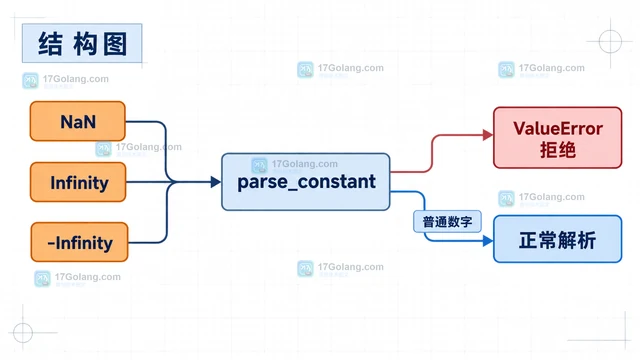
- 文章 · python教程 | 3天前 | JSON · python · Python NaN json.loads Infinity parse_constant
- Python json.loads解析非标准数字的容错边界
- 267浏览 收藏
-
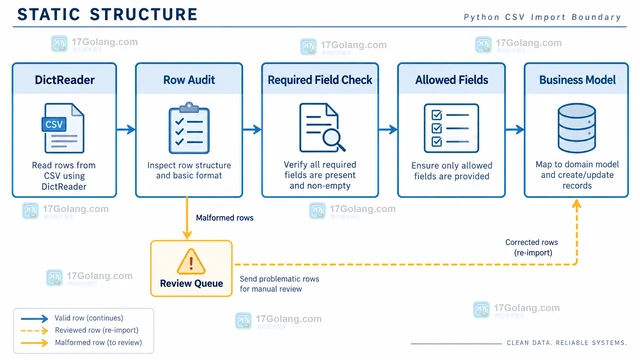
- 文章 · python教程 | 6天前 |
- Python csv.DictReader处理缺失列与额外列的办法
- 105浏览 收藏
-
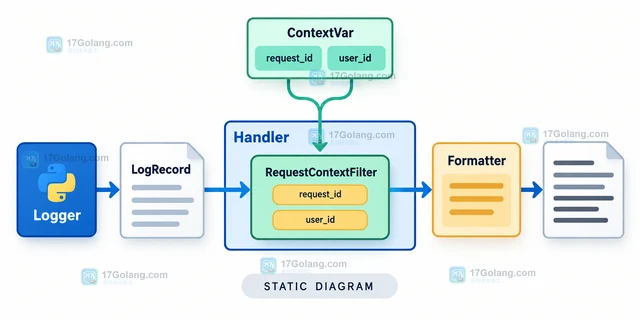
- 文章 · python教程 | 6天前 |
- Python logging按请求注入上下文字段的过滤器方案
- 324浏览 收藏
-
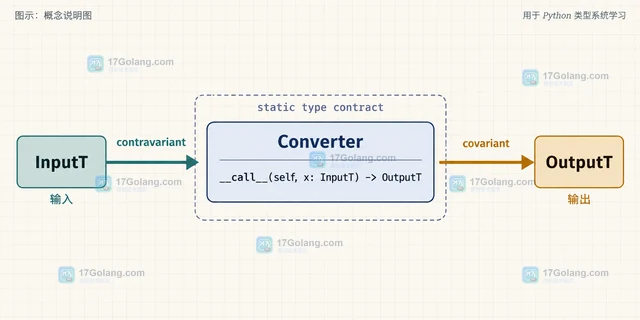
- 文章 · python教程 | 6天前 | Python教程 · Python 泛型 callable typing.Protocol 结构化子类型
- Python typing.Protocol配合泛型描述可调用对象的方式
- 355浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 234次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 278次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 246次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 229次使用
-
- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 28次使用
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览