
Llama4如何集成到APP|开发教程详解
想在手机APP里跑起Llama4大模型?本文直击移动端集成的核心痛点——模型太大、推理太慢、适配太难、接口太重,为你系统梳理四种落地路径:从高性能原生集成(llama.cpp+JNI)、开箱即用的本地服务(Ollama Mobile)、跨平台无感部署(MLC LLM+WebAssembly+Flutter WebView),到灵活可控的云端方案(Hugging Face TGI远程推理),每种都附带可复现的关键步骤与避坑提示,无论你是Android原生开发者、Flutter跨端工程师,还是后端协同者,都能快速找到适配自身技术栈与产品需求的最优解。

如果您希望将Llama4模型集成到移动应用程序中,但尚未确定可行的技术路径或面临部署障碍,则可能是由于模型体积大、推理延迟高、硬件适配复杂或缺乏轻量化接口支持。以下是实现Llama4在移动端集成的多种技术方案:
一、使用llama.cpp + JNI桥接Android原生集成
该方式通过C++推理引擎llama.cpp在设备端执行量化后的Llama4模型,借助JNI实现Java/Kotlin与底层C代码通信,兼顾性能与可控性。
1、从GitHub克隆最新版llama.cpp仓库,并确认其已支持Llama4架构(需检查commit日志或model.cpp中是否包含llama_v4_*相关定义)。
2、使用quantize工具对Llama4模型进行4-bit量化,生成gguf格式文件,例如:./quantize models/llama4-3b.Q4_K_M.gguf。
3、在Android Studio中新建C++支持模块,将llama.cpp的include/和src/目录导入,并配置CMakeLists.txt链接libllama.a静态库。
4、编写JNI函数JNIEXPORT jstring JNICALL Java_com_example_app_Llama4Bridge_runInference(JNIEnv *env, jobject thiz, jstring prompt),调用llama_eval和llama_token_to_str完成推理。
5、在Kotlin侧通过Llama4Bridge.runInference("你好")触发调用,接收返回的String结果。
二、通过Ollama Mobile封装为本地HTTP服务
利用Ollama Mobile提供的iOS/Android预编译二进制,在APP内启动嵌入式Ollama服务,以REST API方式调用Llama4,降低开发耦合度。
1、下载对应平台的Ollama Mobile release包(如ollama-darwin-arm64.zip或ollama-android-aarch64.tar.gz)。
2、将二进制文件放入App Bundle的Resources或assets目录,并在首次启动时复制至应用私有可执行路径(如getFilesDir().getAbsolutePath() + "/ollama")。
3、通过ProcessBuilder启动ollama serve命令,并监听localhost:11434端口是否就绪。
4、使用OkHttp向http://127.0.0.1:11434/api/chat发起POST请求,payload中指定model为llama4:latest(需预先运行ollama pull llama4)。
5、解析返回的SSE流数据,逐段提取response字段并拼接为完整响应文本。
三、采用MLC LLM编译为WebAssembly运行于Flutter WebView
借助MLC LLM框架将Llama4编译为WASM字节码,在Flutter应用的WebView中加载独立推理页面,实现跨平台一致行为且无需NDK开发。
1、在Linux x86_64环境安装mlc-llm,执行mlc_llm build --model /path/to/llama4 --target webgpu --quantization q4f16_1。
2、构建完成后获取dist/llama4_q4f16_1/目录,将其整体拷贝至Flutter项目的assets/web/子目录下。
3、创建index.html页面,引入mlc_llm_js.bundle.js,并初始化MLCEngine实例,设置model_path为/assets/web/llama4_q4f16_1/。
4、在Flutter中使用webview_flutter插件加载file:///android_asset/web/index.html(Android)或Bundle.loadString('assets/web/index.html')(iOS)。
5、通过JavaScriptChannel注册名为onInferenceComplete的回调,在JS中调用engine.chat.completions.create后触发Dart侧接收结果。
四、接入Hugging Face Text Generation Inference(TGI)远程服务
当设备端运行不可行时,可在自有服务器部署TGI服务托管Llama4,APP仅负责网络请求与UI渲染,适用于模型参数量超3B或需高频更新场景。
1、在具备CUDA 12.1+与A100显卡的服务器上拉取TGI镜像:docker run --gpus all -p 8080:80 -v $(pwd)/models:/data ghcr.io/huggingface/text-generation-inference:2.4.0 --model-id meta-llama/Llama-4-3b-instruct --quantize bitsandbytes-nf4 --dtype bfloat16。
2、验证服务可用性:curl http://localhost:8080/health;确认返回{"status":"ok"}。
3、在APP中配置OkHttp客户端启用HTTPS并信任自签名证书(若使用TLS),设置Base URL为https://your-tgi-domain.com。
4、构造POST请求至/v1/chat/completions,Header中添加Authorization: Bearer sk-xxx-your-api-key,Body中指定model为meta-llama/Llama-4-3b-instruct。
5、解析JSON响应中的choices[0].message.content字段作为最终输出。
今天带大家了解了的相关知识,希望对你有所帮助;关于科技周边的技术知识我们会一点点深入介绍,欢迎大家关注golang学习网公众号,一起学习编程~
 PHP虚拟主机404错误怎么解决
- 上一篇
- PHP虚拟主机404错误怎么解决

- 下一篇
- IOTA优雅定义日志级别常量(Debug/Info/Warn/Error)
-
- 科技周边 · 人工智能 | 1天前 |
- 讯飞绘文写活动通知怎么避免改错时间和地点
- 360浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 |
- Accelerate Accelerator.clip_grad_norm_ 怎样在混合精度训练中裁剪梯度
- 339浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 | 人工智能 · LoRa PEFT save_pretrained PeftModel 适配器权重
- PEFT PeftModel 怎样只保存适配器权重
- 468浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 |
- Transformers num_special_tokens_to_add 怎样计算输入的特殊词元开销
- 233浏览 收藏
-
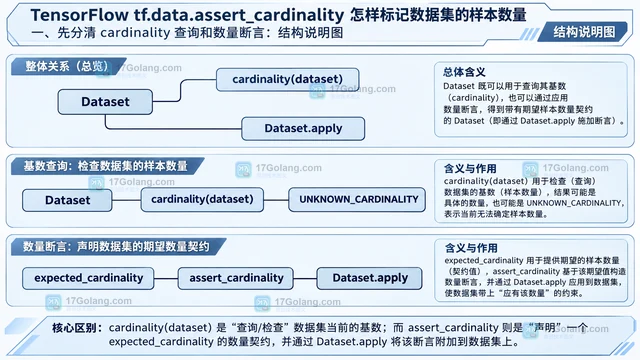
- 科技周边 · 人工智能 | 2天前 | TensorFlow dataset tf.data assert_cardinality
- TensorFlow tf.data.assert_cardinality 怎样标记数据集的样本数量
- 191浏览 收藏
-
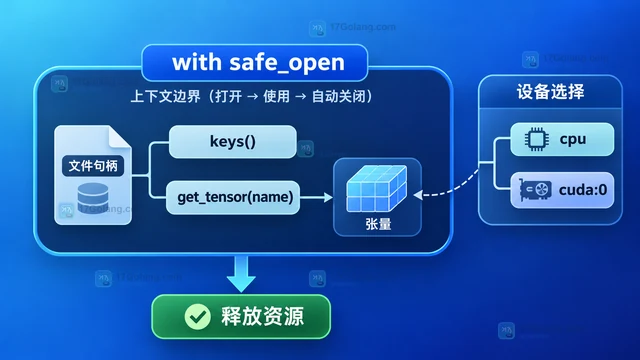
- 科技周边 · 人工智能 | 2天前 | PyTorch 模型权重 safetensors safe_open
- Safetensors safe_open 怎样按名称读取单个张量
- 368浏览 收藏
-
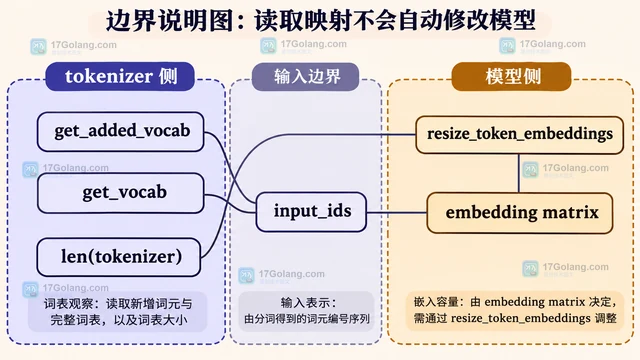
- 科技周边 · 人工智能 | 2天前 |
- Transformers get_added_vocab 怎样读取新增词元与编号映射
- 267浏览 收藏
-
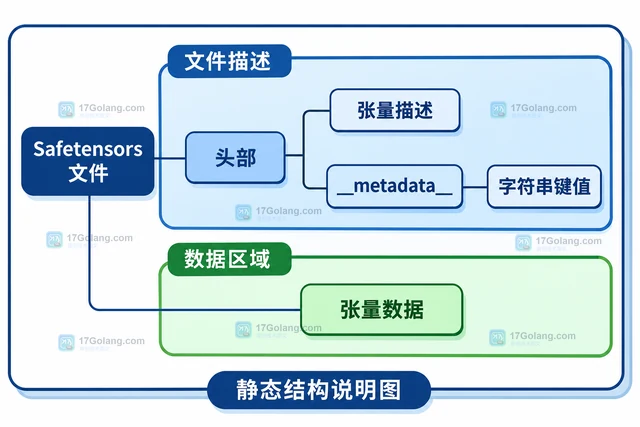
- 科技周边 · 人工智能 | 2天前 |
- Safetensors metadata 怎样读取文件元数据
- 358浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 |
- Transformers compute_transition_scores 怎样查看每个生成 token 的分数
- 321浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 |
- Transformers StopStringCriteria 怎样按结束字符串停止生成
- 443浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 | 人工智能 · Hugging Face 模型仓库 Hugging Face Hub HfApi list_repo_tree
- Hugging Face Hub HfApi.list_repo_tree 怎样列出模型仓库中的文件
- 429浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 | 人工智能 · PyTorch safetensors contiguous save_file transpose
- Safetensors 保存转置张量时怎样处理连续内存
- 165浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1171次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1154次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1335次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1280次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1137次使用
-
- 量化模型本地推理的显存估算方法
- 2026-10-17 501浏览
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览


