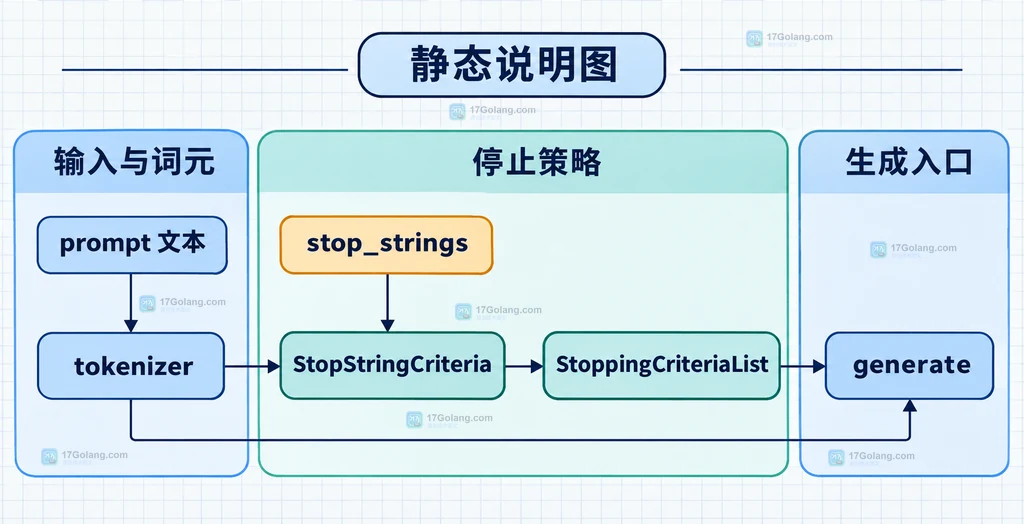
如果模型输出需要在出现 max_new_tokens 只能限制长度,不能表达业务结束条件。更合适的做法是用同一个 tokenizer 构造 StopStringCriteria,再放进 StoppingCriteriaList 交给 generate。
官方地址:https://huggingface.co/docs/transformers/main/en/internal/generation_utils
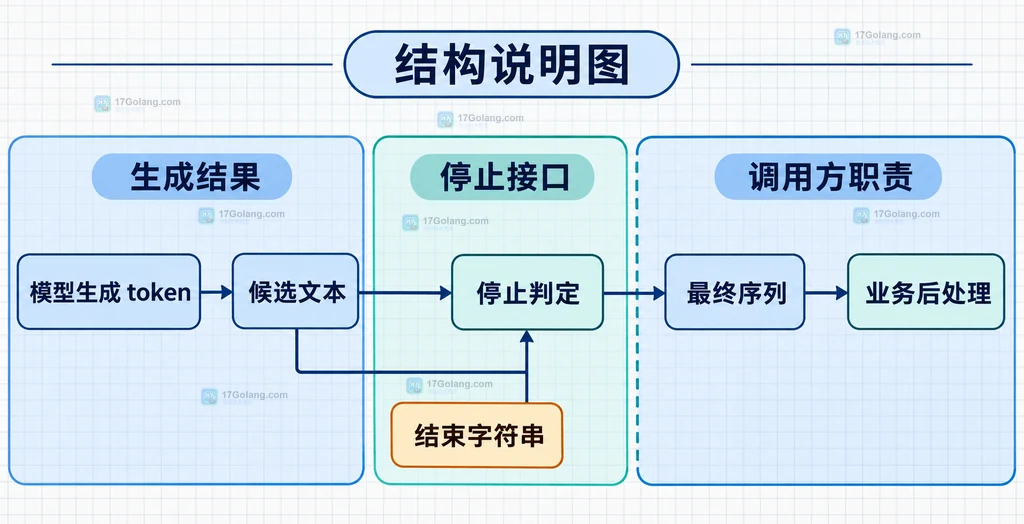
关键点是:停止条件负责“什么时候停”,tokenizer 负责把字符串映射到模型的词元边界,终止标记是否从最终文本中删除则属于业务层后处理。
StopStringCriteria 解决的不是长度限制
StopStringCriteria 针对的是“生成结果出现指定字符串就停止”这个问题。它和 max_new_tokens 的职责不同:前者关注内容边界,后者关注长度上限;两者可以同时设置,避免结束字符串没有出现时生成无限延长。
这个接口需要 tokenizer,因为结束字符串可能跨越多个 token,不能简单地把每次生成的 token 当成一个完整字符比较。停止条件也不是一个独立的字符串截断工具,它应该绑定到目标模型实际使用的 tokenizer,并通过生成接口统一管理。
用同一个 tokenizer 构造结束条件
下面的示例把 StopStringCriteria 接收 tokenizer 和一个字符串或字符串列表;多个标记可以放在同一停止条件中。
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    StopStringCriteria,
    StoppingCriteriaList,
)

model_name = "your-model-name"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)

prompt = "请用两句话概括下面的接口:"
inputs = tokenizer(prompt, return_tensors="pt")

# 结束字符串属于业务协议,使用模型配套 tokenizer 构造停止条件。
stop_rule = StopStringCriteria(
    tokenizer=tokenizer,
    stop_strings=[""],
)
stopping = StoppingCriteriaList([stop_rule])

output_ids = model.generate(
    **inputs,
    stopping_criteria=stopping,
    max_new_tokens=128,  # 没遇到结束标记时仍用长度上限兜底。
)

# 解码保留特殊标记,便于决定是否移除业务结束串。
text = tokenizer.decode(output_ids[0], skip_special_tokens=False)
print(text)
这里最容易出错的是 tokenizer 不一致:如果结束条件使用了另一套词表,模型实际生成的 token 边界和停止判断的假设就不再对应。max_new_tokens 仍然建议保留,它是结束字符串缺失或模型输出异常时的安全上限。
把条件交给 generate,而不是在循环外猜测
StoppingCriteriaList 是停止策略的组合容器。把条件交给 generate 后,生成过程可以在每轮追加 token 后统一判断;调用方只需要关心输入、输出和后处理,不必自己复制一套生成循环。
如果停止条件依赖 scores,官方文档要求同时打开 return_dict_in_generate=True 与 output_scores=True,否则传给条件的分数可能是 None。本例只依据生成文本中的结束字符串,因此不需要打开这两个选项。
| 接口 | 职责 | 使用判断 |
|---|---|---|
tokenizer | 把文本与 token 相互转换 | 必须和模型配套 |
StopStringCriteria | 声明字符串终止条件 | 内容边界明确时使用 |
StoppingCriteriaList | 组合停止规则 | 需要多个条件时扩展 |
max_new_tokens | 限制最大生成长度 | 作为兜底上限保留 |
终止标记与最终文本要分开处理
停止判定和文本清洗是两件事。生成通常需要先把能触发条件的 token 放进序列,再让停止条件返回停止信号;如果协议不希望把
decoded = tokenizer.decode(output_ids[0], skip_special_tokens=False)

# 只处理协议标记,不把普通文本中的同名片段全部删除。
marker = ""
if marker in decoded:
    final_text = decoded.split(marker, 1)[0].rstrip()
else:
    # 没有命中标记时保留原文,交给长度上限或上层策略处理。
    final_text = decoded

print(final_text)
常见问题
StopStringCriteria 能替代 max_new_tokens 吗?
不能。它们分别表达内容终止和长度上限;实际调用通常同时保留,避免结束字符串没有出现时失去边界。
为什么要传 tokenizer?
因为结束字符串的匹配要考虑模型的 token 化方式,使用不同 tokenizer 会让停止条件与实际生成序列不匹配。
停止后一定会自动删除结束字符串吗?
不要把删除行为当成停止条件的职责。先按协议决定是否保留,再在解码后的业务层做精确后处理。
最终可以把接口决策压缩成一句话:用配套 tokenizer 构造 StopStringCriteria,用 StoppingCriteriaList 组合规则,用 max_new_tokens 兜底,再由调用方决定终止标记的展示方式。
 Hugging Face Hub HfApi.list_repo_tree 怎样列出模型仓库中的文件