
Transformers get_added_vocab 怎样读取新增词元与编号映射
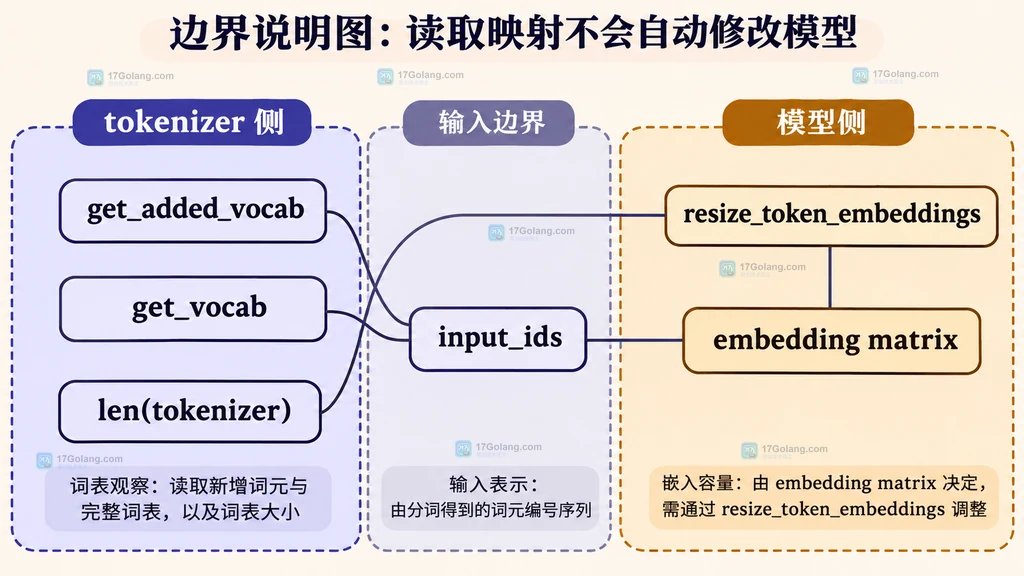
在 Transformers 里,想查看分词器当前登记的新增词元,直接调用 tokenizer.get_added_vocab()。它返回一个字典,键是词元字符串,值是对应的 token id;如果要看完整词表,再调用 tokenizer.get_vocab()。两者不要混用,更不要把 get_added_vocab() 的字典长度当成本次 add_tokens() 调用新增的数量。
官方地址:https://huggingface.co/docs/transformers/main/main_classes/tokenizer#get_added_vocab
读取映射只需要get_added_vocab();单次新增数量看add_tokens()的返回值;模型是否需要扩展嵌入矩阵,则是后续的模型兼容问题。
get_added_vocab 返回的到底是什么
get_added_vocab() 没有参数,返回类型是 dict[str, int]。它展示的是当前 tokenizer 状态中的新增词元映射,例如 {"。这个接口适合做词表检查、保存日志或根据词元反查编号,不会重新分词,也不会修改模型参数。
需要注意“新增”是相对于分词器的基础词表和附加词元状态而言,并不是“本次函数调用刚刚新增”。如果分词器之前已经添加过词元,下一次读取仍会看到它;某些特殊词元也可能出现在这份映射中。
from transformers import AutoTokenizer

# 使用同一份分词器状态,后续读取的编号才有明确上下文。
tokenizer = AutoTokenizer.from_pretrained("google-bert/bert-base-chinese")

# 这一步只扩展 tokenizer 的词元登记,不代表模型嵌入矩阵已经同步。
tokenizer.add_tokens(["", ""])

# 返回值是“新增词元 -> token id”,不是词元列表,也不是新增数量。
added_vocab = tokenizer.get_added_vocab()
for token, token_id in added_vocab.items():
    # 记录字符串和编号,便于后续与输入 id 或配置文件对照。
    print(f"{token} => {token_id}")
如果只关心某个词元,可以用字典的 get() 查询;查询结果为 None 时,表示当前新增映射里没有它。不要因为完整词表中能找到同一个字符串,就推断它一定是后来添加的。
怎样区分新增映射、完整词表和单次新增数
这三个结果回答的是不同问题:add_tokens() 的返回值回答“这一次实际增加了多少个词元”;get_added_vocab() 回答“当前附加词元有哪些、各自编号是什么”;get_vocab() 回答“当前可用词表的完整字符串到编号映射是什么”。
| 调用 | 适合回答的问题 | 不要这样理解 |
|---|---|---|
add_tokens(tokens) | 本次调用新增了几个词元 | 不是当前全部新增词元清单 |
get_added_vocab() | 附加词元到编号的映射 | 不是本次调用的增量日志 |
get_vocab() | 完整词表到编号的映射 | 不能单独证明某个词元何时加入 |
len(tokenizer) | 当前 tokenizer 词表规模 | 不是新增词元数量 |
# 先保存本次调用的返回值,它才是本次新增数量。 added_count = tokenizer.add_tokens(["", " ", " "]) # 读取累计状态;重复添加或之前已存在的词元不应被当作本次新增。 added_vocab = tokenizer.get_added_vocab() full_vocab = tokenizer.get_vocab() print("本次新增数量:", added_count) print("当前新增映射数量:", len(added_vocab)) print("当前完整词表数量:", len(full_vocab)) # 用明确的键查询,避免把完整词表的存在误认为新增状态。 print("order id:", added_vocab.get(" "))
普通词元和特殊词元怎样分别读取
普通词元通常通过 add_tokens() 登记,特殊词元则常通过 add_special_tokens() 登记。两者都可能进入 tokenizer 的附加词元体系,但特殊词元还会影响解码时的跳过规则,以及 tokenizer 上的 pad_token、cls_token 等属性。
因此,排查映射时建议同时记录词元字符串、编号和来源类别,而不是只输出一串 id。尤其在批处理脚本中,先读取 get_added_vocab() 再按业务前缀筛选,可以避免把完整词表中的普通词元误列为自定义词元。
# 特殊词元通过专用接口登记,读取时仍可从新增映射中看到它。
special_count = tokenizer.add_special_tokens({"additional_special_tokens": [""]})
added_vocab = tokenizer.get_added_vocab()

# 只筛选本项目约定的前缀,不把所有特殊词元都当成业务字段。
project_tokens = {
    token: token_id
    for token, token_id in added_vocab.items()
    if token.startswith("")
}

print("本次特殊词元新增数量:", special_count)
print("项目词元映射:", project_tokens)
这里的筛选是观察动作,不会改变词表。若需要保存结果,建议保存完整映射和筛选规则,而不是只保存排序后的编号列表;这样以后更容易判断词元名称发生了什么变化。
读取映射时不要越过模型嵌入边界
get_added_vocab() 只提供 tokenizer 侧的登记信息。它不会检查模型的输入嵌入矩阵是否已经覆盖这些编号,也不会自动调用 resize_token_embeddings()。因此,本文的读取代码可以用于盘点、审计和生成配置,但不能据此宣称模型已经可以安全训练或推理。
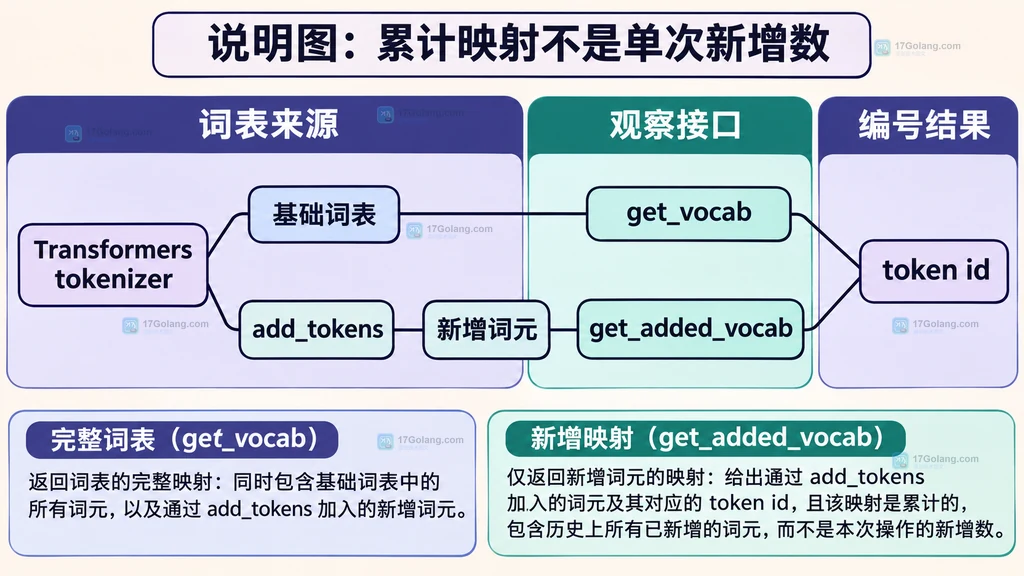
如果业务确实要让模型使用新词元,应该把“读取映射”和“同步模型结构”拆成两个明确阶段:先确认 tokenizer 的词元和编号,再根据模型文档决定是否扩展嵌入矩阵,并为新增行设计初始化、训练和保存策略。仅查看映射时,不需要修改训练权重。
另外,官方文档提示不同 tokenizer 实现对“已经存在于基础词表中的词元”可能有不同处理细节。跨 slow/fast 实现迁移时,不要只比较字典长度,应同时比较词元字符串、编号和实际序列化配置。
常见问题
为什么 get_added_vocab() 的数量比本次新增数大? 因为前者是当前 tokenizer 的累计附加状态,后者是本次 add_tokens() 返回的增量结果。
为什么完整词表能找到词元,却不在新增映射里? 它可能是基础词表原本就有的词元。get_vocab() 只说明当前可用,不说明加入来源。
读取新增映射会自动改变模型吗? 不会。该接口只返回字典;模型嵌入矩阵、训练权重和 checkpoint 保存都需要独立处理。
小结
读取 Transformers 新增词元的最短路径是 tokenizer.get_added_vocab(),它给出 token 到 id 的映射。需要单次增量时保存 add_tokens() 返回值,需要完整词表时使用 get_vocab()。把这三种结果分开记录,就能避免把累计状态、完整词表和模型嵌入矩阵混成一个概念。
 Safetensors metadata 怎样读取文件元数据
- 上一篇
- Safetensors metadata 怎样读取文件元数据
- 下一篇
- Safetensors safe_open 怎样按名称读取单个张量
-
- 科技周边 · 人工智能 | 18分钟前 | TensorFlow dataset tf.data assert_cardinality
- TensorFlow tf.data.assert_cardinality 怎样标记数据集的样本数量
- 191浏览 收藏
-
- 科技周边 · 人工智能 | 25分钟前 | PyTorch 模型权重 safetensors safe_open
- Safetensors safe_open 怎样按名称读取单个张量
- 368浏览 收藏
-
- 科技周边 · 人工智能 | 27分钟前 |
- Safetensors metadata 怎样读取文件元数据
- 358浏览 收藏
-
- 科技周边 · 人工智能 | 41分钟前 |
- Transformers compute_transition_scores 怎样查看每个生成 token 的分数
- 321浏览 收藏
-
- 科技周边 · 人工智能 | 44分钟前 |
- Transformers StopStringCriteria 怎样按结束字符串停止生成
- 443浏览 收藏
-
- 科技周边 · 人工智能 | 48分钟前 | 人工智能 · Hugging Face 模型仓库 Hugging Face Hub HfApi list_repo_tree
- Hugging Face Hub HfApi.list_repo_tree 怎样列出模型仓库中的文件
- 429浏览 收藏
-
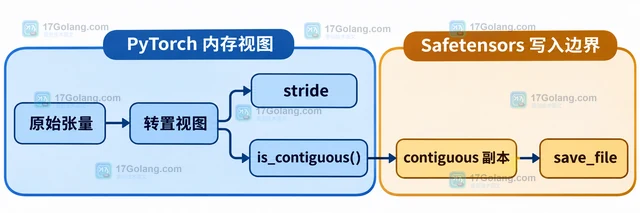
- 科技周边 · 人工智能 | 19小时前 | 人工智能 · PyTorch safetensors contiguous save_file transpose
- Safetensors 保存转置张量时怎样处理连续内存
- 165浏览 收藏
-
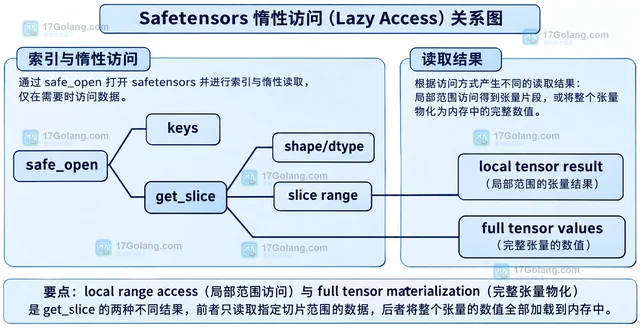
- 科技周边 · 人工智能 | 19小时前 |
- Safetensors 怎样只读取张量元数据而不加载全部权重
- 240浏览 收藏
-
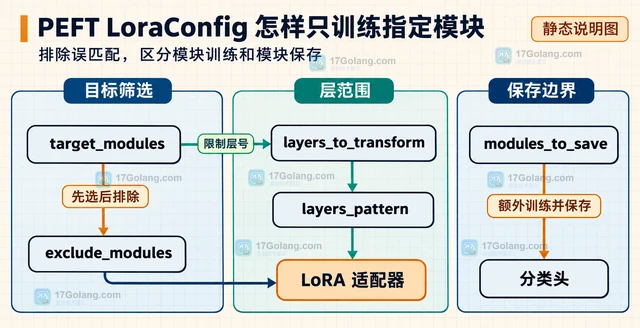
- 科技周边 · 人工智能 | 19小时前 | 人工智能 · LoRa PEFT target_modules modules_to_save LoraConfig exclude_modules
- PEFT LoraConfig 怎样只训练指定模块
- 289浏览 收藏
-
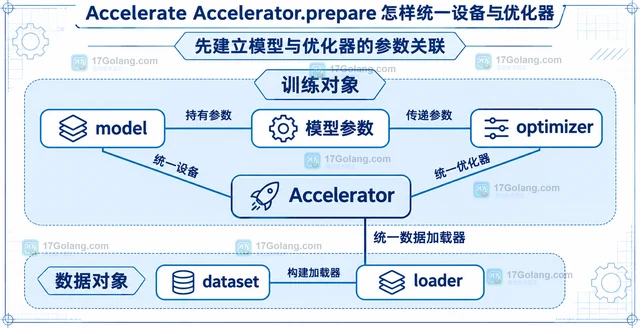
- 科技周边 · 人工智能 | 19小时前 |
- Accelerate Accelerator.prepare 怎样统一设备与优化器
- 382浏览 收藏
-
- 科技周边 · 人工智能 | 20小时前 | python · 数据处理 · 人工智能 · 数据集 dataset Hugging Face Datasets set_transform 模型输入
- Hugging Face Datasets set_transform 怎样按需生成样本字段
- 258浏览 收藏
-
- 科技周边 · 人工智能 | 20小时前 | 人工智能 · Transformers AutoConfig from_pretrained 模型配置 不加载权重
- Transformers AutoConfig 怎样在加载模型前查看配置
- 132浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1139次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1123次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1299次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1237次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1090次使用
-
- 量化模型本地推理的显存估算方法
- 2026-10-17 501浏览
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览


