
Life-Death区间最大值计算教程
本文深入讲解了如何在 Polars 中巧妙实现基于语义边界(“Life”起始、“Death”终止)的动态区间划分与聚合计算——不依赖原生区间分组功能,而是通过 cum_sum()、forward_fill() 和 shift() 等向量化操作构建精准的 group_id,再结合 when/then 条件逻辑仅将每段区间内指定列的最大值回填至对应的“Life”行,其余位置保持 null;方法高效、简洁、零拷贝,完美适配大规模数据场景,并具备强扩展性,可轻松迁移至 START/END 标记、多列聚合或自定义窗口计算等实际业务需求。

本文介绍如何在 Polars 中为每个以 "Life" 开头、以 "Death" 结尾的连续区间,高效计算指定列(如 Column A)的最大值,并仅将结果填充至对应 "Life" 行,其余行置为 null。
本文介绍如何在 Polars 中为每个以 "Life" 开头、以 "Death" 结尾的连续区间,高效计算指定列(如 `Column A`)的最大值,并仅将结果填充至对应 "Life" 行,其余行置为 `null`。
在数据处理中,常需基于语义边界(如状态标记 "Life" 和 "Death")划分逻辑区间,并对区间内数值列进行聚合。Polars 本身不提供原生的“区间分组”操作,但可通过累积运算与条件逻辑组合构建等效的分组标识(group_id),再结合 over() 实现分组聚合。该方法兼具性能优势与表达简洁性,适用于大规模数据场景。
以下为完整实现步骤(含可运行代码):
✅ 步骤一:构造区间分组 ID
核心思想是:
- 每次遇到 "Life",视为新区间开始;
- 每次遇到 "Death",视为当前区间结束;
- 同一 "Life" 到其后首个 "Death"(含)之间的所有行属于同一组;
- "Death" 行本身不参与聚合,但需将其 group_id 归入前一 "Life" 所属组(即向后对齐)。
利用 cum_sum() 和 forward_fill() 构建基础分组信号,再通过 shift() 校正 "Death" 行归属:
import polars as pl

df = pl.DataFrame({
    "Column A": [2, 3, 1, 4, 1, 3, 3, 2, 1, 0],
    "Column B": ["Life", None, None, None, "Death", None, "Life", None, None, "Death"]
})

# 定义布尔标记
is_life = pl.col("Column B") == "Life"
is_death = pl.col("Column B") == "Death"

# 构建 group_id:先累加 life/death 事件,再前向填充 → 得到初步分组
group_id = (is_life.cum_sum() + is_death.cum_sum()).forward_fill()

# 关键校正:将 Death 行的 group_id 替换为其前一行的值(即归入前一个 Life 区间)
group_id = pl.when(is_death).then(group_id.shift()).otherwise(group_id)
? 说明:group_id.shift() 默认向前移动一行(n=1),因此 "Death" 行获得其前一 "Life" 所启动区间的 ID,确保后续 max().over(group_id) 能正确覆盖整个区间。
✅ 步骤二:按组聚合并条件赋值
使用 pl.when(...).then(...).otherwise(...) 实现:仅当行为 "Life" 时,填入其所属 group_id 内 Column A 的最大值;其余行(null 或 "Death")保持 null:
result = df.with_columns(
    pl.when(is_life)
      .then(pl.col("Column A").max().over(group_id))
      .alias("Column C")
)

print(result)
输出结果完全匹配预期:
shape: (10, 3)
┌──────────┬──────────┬──────────┐
│ Column A ┆ Column B ┆ Column C │
│ ---      ┆ ---      ┆ ---      │
│ i64      ┆ str      ┆ i64      │
╞══════════╪══════════╪══════════╡
│ 2        ┆ Life     ┆ 4        │
│ 3        ┆ null     ┆ null     │
│ 1        ┆ null     ┆ null     │
│ 4        ┆ null     ┆ null     │
│ 1        ┆ Death    ┆ null     │
│ 3        ┆ null     ┆ null     │
│ 3        ┆ Life     ┆ 3        │
│ 2        ┆ null     ┆ null     │
│ 1        ┆ null     ┆ null     │
│ 0        ┆ Death    ┆ null     │
└──────────┴──────────┴──────────┘
⚠️ 注意事项与最佳实践
- 空值安全:pl.col("Column B") == "Life" 自动处理 None(返回 False),无需额外 fill_null();
- 类型一致性:max().over(...) 返回与原始列一致的类型(此处为 i64),若需浮点型可显式 .cast(pl.Float64);
- 边界鲁棒性:若末尾无 "Death"(如 "Life" 后无终止标记),该方案会将 "Life" 至数据末尾视为一个开放区间——可根据业务需求添加兜底逻辑(例如 pl.when(is_life).then(...).otherwise(pl.lit(None)));
- 性能提示:所有操作均为惰性求值、零拷贝,适合百万级以上数据;避免在循环中调用 to_pandas() 或 collect() 中断执行链。
此模式可轻松泛化至其他边界标记(如 "START"/"END")、多列聚合(.max().over(...).min().over(...))或自定义窗口函数(如 pl.col("A").rolling_max(window_size=...).over(...)),是 Polars 高级分组场景的经典范式。
文中关于的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《Life-Death区间最大值计算教程》文章吧,也可关注golang学习网公众号了解相关技术文章。
 关闭Windows杀毒和实时防护教程
- 上一篇
- 关闭Windows杀毒和实时防护教程

- 下一篇
- 美团外卖双11券领取教程图解
-
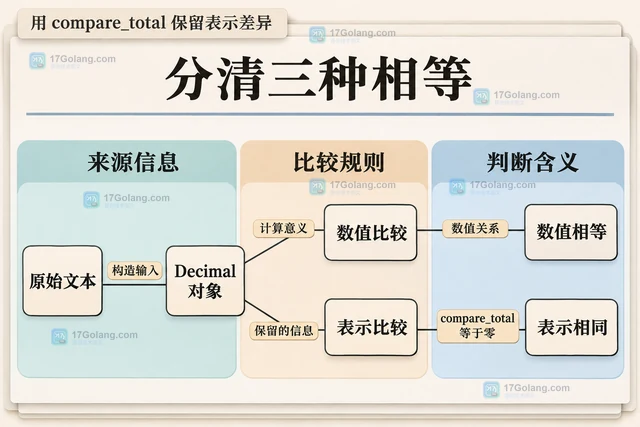
- 文章 · python教程 | 1天前 | python · Python decimal compare_total 全序比较
- Python Decimal.compare_total 怎样区分数值相等的不同表示
- 331浏览 收藏
-
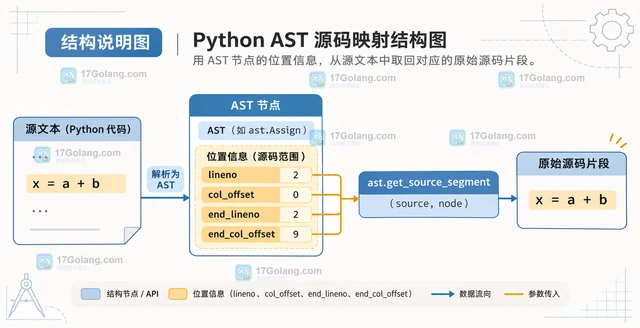
- 文章 · python教程 | 1天前 |
- Python AST 怎样提取节点对应的原始源码片段
- 261浏览 收藏
-
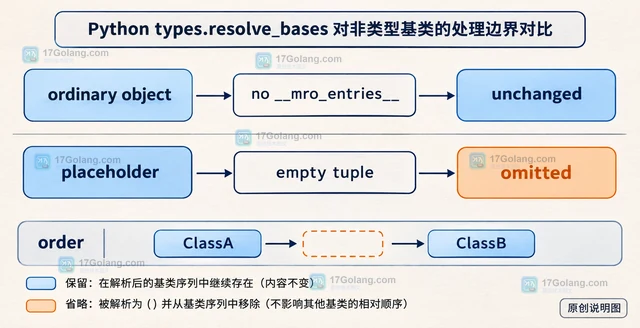
- 文章 · python教程 | 1天前 | python · 类型系统 · Python types.resolve_bases __mro_entries__
- Python types.resolve_bases 怎样展开动态基类占位对象
- 108浏览 收藏
-
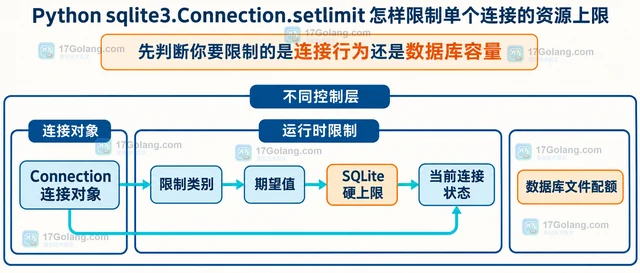
- 文章 · python教程 | 1天前 | Python SQLite sqlite3 getlimit Connection.setlimit
- Python sqlite3.Connection.setlimit 怎样限制单个连接的资源上限
- 247浏览 收藏
-
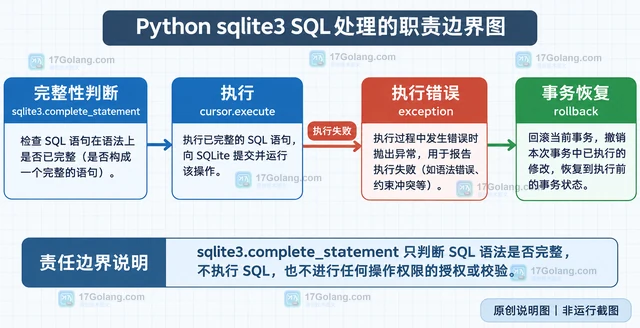
- 文章 · python教程 | 1天前 | SQLite · Python教程 · Python SQLite sqlite3 complete_statement 多语句脚本 CREATE TRIGGER
- Python sqlite3.complete_statement 判断多语句输入完整性的处理方案
- 140浏览 收藏
-
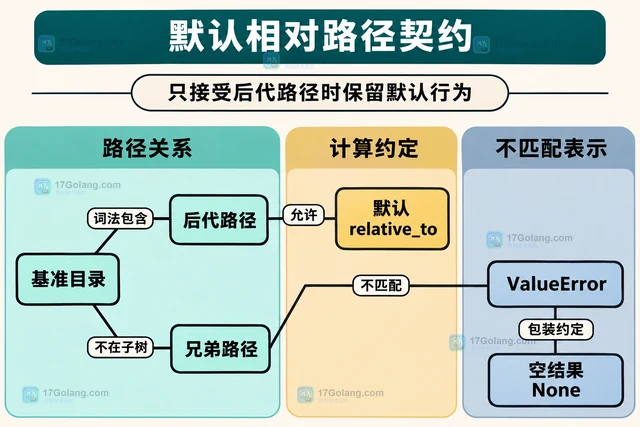
- 文章 · python教程 | 1天前 | python · pathlib · Python pathlib walk_up relative_to
- Python pathlib.relative_to 怎样避免无关路径抛错
- 256浏览 收藏
-
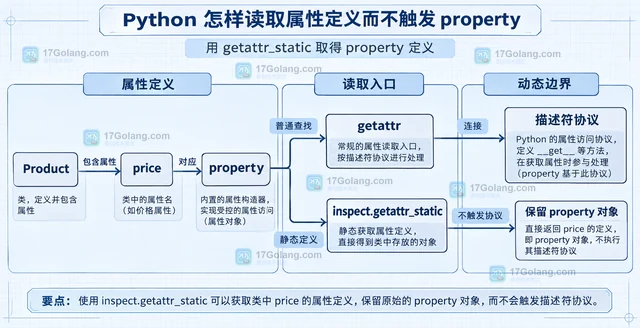
- 文章 · python教程 | 1天前 | python · Python Property 描述符 inspect.getattr_static 静态属性读取
- Python 怎样读取属性定义而不触发 property
- 299浏览 收藏
-
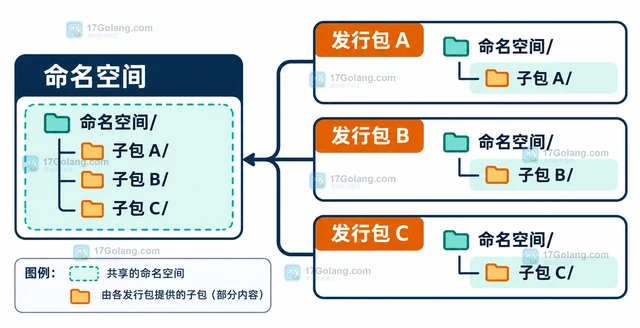
- 文章 · python教程 | 1天前 | 依赖管理 · 故障排查 · Python教程 · Python importlib.metadata packages_distributions 发行包 导入名
- Python 怎样根据导入名查询对应的发行包
- 138浏览 收藏
-
- 文章 · python教程 | 1天前 | 数据校验 · Python教程 · Python Pydantic JSON校验 model_validate_json strict mode
- Pydantic model_validate_json 怎样在严格模式下解析请求体
- 417浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1084次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1084次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1247次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1191次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1037次使用
-
- Python TaskGroup 怎样让子任务失败统一收敛
- 2026-11-12 501浏览
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览


