
Python pathlib.Path.walk 怎么剪枝目录遍历
来源:17golang原创
2026-09-27 02:36:37
0浏览
收藏
Path.walk() 剪枝的核心只有一句:保持 top_down=True,在遍历当前目录时原地修改 dirnames。被移除的目录不会继续递归。不能只写 dirnames = [...],因为这只是让局部变量指向新列表,遍历器仍持有原来的列表。
要点速览
- 剪枝只在
top_down=True时有效,这是Path.walk()的默认值。 - 使用
dirnames[:]、remove()或del原地修改目录列表。 - 默认不跟随目录符号链接;开启后要自行防止循环,并用
on_error决定错误策略。
用原地切片赋值跳过整个子树
下面的生成器只返回 Python 文件,并在进入子目录前排除常见的大型无关目录。dirpath 是 Path,而 dirnames、filenames 是名称字符串列表,因此最终路径要用 dirpath / filename 拼接。
from pathlib import Path

SKIP_DIRS = {".git", ".venv", "__pycache__", "node_modules"}

def walk_python_files(root: Path):
    def handle_error(exc: OSError) -> None:
        # 这里选择记录后继续;严格任务可以改成 raise exc。
        print(f"跳过无法访问的目录: {exc.filename}: {exc}")

    for dirpath, dirnames, filenames in root.walk(
        top_down=True,
        on_error=handle_error,
        follow_symlinks=False,
    ):
        # 必须原地改列表,Path.walk 才能看到剪枝结果。
        dirnames[:] = [name for name in dirnames if name not in SKIP_DIRS]

        for filename in filenames:
            path = dirpath / filename
            if path.suffix == ".py":
                yield path
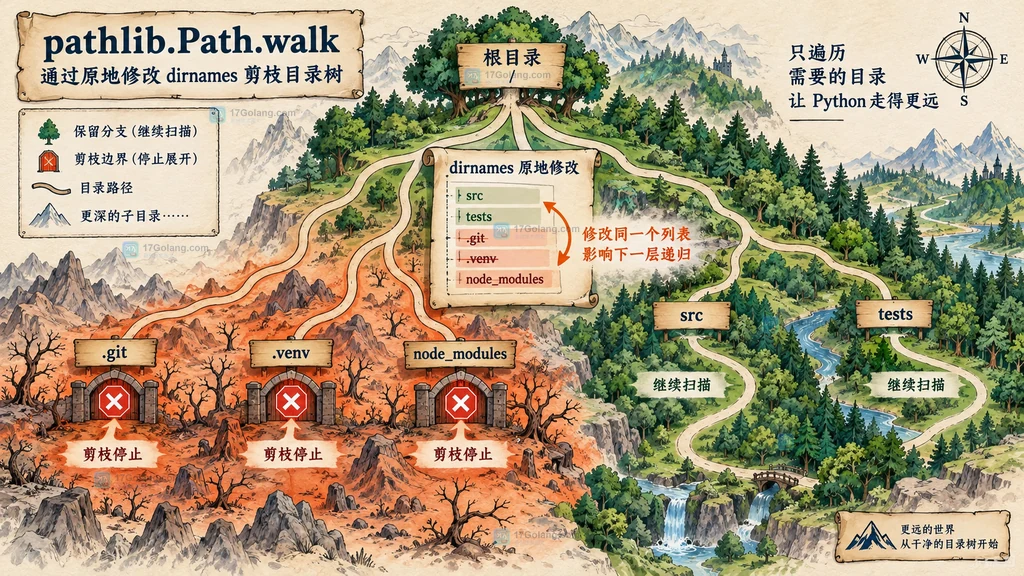
如果只想删除单项,也可以写 dirnames.remove(".git");规则较多时,切片赋值更清楚。需要稳定扫描顺序时,可在过滤后调用 dirnames.sort()。
固定名称之外,还可以按完整路径剪枝
有些目录名称本身没有问题,但目录内存在 .noindex、.generated 等标记时就应跳过。过滤条件可以同时查看名称和即将进入的完整路径:
def should_enter(parent: Path, name: str) -> bool:
    candidate = parent / name
    if name.startswith(".") and name not in {".config"}:
        return False
    if (candidate / ".noindex").exists():
        return False
    return True

for dirpath, dirnames, filenames in Path("src").walk(top_down=True):
    dirnames[:] = [name for name in dirnames if should_enter(dirpath, name)]
    # 此处处理 filenames
这种规则适合生成目录、归档目录或业务侧明确标记为“不扫描”的目录。不要在过滤函数里读取大量文件内容,否则剪枝节省的遍历成本可能又被额外 I/O 抵消。
符号链接和访问错误要单独决定
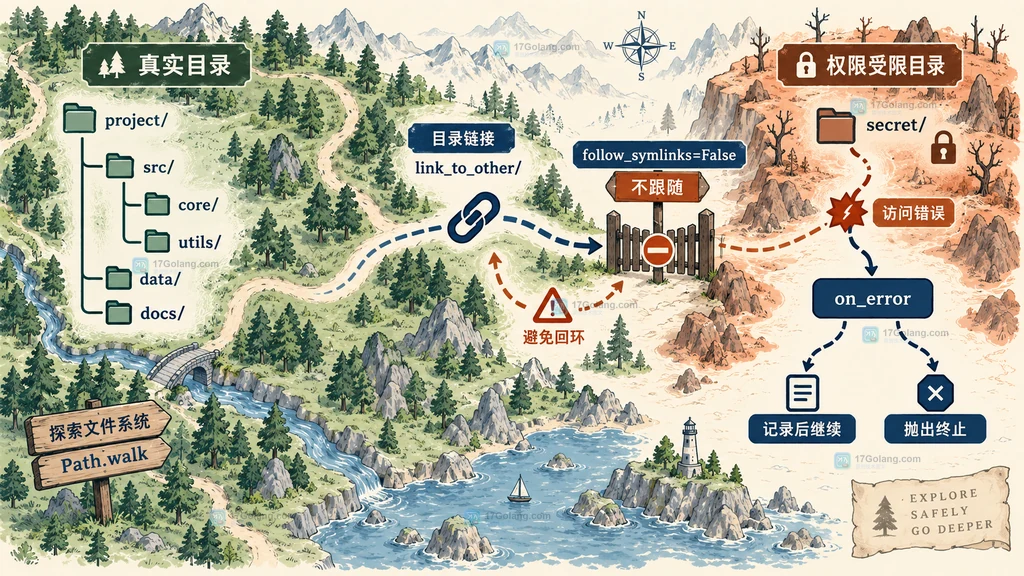
follow_symlinks=False 是默认值。目录符号链接不会被当作普通子目录继续递归,而会出现在 filenames 中。若改为 True,Path.walk() 不会自动记录已访问目录,链接环可能造成无限递归;此时应按设备号与 inode 保存已访问集合,或继续保持默认设置。
| 需求或现象 | 正确处理 | 原因 |
|---|---|---|
| 跳过固定目录 | 原地过滤 dirnames | 遍历器会读取同一个列表决定下一层 |
| 过滤后仍进入目录 | 检查是否写成 dirnames = [...] | 重绑定不会改变原列表 |
| top_down=False 时剪枝无效 | 改回 top_down=True | 自底向上时子目录已经生成 |
| 部分目录无权限 | 提供 on_error 回调 | 可以记录后继续,也可重新抛出 |
常见问题
为什么 dirnames = filtered 没有效果?
因为它只替换了局部变量引用。请使用 dirnames[:] = filtered,或对原列表调用 remove、del。
可以在 top_down=False 时修改 dirnames 吗?
可以修改列表本身,但不能影响递归结果,因为子目录在返回当前目录之前已经遍历完成。需要剪枝时必须使用 top_down=True。
版本声明
本文转载于:17golang原创 如有侵犯,请联系study_golang@163.com删除
 mifun乐园怎么分享漫画?搜索、收藏与一键分享功能说明
- 上一篇
- mifun乐园怎么分享漫画?搜索、收藏与一键分享功能说明
- 下一篇
- painter绘画助手界面怎么自定义?工具停靠与工作区整理说明
查看更多
最新文章
-
- 文章 · python教程 | 3小时前 | python · SQLite · Python sqlite3 autocommit isolation_level SQLite事务
- Python sqlite3 autocommit 与 isolation_level 怎么配合
- 378浏览 收藏
-
- 文章 · python教程 | 8小时前 | 并发 · 异步编程 · Python教程 · Python 任务调度 asyncio eager_task_factory
- Python asyncio eager task factory 什么时候会改变执行顺序
- 497浏览 收藏
-
- 文章 · python教程 | 11小时前 |
- Python zoneinfo部署时区数据缺失的兼容处理
- 378浏览 收藏
-
- 文章 · python教程 | 1天前 |
- Python functools.cache与lru_cache按场景选择的参数清单
- 211浏览 收藏
-
- 文章 · python教程 | 2天前 | python ·
- Python multiprocessing共享状态与进程安全队列的选择
- 316浏览 收藏
-
- 文章 · python教程 | 3天前 |
- Python re用分组字典解析可选日志字段的实现
- 470浏览 收藏
-
- 文章 · python教程 | 3天前 | JSON · python · Python NaN json.loads Infinity parse_constant
- Python json.loads解析非标准数字的容错边界
- 267浏览 收藏
-
- 文章 · python教程 | 6天前 |
- Python csv.DictReader处理缺失列与额外列的办法
- 105浏览 收藏
-
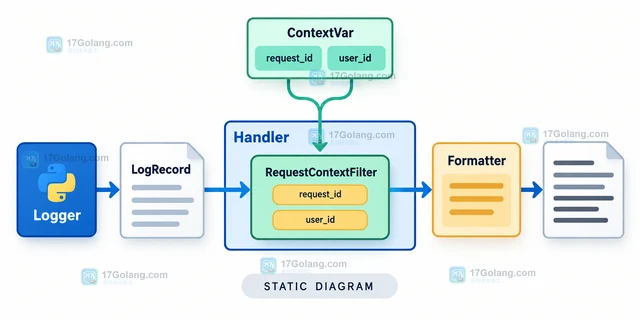
- 文章 · python教程 | 6天前 |
- Python logging按请求注入上下文字段的过滤器方案
- 324浏览 收藏
-
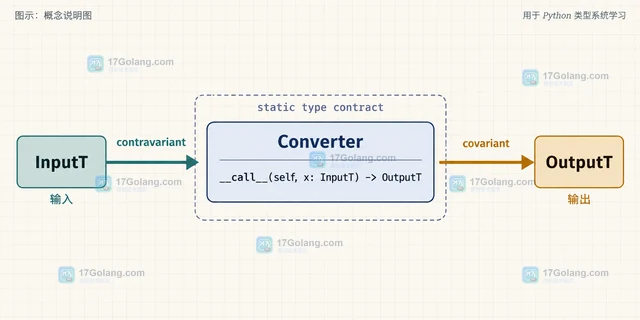
- 文章 · python教程 | 6天前 | Python教程 · Python 泛型 callable typing.Protocol 结构化子类型
- Python typing.Protocol配合泛型描述可调用对象的方式
- 355浏览 收藏
-
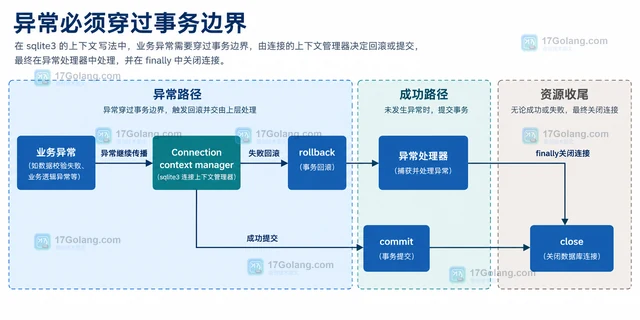
- 文章 · python教程 | 6天前 |
- Python sqlite3事务提交与异常回滚的上下文写法
- 357浏览 收藏
-
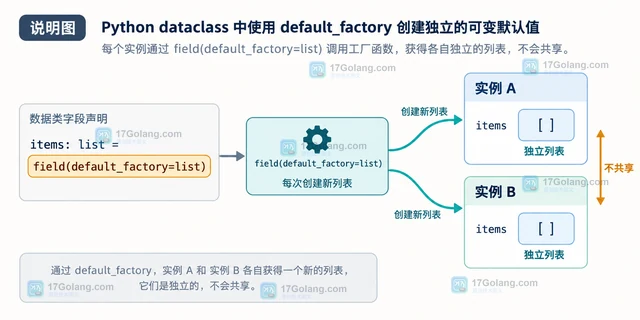
- 文章 · python教程 | 6天前 |
- Python dataclass用field配置默认工厂的对象设计
- 114浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 229次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 275次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 242次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 222次使用
-
- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 22次使用
查看更多
相关文章
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览