
Python uuid7 怎么生成按时间排序的标识
从 Python 3.14 开始,标准库可以直接调用 uuid.uuid7() 生成 UUIDv7。它把 Unix 毫秒时间放在标识的高位,所以生成时间较早的值通常也排在前面;同一毫秒内则由计数器维持单调性。最小答案只有两行:
import uuid

order_id = uuid.uuid7()  # 生成一个带毫秒时间的 UUIDv7
print(order_id)
UUIDv7 适合订单号、事件号、日志记录主键等“需要 UUID 格式,同时希望索引写入更集中”的场景。它能提供按生成时间大致排列的标识,但不应被当成跨机器的绝对事件顺序,也不应代替真正的业务时间字段。
先确认运行环境:标准库实现从 Python 3.14 开始
uuid.uuid7() 是 Python 3.14 新增接口。如果旧环境报 AttributeError: module 'uuid' has no attribute 'uuid7',先检查版本,不要在同名的 uuid.py 文件里反复找原因。
import sys
import uuid

print(sys.version_info[:3])  # 应为 3.14 或更高版本
if not hasattr(uuid, "uuid7"):
    raise RuntimeError("当前 Python 标准库尚不支持 uuid.uuid7,请升级到 3.14+")
标准库接口与字段说明可直接查看 https://docs.python.org/3/library/uuid.html。在必须继续使用旧 Python 时,可以选用实现 RFC 9562 的维护中第三方库,但要把依赖名称和版本固定到项目配置中,不能把第三方包与标准库接口混为一谈。
生成标识并读取毫秒时间
UUID.time 对 UUIDv7 返回自 Unix 纪元起的毫秒数。展示给用户时需要明确时区;写入数据库时,通常保留原始 UUID,并单独保存业务发生时间。
from datetime import datetime, timezone
import uuid

record_id = uuid.uuid7()  # 标准库生成 UUIDv7
created_at = datetime.fromtimestamp(record_id.time / 1000, tz=timezone.utc)

print(str(record_id))     # 标准的 36 字符 UUID 表示
print(record_id.version)  # 版本号应为 7
print(record_id.time)     # Unix 毫秒时间戳
print(created_at.isoformat())
这里除以 1000,是因为 datetime.fromtimestamp() 接收秒,而 UUIDv7 的 time 是毫秒。不要把它与 UUIDv1、UUIDv6 的 100 纳秒时间单位混用。
UUIDv7 为什么能按时间排列
UUIDv7 的高 48 位是 Unix 毫秒时间戳。Python 的实现还使用 42 位计数器,保证在同一毫秒内连续生成的 UUID 保持单调。版本位、变体位和其余随机位共同维持标准 UUID 布局。由于 UUID 对象比较的是 128 位整数值,高位时间自然先参与比较。
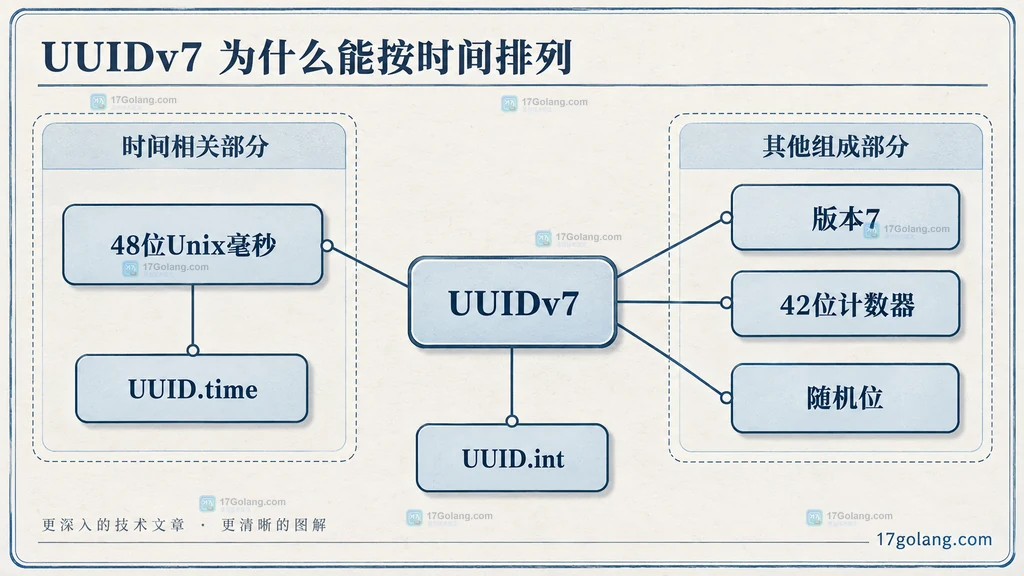
“可按时间排序”并不等于 ID 文本内保存了完整业务语义。它只说明标识值的主要排序前缀来自生成时刻。订单的支付时间、消息的接收时间等仍应拥有独立字段。
对象排序和字符串排序怎么写
如果列表中保留的是 UUID 对象,直接调用 sorted() 即可。标准带连字符字符串的字段位置固定,按字符串升序也能保持 UUIDv7 的字典序;不过应用内部优先保留 UUID 对象,能避免混入其他版本或无效文本。
import uuid

ids = [uuid.uuid7() for _ in range(5)]  # 同一毫秒内也保持单调

for value in sorted(ids):
    print(value, value.time)

text_ids = [str(value) for value in ids]
sorted_text_ids = sorted(text_ids)       # 固定格式字符串也可按字典序排列
从外部接收字符串时,先解析并检查版本,再排序:
import uuid

def parse_uuid7(raw: str) -> uuid.UUID:
    value = uuid.UUID(raw)  # 校验 UUID 文本格式
    if value.version != 7:
        raise ValueError("只接受 UUIDv7")
    return value

ordered = sorted(parse_uuid7(raw) for raw in text_ids)
排序、存储与跨节点边界
数据库如果提供原生 UUID 类型,应优先使用原生类型;否则可用 16 字节二进制字段。把 UUID 保存成 36 字符文本虽然直观,但空间占用更大。UUIDv7 的时间前缀通常比 UUIDv4 的完全随机分布更有利于 B-tree 索引局部性,不过最终效果还取决于数据库实现、页大小和写入模式。
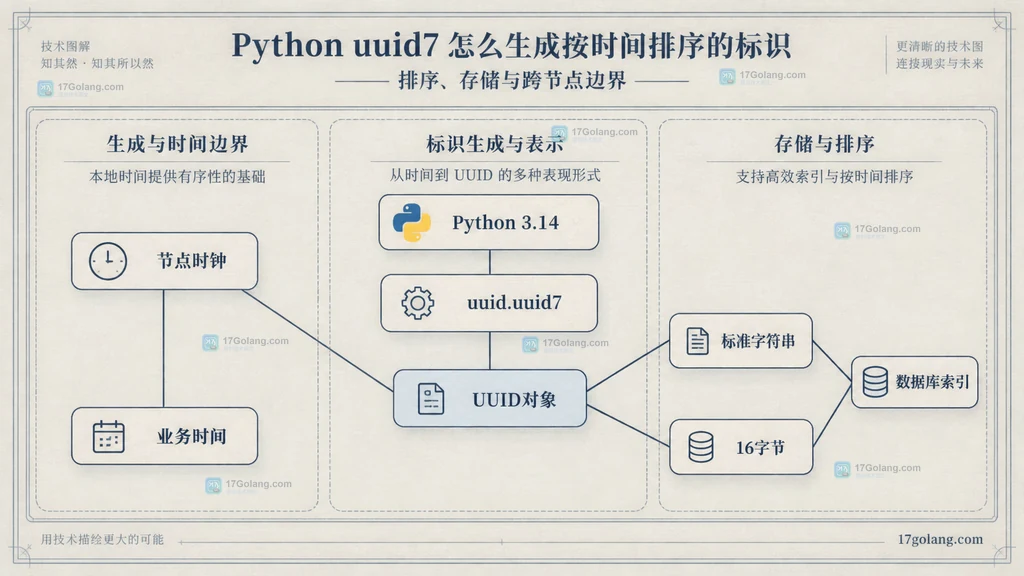
多台服务器各自读取本机时钟。如果节点 A 的时钟比节点 B 快,A 先生成的 UUID 可能排在 B 后生成的 UUID 后面。因此:
- 同一 Python 进程内,可以利用 UUIDv7 的单调性整理生成顺序;
- 跨节点只能把它当作大致时间顺序,必须保持时间同步;
- 需要严格全局顺序时,应使用数据库序列、单一排序服务或显式逻辑时钟;
- 业务审计仍要保存服务端接收时间、事件发生时间和必要的来源信息。
不要把 UUIDv7 当成安全令牌
UUIDv7 暴露了生成时间的大致信息,而且“唯一”不等于“不可猜测、不可伪造”。下载链接、重置密码、会话凭证和接口密钥应使用专门的密码学随机令牌,并配合过期时间、权限检查与撤销机制。UUIDv7 可以作为记录主键,但不能单独承担授权。
常见问题
UUIDv7 一定严格递增吗?
Python 3.14 的实现用 42 位计数器保证单毫秒内的单调性。但跨进程、跨主机或系统时钟回拨时,不应把它视作严格的全局序列。
能从 UUIDv7 恢复创建时间吗?
可以读取 value.time 得到 Unix 毫秒时间戳,再转换成带时区的 datetime。这个时间来自生成节点的系统时钟,不等于经过可信校准的业务事件时间。
UUIDv7 和 UUIDv4 怎么选?
只需要随机 UUID、并且不希望标识暴露生成时间时,UUIDv4 更直接;需要 UUID 兼容格式和按时间聚集的索引写入时,可以选 UUIDv7。
Python 3.13 能直接调用 uuid.uuid7 吗?
不能。标准库支持从 Python 3.14 开始。旧版本需要升级解释器或引入符合 RFC 9562 的第三方实现,并在项目中锁定依赖。
 Go fstest.TestFS 为什么会报告实现不符合约定
- 上一篇
- Go fstest.TestFS 为什么会报告实现不符合约定
- 下一篇
- Go multipart.Writer 怎么使用指定 boundary
-
- 文章 · python教程 | 3小时前 | python ·
- Python NamedTemporaryFile 的 delete_on_close 怎么设置
- 311浏览 收藏
-
- 文章 · python教程 | 9小时前 |
- Python itertools.batched strict 参数什么时候会报错
- 306浏览 收藏
-
- 文章 · python教程 | 11小时前 |
- Python ExceptionGroup split 怎么按异常类型拆分
- 311浏览 收藏
-
- 文章 · python教程 | 12小时前 |
- Python dataclass slots 与 weakref_slot 怎么一起用
- 207浏览 收藏
-
- 文章 · python教程 | 23小时前 | python · Python tarfile extraction_filter data_filter
- Python tarfile extraction_filter 怎么阻止危险路径
- 232浏览 收藏
-
- 文章 · python教程 | 1天前 |
- Python pathlib.Path.walk 怎么剪枝目录遍历
- 159浏览 收藏
-
- 文章 · python教程 | 1天前 | python · SQLite · Python sqlite3 autocommit isolation_level SQLite事务
- Python sqlite3 autocommit 与 isolation_level 怎么配合
- 378浏览 收藏
-
- 文章 · python教程 | 1天前 | 并发 · 异步编程 · Python教程 · Python 任务调度 asyncio eager_task_factory
- Python asyncio eager task factory 什么时候会改变执行顺序
- 497浏览 收藏
-
- 文章 · python教程 | 1天前 |
- Python zoneinfo部署时区数据缺失的兼容处理
- 378浏览 收藏
-
- 文章 · python教程 | 2天前 |
- Python functools.cache与lru_cache按场景选择的参数清单
- 211浏览 收藏
-
- 文章 · python教程 | 3天前 | python ·
- Python multiprocessing共享状态与进程安全队列的选择
- 316浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 246次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 292次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 261次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 242次使用
-
- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 50次使用
-
- golang实现java uuid的序列化方法
- 2023-01-17 270浏览
-
- Go 1.27 新增 uuid 包怎么选 API:生成、解析与持久化边界
- 2026-08-31 267浏览
-
- 订单 request_id 用 UUID 怎么设计:解析入口与数据库字段边界
- 2026-08-31 372浏览
-
- Go 1.27 uuid 包怎么选:标准库生成解析 UUID 的工程边界
- 2026-09-01 463浏览
-
- MySQL 生成随机数字、字符串、日期、验证码及 UUID的方法
- 2023-01-07 117浏览


