
python教程技术文章
-

- PyCharm添加解释器完整教程
- 在PyCharm中添加解释器的步骤包括:1)选择“AddInterpreter”;2)选择解释器类型,如“SystemInterpreter”、“VirtualenvEnvironment”、“CondaEnvironment”或“WSL”;3)配置虚拟环境的位置和Python版本;4)在设置中管理解释器。配置解释器可以帮助管理项目依赖,避免版本冲突,尽管过程可能复杂,但掌握后非常有用。
- 文章 · python教程 | 1年前 | 465浏览 收藏
-

- Ubuntu22.04源码编译Python3.12,依赖详解
- 在Ubuntu22.04上源码编译安装Python3.12的步骤包括:1.安装依赖项:使用sudoaptupdate和sudoaptinstall命令安装必要的库;2.下载源码:使用wget和tar命令下载并解压Python3.12源码;3.配置、编译和安装:运行./configure、make-j$(nproc)和sudomakealtinstall命令完成安装。
- 文章 · python教程 | 1年前 | 465浏览 收藏
-
- Python加载配置文件的终极攻略
- 在Python中加载配置文件可以使用configparser、json和yaml模块,分别对应INI、JSON和YAML格式。1.使用configparser读取INI文件,适合简单配置。2.使用json模块读取JSON文件,适用于结构化数据。3.使用yaml模块读取YAML文件,适合人类编辑且结构化。选择配置文件格式时需考虑易用性、结构化、性能和安全性。
- 文章 · python教程 | 1年前 | Python 配置文件 JSON YAML configparser 465浏览 收藏
-
- 终极指南:遍历列表、元组、集合与字典
- 在Python中遍历列表、元组、集合和字典的方法包括:1.列表和元组:使用for循环直接遍历。2.集合:使用for循环遍历,但顺序可能不同。3.字典:可以遍历键、值或键值对。4.高级用法:使用enumerate获取索引,或对字典值排序。
- 文章 · python教程 | 1年前 | 465浏览 收藏
-

- 字典键的类型要求:1.数字(整数、浮点数)2.字符串3.元组(元素不可变)这些类型可哈希,作为键。列表、字典不可作为键,因不可哈希。
- 在Python中,字典的键可以是不可变类型的数据,如整数、浮点数、字符串、元组、布尔值和None。1.整数和浮点数是最常见的键类型。2.字符串适合作为标识符。3.元组作为键时,其元素必须不可变。4.布尔值和None也可以作为键。不可变类型确保键的哈希值不变,保证字典的正确性和高效性。
- 文章 · python教程 | 1年前 | 465浏览 收藏
-

- 字典的键可以使用以下不可变类型:1.**整数(int)**:如`1`,`2`,`3`2.**浮点数(float)**:如`1.0`,`2.5`3.**字符串(str)**:如`'key'`,`'another_key'`4.**元组(tuple)**:如`(1,2)`,`('a','b')`,只要元组内元素不可变。使用不可变类型作为键,确保字典的稳定性和可靠性。
- 在Python中,字典的键可以是不可变类型的数据,如整数、浮点数、字符串、元组、布尔值和None。1.整数和浮点数是最常见的键类型。2.字符串适合作为标识符。3.元组作为键时,其元素必须不可变。4.布尔值和None也可以作为键。不可变类型确保键的哈希值不变,保证字典的正确性和高效性。
- 文章 · python教程 | 1年前 | 465浏览 收藏
-

- m3u8视频跨域问题解决方案合集
- m3u8视频播放遭遇跨域,有哪些破解妙招?在使用m3u8...
- 文章 · python教程 | 1年前 | 465浏览 收藏
-

- Python元组格式化输出,完美对齐技巧详解
- 本文介绍了Python元组格式化输出和对齐技巧,主要方法是:1.使用str.format()方法,通过占位符{}和对齐标志(<,>,^)控制输出格式及宽度;2.使用f-string,语法更简洁,可读性更好,并可指定数据类型格式(如:.2f保留两位小数)。需注意元素类型一致性及宽度设置,大数据量处理可预先计算格式化字符串提升效率。清晰易懂的代码至关重要。
- 文章 · python教程 | 1年前 | 465浏览 收藏
-

- pytest测试报告符号详解:E、s、.啥意思?
- pytest测试结果中的符号含义解读在使用pytest...
- 文章 · python教程 | 1年前 | 465浏览 收藏
-

- Python十六进制输出:格式与精度完美掌控
- Python通过format()方法或f-string控制十六进制输出格式和精度。1.使用{:04X}(或f"{number:04x}")指定输出格式,其中0表示用0填充,4表示宽度为4,X(或x)表示大写(或小写)十六进制字母。2.精度控制指整数部分位数,通过宽度参数控制。3.f-string通常比format()方法略快,但差异很小。熟练掌握格式化字符串语法,才能高效优雅地处理十六进制输出。
- 文章 · python教程 | 1年前 | Python 十六进制输出 465浏览 收藏
-

- AWS lambda ric-运行时接口客户端
- 为何选择LambdaRIC?LambdaRIC提供诸多优势,尤其在处理大型部署方面:Docker镜像支持更大规模部署(最大10GB):非常适合包含大量资源,例如OPA策略、大型代码库(而非简单的zip文件),并能实现更有效的资源管理。其优化的层管理和缓存机制进一步提升了效率。标准化环境:开发和生产环境保持一致,简化CI/CD流程,并提供统一的测试环境。同一容器可在本地和Lambda环境中运行。高度自定义:支持自定义运行时配置,方便集
- 文章 · python教程 | 1年前 | 465浏览 收藏
-

- 任务-Python 包
- 几个python包进度条和tqdm:为循环、文件处理或下载等任务实现进度条。fromprogress.barimportchargingbarbar=chargingbar('processing',max=20)foriinrange(20):#dosomeworkbar.next()bar.finish()输出:processing████████████████████████████████100%tqdm:与进度条类似,但设置比进度条更简单。fromtqdmimporttqdmimporttim
- 文章 · python教程 | 1年前 | 465浏览 收藏
-
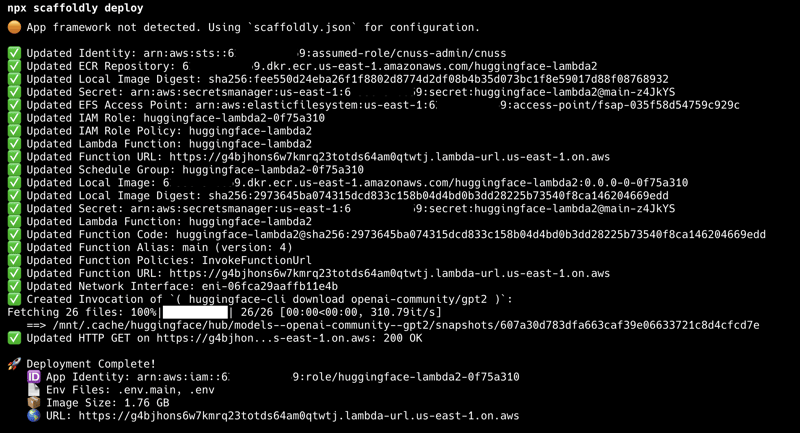
- 只需几步即可将拥抱脸部模型部署到 AWS Lambda
- 是否曾经想将huggingface模型部署到awslambda,但却被容器构建、冷启动和模型缓存所困扰?以下是如何使用scaffoldly在5分钟内完成此操作。长话短说在aws中创建名为.cache的efs文件系统:转到awsefs控制台点击“创建文件系统”将其命名为.cache选择任意vpc(scaffoldly会处理剩下的事情!)从python-huggingface分支创建您的应用程序:npxscaffoldlycreateapp--templatepython-huggingface部署它:cdm
- 文章 · python教程 | 1年前 | 465浏览 收藏
-

- Geany 中 UTF-8 编码为什么显示不了中文?
- 为什么在Geany中使用UTF-8无法正确显示中文?在Geany使用UTF-8后,中文乱码的原因是Geany...
- 文章 · python教程 | 1年前 | 465浏览 收藏

查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-
- Golang深入理解GPM模型
- Golang深入理解GPM调度器模型及全场景分析,希望您看完这套视频有所收获;包括调度器的由来和分析、GMP模型简介、以及11个场景总结。
- 474次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 290次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 343次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 345次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 308次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 131次使用


