
深圳海关成功侦破一起走私入境案,轮椅内藏有108部手机
来源:IT之家
2023-12-28 15:31:20
0浏览
收藏
大家好,今天本人给大家带来文章《深圳海关成功侦破一起走私入境案,轮椅内藏有108部手机》,文中内容主要涉及到,如果你对科技周边方面的知识点感兴趣,那就请各位朋友继续看下去吧~希望能真正帮到你们,谢谢!
据海关最新发布的消息,深圳皇岗海关近日在福田口岸的旅检进境渠道成功查获一名旅客夹藏了108部旧手机在电动轮椅中的情况。

一名旅客乘坐电动轮椅经福田口岸入境,经过海关监管区时神色异常,海关关员随即对其进行拦截检查,发现该名旅客所使用的轮椅电池盒螺丝松动,存在改装的可能。后经现场开拆,发现轮椅电池盒内藏有大量使用透明包装袋封装的旧手机。经现场清点,共计 108 部。
根据《中华人民共和国海关行政处罚实施条例》第七条,海关提醒大家,如果以隐瞒、伪装、隐报、虚报或其他方式来逃避海关监管,将运输、携带、邮寄国家禁止或限制进出境的货物、物品或需要缴纳税款的货物、物品,这将被视为走私行为,涉案人将被追究法律责任。
本站注意到,深圳海关本月初还在旅检进境渠道查获一名旅客走私 switch 游戏卡 300 张,同样利用轮椅座椅夹层藏匿。这批卡带多为《双人成行》和《狙击精英 4》,前者还获得过 TGA 2021 年度最佳游戏。
今天关于《深圳海关成功侦破一起走私入境案,轮椅内藏有108部手机》的内容介绍就到此结束,如果有什么疑问或者建议,可以在golang学习网公众号下多多回复交流;文中若有不正之处,也希望回复留言以告知!
版本声明
本文转载于:IT之家 如有侵犯,请联系study_golang@163.com删除
 国美零售与京东达成协议支付 1.05 亿元部分债务
- 上一篇
- 国美零售与京东达成协议支付 1.05 亿元部分债务

- 下一篇
- 2024年电信行业领袖的全球展望
查看更多
最新文章
-
- 科技周边 · 业界新闻 | 4小时前 | 云原生 · prometheus · 可观测性 · prometheus OpenTelemetry Remote Write 远程写入
- Prometheus 远程写入生态的新关注点
- 235浏览 收藏
-
- 科技周边 · 业界新闻 | 4小时前 | 云原生 · kubernetes · 插件 规则引擎 云原生安全 Falco 运行时安全 Falco Operator
- Falco 运行时安全生态更新如何影响检测部署
- 231浏览 收藏
-
- 科技周边 · 业界新闻 | 4小时前 | 云原生 · 云原生 CNCF 平台工程 Platform Engineering 内部开发平台 自助交付
- CNCF 平台工程报告中的自助交付趋势
- 487浏览 收藏
-
- 科技周边 · 业界新闻 | 4小时前 |
- Dapr Workflow 的持续演进适合解决什么编排问题
- 187浏览 收藏
-
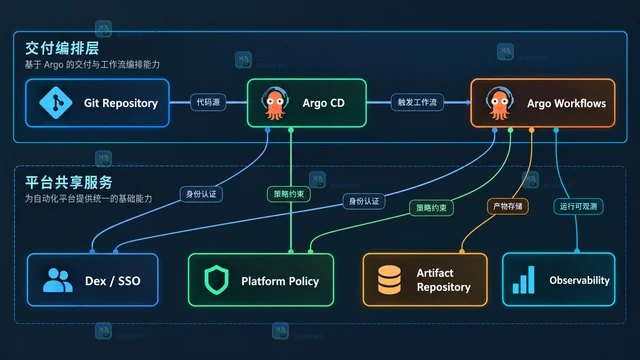
- 科技周边 · 业界新闻 | 4小时前 | 云原生 · kubernetes · Kubernetes 工作流自动化 Argo Argo Workflows Argo CD 云原生平台
- Argo 工作流生态近期演进如何影响自动化平台
- 248浏览 收藏
-
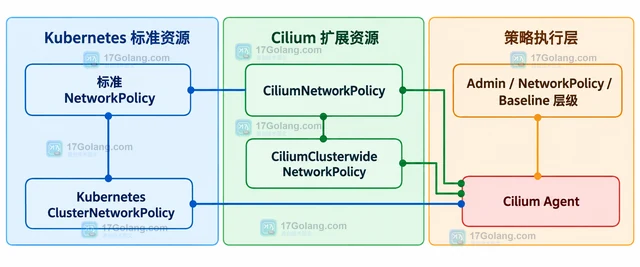
- 科技周边 · 业界新闻 | 4小时前 | 云原生 · 运维 · kubernetes · 网络策略 Cilium 1.20 Cilium Kubernetes ClusterNetworkPolicy CiliumNetworkPolicy Cluster Mesh
- Cilium 网络策略生态变化带来哪些运维关注
- 301浏览 收藏
-
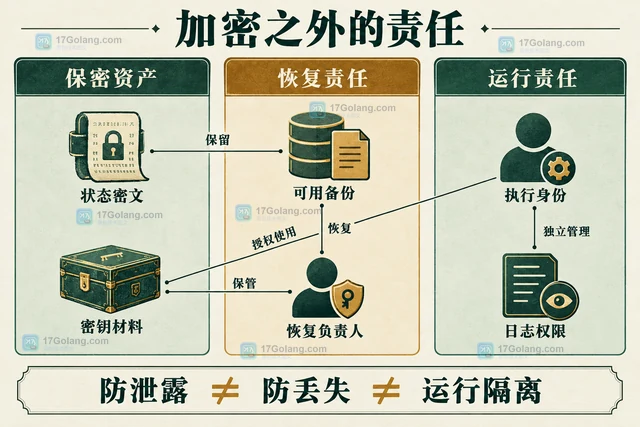
- 科技周边 · 业界新闻 | 4小时前 |
- OpenTofu 状态加密方向解决哪类工程风险
- 276浏览 收藏
-
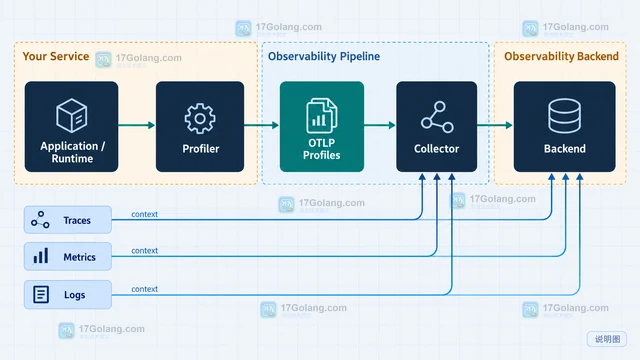
- 科技周边 · 业界新闻 | 4小时前 | 可观测性 ·
- OpenTelemetry 持续剖析信号推进到什么阶段
- 284浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 511次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 571次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 597次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 549次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 365次使用
查看更多
相关文章
-
- 蒙面演唱引争议,旺仔小乔被平台封禁
- 2025-08-08 501浏览
-
- openGauss向量驱动升级,RAC多写突破内核
- 2025-07-30 501浏览
-
- 安普瑞斯工厂放假,电芯供应受影响
- 2025-07-04 501浏览
-
- 农产品APP开发优势与功能全解析
- 2025-04-30 501浏览
-
- 开店省钱妙招,外卖系统同城配送运营攻略
- 2025-04-26 501浏览