
Hugging Face Accelerate PartialState 怎样获取当前进程和设备
在分布式训练脚本里,如果目标只是知道“当前进程用哪块设备、它在所有进程中的编号是多少、同一台机器上排第几”,不必为了读取这些状态先把数据加载器和优化器交给 Accelerator.prepare()。Hugging Face Accelerate 提供的 PartialState 就适合这个窄场景。
官方地址:https://huggingface.co/docs/accelerate/main/package_reference/state
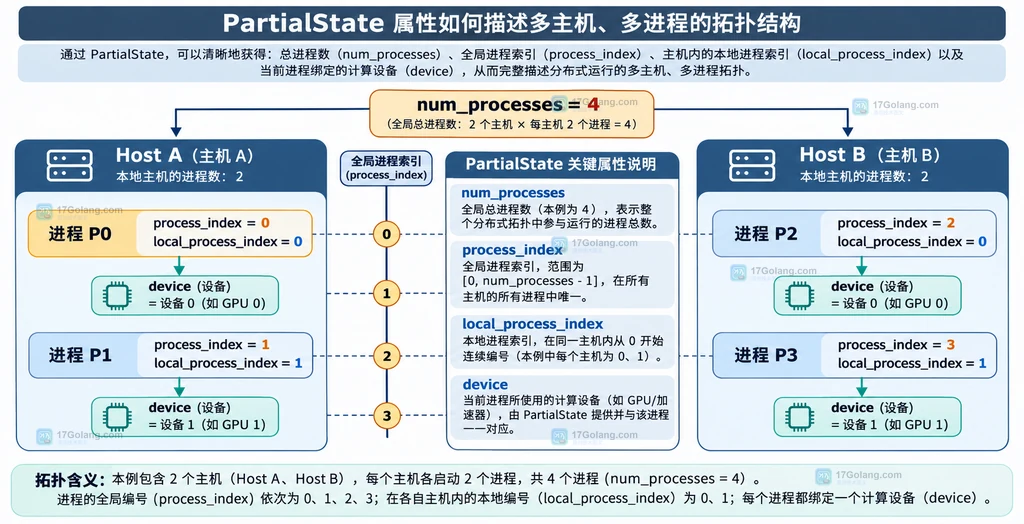
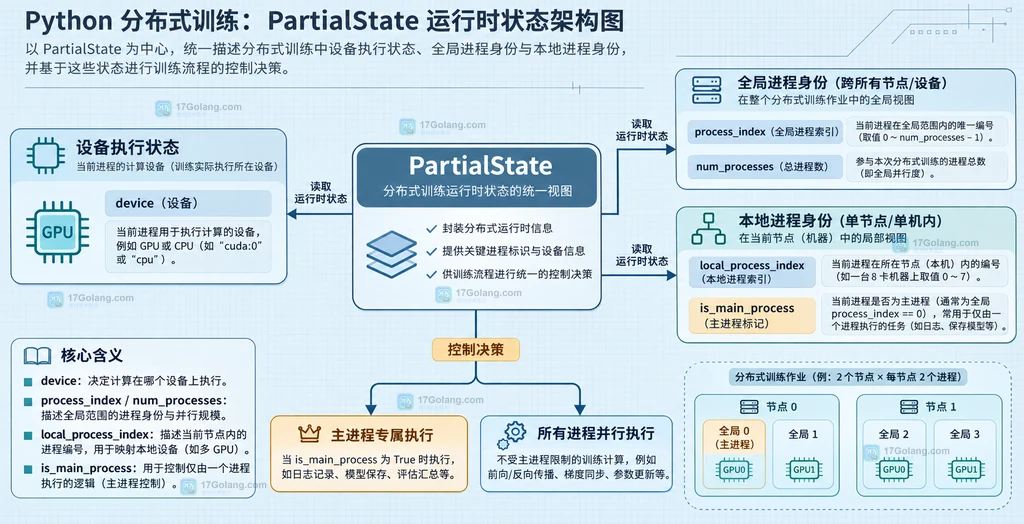
记住四个核心属性:device看执行设备,process_index看全局编号,local_process_index看当前机器内的编号,num_processes看总进程数。多机环境下,最容易错的是把后两个编号混为一谈。
PartialState 先解决哪一层问题
Accelerator 适合把模型、优化器、数据加载器等训练对象纳入统一准备流程;PartialState 更像一份只读的运行环境状态入口。它可以直接告诉脚本当前设备和进程身份,也能配合主进程判断控制日志、保存配置等动作。
因此,脚本只做设备分支、分布式打印、按进程切分外部任务时,直接构造 PartialState() 会更清楚。它不等于已经完成模型分布式封装,也不会替你把普通 Python 对象自动放到设备上。
四个属性怎样对应多机进程
先用最小代码把状态打印出来。下面的注释只解释关键字段,避免把每一行都改写成注释。
from accelerate import PartialState

# 只读取当前分布式环境,不准备模型、优化器或 DataLoader
state = PartialState()

print("device:", state.device)
print("process_index:", state.process_index)
print("local_process_index:", state.local_process_index)
print("num_processes:", state.num_processes)

# 只让全局主进程输出一次汇总信息,避免多进程重复打印
if state.is_main_process:
    print("所有进程已启动:", state.num_processes)
process_index 是当前进程在整个分布式作业中的编号;local_process_index 只在当前机器内编号。假设两台机器各启动两个进程,全局编号可能是 0、1、2、3,而每台机器上的本机编号都会从 0、1 重新开始。num_processes 是四个进程的总数,device 则是当前进程应该使用的设备对象。
全局编号和本机编号分别怎么用
需要给所有进程分配唯一任务时,使用 process_index。例如把一组待处理文件按进程轮流分配,可以用全局编号取模:
from accelerate import PartialState

state = PartialState()
files = ["part-000", "part-001", "part-002", "part-003"]

# 全局编号保证多机环境下每个进程拿到不同的切片
my_files = files[state.process_index::state.num_processes]
print(state.process_index, my_files)
需要选择本机设备槽位、设置本机临时目录或记录节点内序号时,才看 local_process_index。把它用于跨机器的唯一分片会导致不同主机的进程拿到相同编号,进而重复处理任务。
主进程判断与 CPU 分支的边界
日志、配置落盘和一次性的汇总信息通常只让 is_main_process 执行;如果动作只针对当前机器的主进程,例如每台机器各写一份本地统计,可改用 is_local_main_process。这两个判断都只是控制逻辑,不代表其他进程已经停止。
from accelerate import PartialState

# cpu=True 会忽略可用加速器,适合先做 CPU 环境的流程排查
state = PartialState(cpu=True)

if state.is_local_main_process:
    print("本机只记录一次:", state.device)
最后检查一个常见误区:如果代码还需要准备模型、优化器或数据加载器,就应回到 Accelerator 的完整训练流程;如果只是读取状态和做轻量进程控制,PartialState 才是更小的依赖边界。
常见问题
PartialState 能替代 Accelerator 吗?不能一概而论。它能覆盖设备读取、进程编号和部分进程控制,但不负责把训练对象统一准备好。
为什么 process_index 和 local_process_index 一样?单机运行时两者经常都从 0 开始,看起来可能相同;放到多机环境后,全局编号才会继续递增。
只想避免重复打印应该用哪个属性?使用 is_main_process;如果是每台机器各执行一次本地动作,使用 is_local_main_process。
 JetBrains IDE 保存时怎样只重排改动行
- 上一篇
- JetBrains IDE 保存时怎样只重排改动行
- 下一篇
- Transformers Trainer 怎样从 checkpoint 继续训练
-
- 科技周边 · 人工智能 | 15分钟前 | 人工智能 · Transformers AutoConfig from_pretrained 模型配置 不加载权重
- Transformers AutoConfig 怎样在加载模型前查看配置
- 132浏览 收藏
-
- 科技周边 · 人工智能 | 18分钟前 | 人工智能 · 文本生成 Transformers generate no_repeat_ngram_size n-gram
- Transformers generate 怎样限制重复 n-gram
- 202浏览 收藏
-
- 科技周边 · 人工智能 | 20分钟前 |
- Transformers BatchEncoding 怎样读取溢出序列映射
- 309浏览 收藏
-
- 科技周边 · 人工智能 | 21分钟前 | 人工智能 · Transformers checkpoint Trainer resume_from_checkpoint 继续训练 优化器状态
- Transformers Trainer 怎样从 checkpoint 继续训练
- 258浏览 收藏
-
- 科技周边 · 人工智能 | 18小时前 | 人工智能 · PyTorch autograd torch.is_grad_enabled 梯度模式
- PyTorch torch.is_grad_enabled 怎样读取当前线程的梯度开关状态
- 346浏览 收藏
-
- 科技周边 · 人工智能 | 19小时前 | 人工智能 · PyTorch Tensor.storage_offset storage_offset Tensor View 张量布局
- PyTorch Tensor.storage_offset 怎样读取张量视图的存储起始偏移
- 316浏览 收藏
-
- 科技周边 · 人工智能 | 19小时前 |
- Transformers BaseModelOutput.hidden_states 怎样区分各层隐藏状态与最后一层输出
- 429浏览 收藏
-
- 科技周边 · 人工智能 | 20小时前 | python · 人工智能 · Transformers tokenizer BatchEncoding sequence_ids 双句编码 词元来源
- Transformers BatchEncoding.sequence_ids 怎样区分双句编码中的词元来源
- 283浏览 收藏
-
- 科技周边 · 人工智能 | 21小时前 | 人工智能 · Hugging Face Datasets ClassLabel str2int 标签编码
- Hugging Face ClassLabel.str2int 怎样把类别名称映射为标签编号
- 222浏览 收藏
-
- 科技周边 · 人工智能 | 22小时前 | 人工智能 · PyTorch Tensor.is_contiguous memory_format
- PyTorch Tensor.is_contiguous 怎样检查张量在指定内存格式下是否连续
- 170浏览 收藏
-
- 科技周边 · 人工智能 | 23小时前 | python · 人工智能 · Transformers ModelOutput to_tuple 模型输出
- Transformers ModelOutput.to_tuple 怎样把非空模型输出字段转换为元组
- 192浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1115次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1104次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1277次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1219次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1066次使用
-
- 检验检测设备外出校准返场怎么验收:状态确认、方法验证与记录
- 2026-09-03 392浏览
-
- 检验检测设备售后服务不稳定怎么办:供应商评价与维护记录边界
- 2026-09-04 217浏览
-
- 医疗器械售后巡检如何区分设备状态、耗材批次和维修建议
- 2026-09-20 332浏览
-
- 矿山设备交接班记录怎么写才便于追溯
- 2026-10-04 395浏览
-
- 制造企业怎样安排设备保养到期提醒
- 2026-10-18 115浏览