如果你看到 CloudNativePG 进入 CNCF Incubating,最容易误读成“它已经自动替代了所有 PostgreSQL 运维方案”。更准确的理解是:项目治理和社区协作获得了新的阶段性确认,但真正能否用于你的生产环境,仍要回到故障切换、备份恢复、访问控制、连接管理和演练记录。
CloudNativePG 是运行在 Kubernetes 上的 PostgreSQL Operator。CNCF 官方公告确认它进入孵化阶段,并介绍了声明式集群管理、主备复制、自动故障切换、滚动更新、连续备份和时间点恢复等能力。本文把这些能力拆成运维人员可以检查的关系,而不是把项目级别当成现网可用性承诺。
官方地址:https://www.cncf.io/blog/2026/11/10/cloudnativepg-becomes-a-cncf-incubating-project/
先看清 CNCF 孵化状态改变了什么
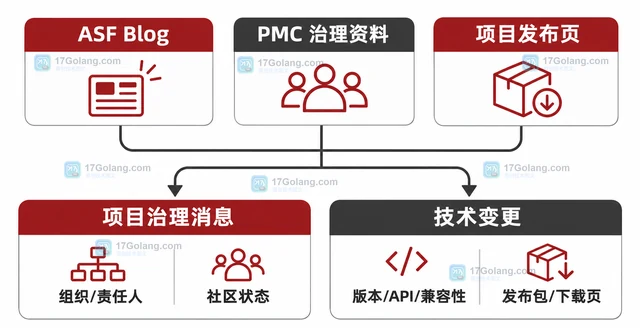
孵化状态首先是治理和生态信号:项目进入 CNCF 的技术监督与社区协作框架,后续的治理、文档、贡献和生态整合更容易被公开观察。它不等于某个云厂商的 SLA,也不等于你的存储、网络、备份目标已经自动满足。
因此评估时要把两个问题分开:
| 问题 | 应该看什么 |
|---|---|
| 项目是否值得持续关注 | 治理透明度、贡献者生态、版本路线、插件和文档是否持续演进 |
| 能否进入自己的生产环境 | RPO/RTO、存储可靠性、故障演练、升级回退、监控和权限是否可验证 |
Operator、Cluster 与实例如何分工
CloudNativePG 的关键思路是把数据库集群的目标写成 Kubernetes 世界里的声明式对象,再由 Operator 负责协调。读者可以按三层理解:CNCF 和项目社区是治理边界;Kubernetes API 与 Cluster 资源是控制边界;PostgreSQL 实例、主备复制和 Instance Manager 是数据边界。
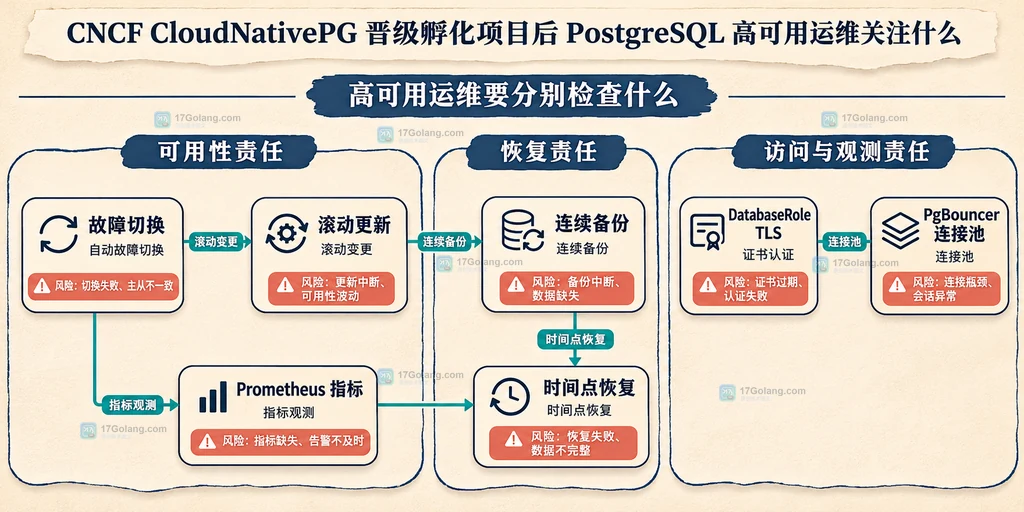
这种分工的价值在于,数据库生命周期不再只依赖人工记忆:实例数量、存储、更新策略、备份和访问配置可以成为可审查的声明。不过,声明式不代表无需设计。Operator 只能依据可见的 Kubernetes 资源和外部依赖做协调,底层磁盘、网络、密钥、对象存储和跨区调度仍需要平台团队负责。
用最小声明表达运维意图
下面只展示阅读配置时应关注的字段关系,不绑定某个环境的完整版本,也不宣称这段内容未经修改即可上线。真实部署前应以对应版本的 CloudNativePG 官方文档为准。
apiVersion: postgresql.cnpg.io/v1
kind: Cluster
metadata:
  name: orders-db
spec:
  instances: 3 # 用多个实例表达高可用目标,但不替代跨区与存储设计
  storage:
    size: 20Gi # 这里只表达容量意图,生产环境还要核对 StorageClass
  monitoring:
    enablePodMonitor: true # 让指标进入既有 Prometheus 观测链路
阅读这类声明时,先问“目标是什么”,再问“外部条件是否满足”。例如三个实例并不自动保证三个故障域;开启指标采集也不等于已经定义复制延迟、备份失败和切换异常的告警阈值。
高可用运维要分别检查什么
高可用不是一个按钮,而是一组相互关联的责任。故障切换解决主实例不可用时谁接管,滚动更新解决变更期间如何保持服务,连续备份与时间点恢复解决“切换成功后数据能否找回”,DatabaseRole 和 TLS 解决访问身份,PgBouncer 解决连接压力,Prometheus 指标则让这些状态可以被观察。
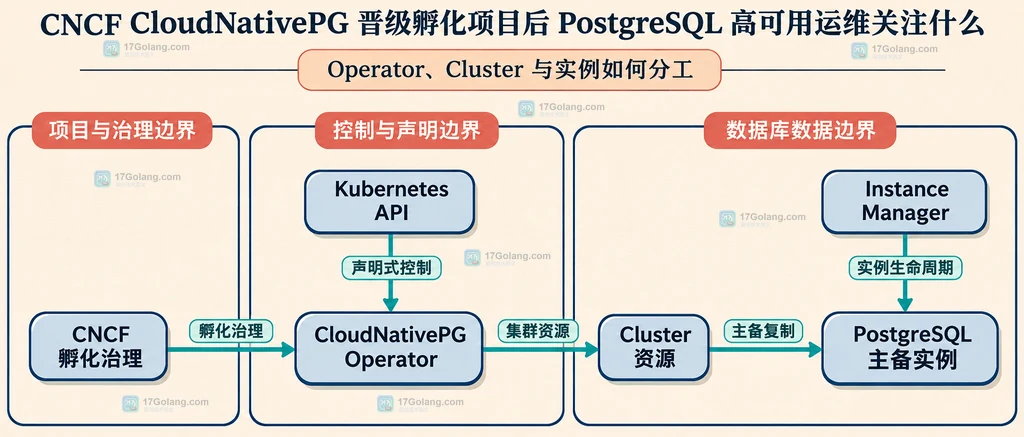
- 故障切换:演练主实例不可用、网络分区和复制延迟时,确认谁触发切换、客户端如何重新连接。
- 升级与回退:把滚动更新当成数据库变更来演练,记录版本、扩展、参数和回退条件。
- 备份恢复:只看到备份文件不够,必须验证恢复到指定时间点的路径、权限和耗时。
- 访问控制:DatabaseRole、TLS 证书、Secret 生命周期和连接池身份要一起审查,避免只轮换密码而遗漏证书。
- 观测闭环:至少覆盖实例健康、主备状态、复制延迟、备份结果、存储容量和切换事件,并为每项绑定处理人。
CloudNativePG 适合怎样的试点路径
更稳妥的试点顺序是从非关键数据库开始,先建立恢复基线,再演练切换,最后才把升级、扩展和权限自动化纳入日常发布。试点期间建议保留四份记录:
- 目标记录:业务允许的 RPO、RTO、连接中断窗口和数据保留期限。
- 依赖记录:StorageClass、节点故障域、对象存储、证书、DNS 和连接池的责任边界。
- 演练记录:主实例故障、节点故障、备份恢复、证书轮换和升级回退的结果。
- 退出记录:哪些指标不达标时暂停扩大范围,哪些场景必须回到原有运维路径。
如果团队没有稳定的 Kubernetes 资源管理和数据库恢复流程,先补齐这些基础能力通常比直接扩大 Operator 管理范围更重要。CloudNativePG 可以减少重复的生命周期操作,但不能替团队承担容量规划、故障决策和数据保护责任。
采用前的速查结论
| 检查项 | 合格信号 | 需要警惕 |
|---|---|---|
| 治理与文档 | 项目路线、版本文档、贡献和问题处理公开可追踪 | 把 CNCF 孵化直接当成商业 SLA |
| 高可用 | 切换、连接恢复和复制延迟都有演练记录 | 只配置实例数,不验证故障域 |
| 数据保护 | 备份可恢复,时间点恢复耗时可量化 | 只看备份任务成功,不做恢复 |
| 运维闭环 | 指标、告警、责任人和回退路径齐全 | 自动化之后没有人工接管方案 |
常见问题
进入 CNCF Incubating 后就能直接用于生产吗?
不能这样推断。孵化状态说明项目治理和生态阶段发生变化,生产可用性仍要由你的存储、网络、恢复演练、监控和服务目标共同证明。
CloudNativePG 的核心价值是自动切换吗?
自动切换只是其中一环。更完整的价值在于把集群声明、实例生命周期、复制、备份、更新和观测放到一致的 Kubernetes 运维边界中。
试点最应该先验证什么?
先验证恢复和接管:能否在预设故障下恢复到目标时间点,客户端是否能重新连接,团队是否知道何时自动化、何时人工接管。
 GitHub Actions workflow lockfiles 正式可用后怎样固定 Action 依赖