
PHP sys_getloadavg 怎样读取系统负载三个时间窗口
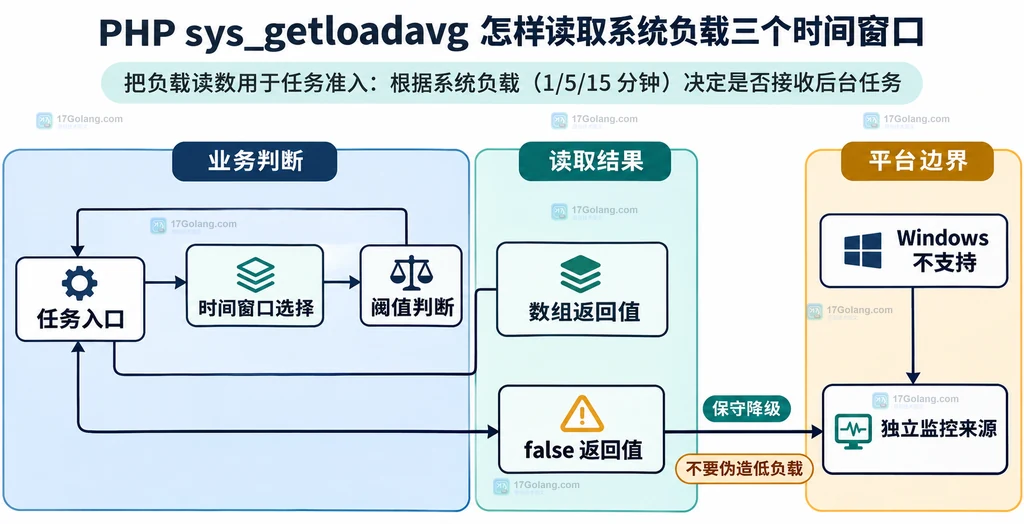
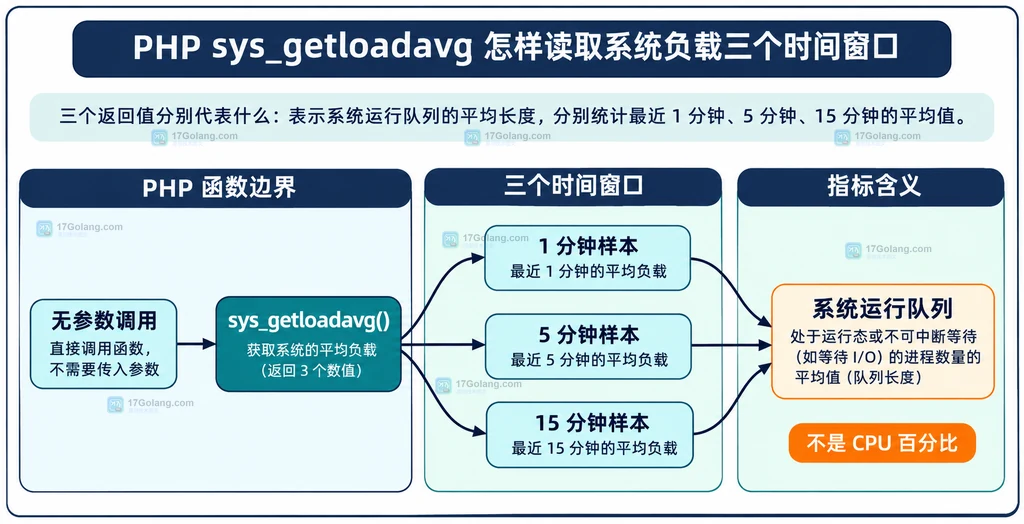
PHP 的 sys_getloadavg() 不需要参数,成功时返回一个包含三个数值的数组,依次表示最近 1 分钟、5 分钟和 15 分钟的系统负载平均值;失败时返回 false。它读取的是运行队列相关的 load average,不是“CPU 已使用百分比”,而且 PHP 官方手册明确说明 Windows 平台不实现这个函数。
如果你要让定时任务在机器繁忙时暂缓执行,最稳妥的做法是先区分返回值,再明确使用哪个时间窗口作为阈值。官方手册地址:https://www.php.net/manual/en/function.sys-getloadavg.php
三个返回值分别代表什么
调用结果可以按下表理解:
| 下标 | 时间窗口 | 适合观察什么 |
|---|---|---|
[0] | 最近 1 分钟 | 短时间突发压力 |
[1] | 最近 5 分钟 | 较稳定的近期压力 |
[2] | 最近 15 分钟 | 持续性负载趋势 |
这三个数表示系统运行队列的平均情况。它们不能脱离机器的 CPU 核数直接解释成百分比:同一个负载值,在单核和多核机器上代表的拥塞程度可能不同。一个短暂的 1 分钟峰值,也不等于系统已经持续过载。
先把数组整理成有含义的数据
直接使用 $load[0] 虽然简短,但读者很难一眼判断它是哪个窗口。可以在任务入口把三个位置命名,同时保留 false 的处理:
 $load[0],  // 最近 1 分钟,适合观察突发压力。
    '5m' => $load[1],  // 最近 5 分钟,适合观察近期平均状态。
    '15m' => $load[2], // 最近 15 分钟,适合观察持续趋势。
];

printf(
    "load(1m)=%.2f, load(5m)=%.2f, load(15m)=%.2f\n",
    $loadByWindow['1m'],
    $loadByWindow['5m'],
    $loadByWindow['15m']
);
这里的重点不是格式化输出,而是把数组协议固定在一个小范围内:后续代码只读取 1m、5m、15m,减少把下标写错后仍能运行的风险。
任务准入时该选哪个窗口
不同任务不应共用一个模糊阈值。交互请求通常更关心短时响应压力,批处理和定时任务则更适合参考 5 分钟或 15 分钟趋势。下面的示例只演示判断结构,阈值需要结合机器核数、任务耗时和业务容忍度配置:
 $shortWindowLimit || $load[1] > $steadyWindowLimit) {
    // 使用明确的下标,避免把 15 分钟趋势误当成即时压力。
    error_log('load is high; defer background job');
    return;
}

// 通过准入判断后,再创建批处理任务。
runBackgroundJob();
不要把示例中的 2.0 或 1.5 当作通用标准。负载平均值和 CPU 核数、I/O 等待、任务类型有关;更可靠的做法是把阈值作为配置,并结合同一台机器的历史监控曲线调整。
不要把 load average 当成 CPU 百分比
sys_getloadavg() 的数值是系统负载平均值。它回答的是“平均有多少任务处于可运行或等待运行的队列状态”,不是“CPU 使用了多少百分比”。如果文章、日志或监控面板需要百分比,必须另外定义 CPU 核数、采样方式和指标口径,不能直接把返回值乘以 100。
例如,1 分钟负载为 0.8,在不同核数的机器上含义并不相同;而当 I/O 等待明显时,load average 也可能上升,即使 CPU 利用率没有同步达到同样比例。因此它更适合做任务准入和趋势提示,不适合单独充当完整的 CPU 监控指标。
Windows 平台要怎样处理
PHP 官方手册的注记指出,sys_getloadavg() 在 Windows 平台没有实现。代码不应假设所有 PHP 运行环境都能得到三个数值,也不要为了让分支继续执行而把失败结果填成 [0, 0, 0]。
跨平台应用可以把系统负载读取抽象成独立适配层:Unix-like 环境尝试调用 sys_getloadavg();Windows 或函数不可用时,交给主机监控、容器平台指标或应用自身的队列长度策略。关键是让调用方知道“当前没有该指标”,而不是把缺失伪装成健康。
常见问题
sys_getloadavg 需要传参数吗?
不需要。函数签名没有参数,调用后按返回数组的三个位置读取 1、5、15 分钟样本。
返回 false 时可以直接取下标吗?
不建议。先用严格比较判断 false,再读取数组;这样能把平台不支持或读取失败与低负载区分开。
为什么 load average 不能直接当 CPU 使用率?
因为两者统计口径不同。load average 与运行队列及等待状态有关,CPU 使用率则是另一套采样指标;还需要考虑 CPU 核数和 I/O 等待。
后台任务应该看 1 分钟还是 5 分钟?
短任务通常需要关注 1 分钟突发压力,长时间批处理可同时参考 5 分钟或 15 分钟趋势。最终阈值应由任务时长、机器规格和历史监控数据共同决定。
小结
记住四个边界就够了:sys_getloadavg() 无参数;返回数组的 [0]、[1]、[2] 分别对应 1、5、15 分钟;返回值不是 CPU 百分比;Windows 平台不实现该函数。把这些边界写进读取适配层,再在任务入口对 false 做明确降级,才能让负载判断真正可维护。
 PHP get_defined_vars 怎样查看当前作用域变量
- 上一篇
- PHP get_defined_vars 怎样查看当前作用域变量
- 下一篇
- PHP Locale.acceptFromHttp 怎样读取浏览器语言偏好
-
- 文章 · php教程 | 10分钟前 | PHP · php 国际化 浏览器语言 Accept-Language Locale::acceptFromHttp
- PHP Locale.acceptFromHttp 怎样读取浏览器语言偏好
- 299浏览 收藏
-
- 文章 · php教程 | 17分钟前 |
- PHP get_defined_vars 怎样查看当前作用域变量
- 351浏览 收藏
-
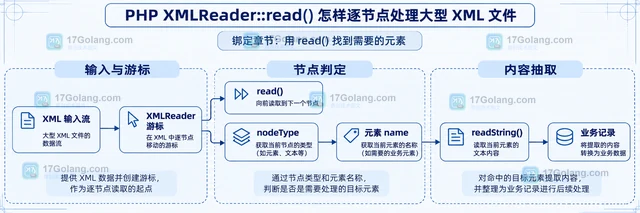
- 文章 · php教程 | 20分钟前 | 流式处理 · PHP · php xml 流式读取 XMLReader XMLReader::read
- PHP XMLReader::read 怎样逐节点处理大型 XML 文件
- 112浏览 收藏
-
- 文章 · php教程 | 24分钟前 | PHP · php zip ZipArchive setCompressionName CM_DEFLATE
- PHP ZipArchive::setCompressionName 怎样单独调整文件压缩级别
- 498浏览 收藏
-
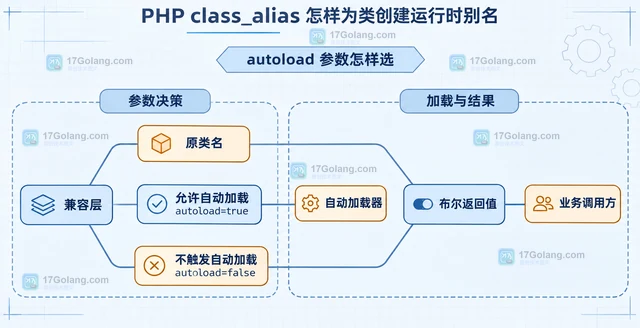
- 文章 · php教程 | 26分钟前 | 面向对象 · php教程 · php 命名空间 自动加载 class_alias 运行时别名
- PHP class_alias 怎样为类创建运行时别名
- 447浏览 收藏
-
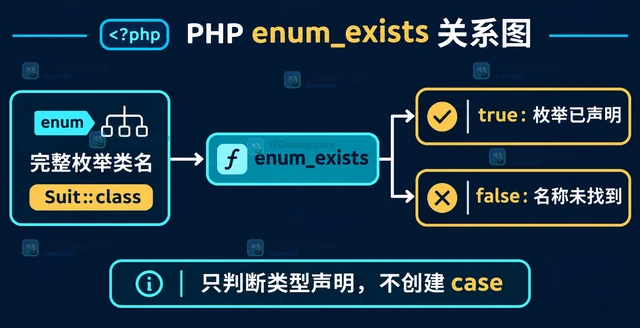
- 文章 · php教程 | 28分钟前 | 枚举 · php教程 · php 类型检查 autoload PHP枚举 enum_exists
- PHP enum_exists 怎样判断枚举是否已声明
- 170浏览 收藏
-
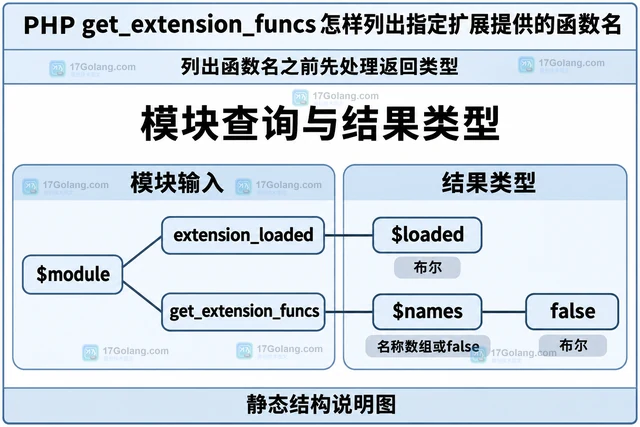
- 文章 · php教程 | 34分钟前 | 反射 · php教程 · php 扩展函数 get_extension_funcs
- PHP get_extension_funcs 怎样列出指定扩展提供的函数名
- 408浏览 收藏
-
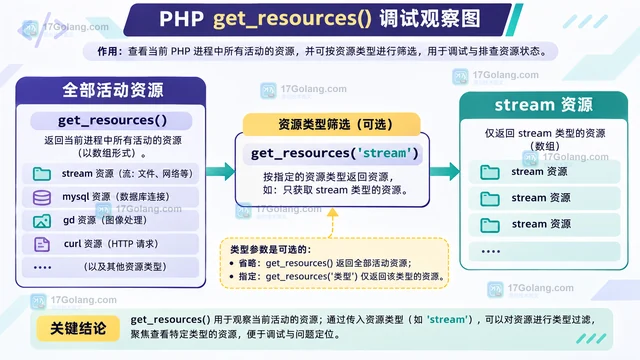
- 文章 · php教程 | 49分钟前 | 资源管理 · php教程 · php Stream 资源类型 get_resources 资源调试
- PHP get_resources 怎样在调试时按类型列出活动资源
- 303浏览 收藏
-
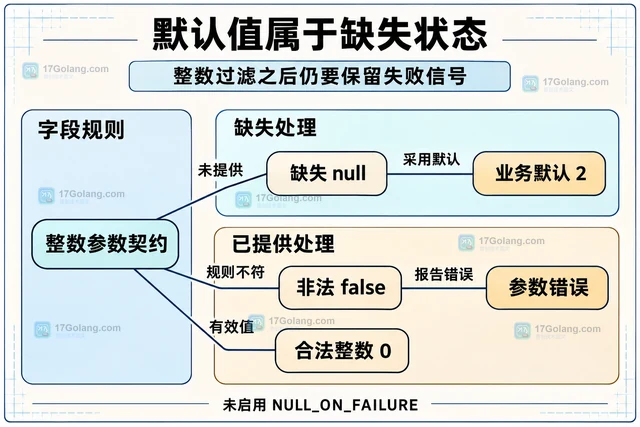
- 文章 · php教程 | 1天前 | PHP · php 默认值 filter_input 空字符串
- PHP filter_input 怎样区分缺失参数和空字符串
- 274浏览 收藏
-
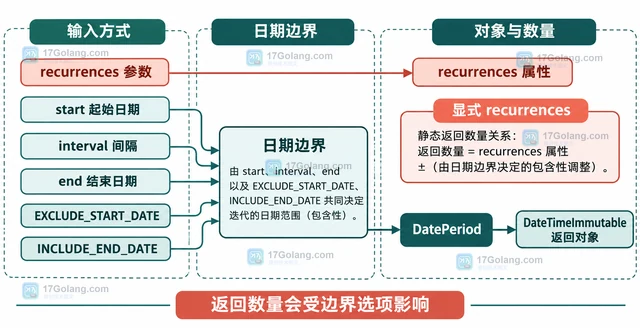
- 文章 · php教程 | 1天前 | PHP · 时间处理 · php DateInterval DatePeriod INCLUDE_END_DATE EXCLUDE_START_DATE
- PHP DatePeriod 怎样把结束日期包含进迭代结果
- 315浏览 收藏
-
- 文章 · php教程 | 1天前 | PHP · php 随机数 异常处理 random_int
- PHP random_int 闭区间取随机数的参数边界与异常处理
- 130浏览 收藏
-
- 文章 · php教程 | 1天前 | PHP · ABI CData ffi.enable PHP FFI 原生调用
- PHP FFI 怎样评估原生调用的部署边界
- 376浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1084次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1084次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1249次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1193次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1038次使用
-
- web项目中golang性能监控解析
- 2023-01-08 188浏览
-
- golang实现PHP数组特性的方法
- 2023-02-16 371浏览
-
- PHP与Go语言之间的通信详解
- 2023-01-07 347浏览
-
- php和go语言的区别有哪些
- 2023-03-04 112浏览
-
- golang调试bug及性能监控方式实践总结
- 2023-05-13 278浏览


