处理大型 XML 时,如果先把整份文档转换成 DOM 或数组,内存压力会随着文件大小一起增长。PHP 的 XMLReader 更适合按游标向前读取:调用 read() 移动到下一个节点,只在遇到目标元素时读取内容并交给业务代码。这样文章只保留当前解析位置和已经提取的记录,不需要先构造整棵文档树。
官方文档:https://www.php.net/manual/en/xmlreader.read.php
最小判断可以概括为:先打开输入,循环判断 read() 的布尔结果,再用 nodeType 和 name 筛选元素,最后用 readString() 读取当前元素的文本。解析结束或异常时,再关闭 XMLReader。
XMLReader::read 解决的是什么问题
XMLReader 是 XML pull parser,表现得像一个只向前移动的游标。read() 没有参数,每次把游标移动到文档中的下一个节点,成功返回 true,无法继续读取或遇到解析失败时返回 false。
它不会替你决定哪些节点是业务数据。常见做法是先判断 $reader->nodeType === XMLReader::ELEMENT,再比较 $reader->name。只有两个条件同时满足,才调用 readString()、getAttribute() 或其他读取方法。
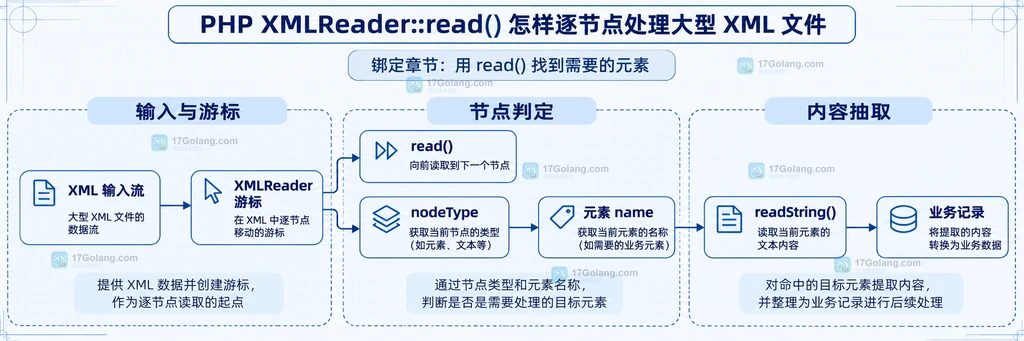
先打开 XML 输入,再用 read() 前进
下面的示例使用 open() 打开文件,并把 XML 中名为 item 的元素整理成业务数组。示例的重点是读取边界:open() 失败时不进入循环;循环结束后调用 close(),避免把资源生命周期交给隐含行为。
open(__DIR__ . '/items.xml');

if ($opened !== true) {
    // open() 失败时不要继续调用 read()。
    throw new RuntimeException('XML 文件打开失败');
}

$items = [];

try {
    // read() 每次把游标移动到下一个节点,false 表示没有可继续读取的节点。
    while ($reader->read()) {
        // 只处理元素节点,跳过文本、空白和结束节点。
        if ($reader->nodeType !== XMLReader::ELEMENT) {
            continue;
        }

        // name 是 XML 中的元素名,不是本地文件路径。
        if ($reader->name !== 'item') {
            continue;
        }

        // 当前游标位于 item 元素时,读取该元素包含的文本内容。
        $items[] = [
            'id' => $reader->getAttribute('id'),
            'value' => $reader->readString(),
        ];
    }
} finally {
    // 无论循环正常结束还是业务代码抛错,都显式关闭读取器。
    $reader->close();
}

print_r($items);
?>
这里的 items 只保存已经选中的业务记录。它并不代表 XMLReader 会自动限制所有业务内存:如果代码把全部结果持续追加到数组,结果数组本身仍会增长。需要更低内存占用时,可以在循环内直接写入数据库、消息队列或分批处理,而不是无限扩张结果数组。
用 nodeType 和 name 找到目标元素
XML 文档中不仅有元素节点,还有文本、CDATA、注释和结束节点。只比较 name 容易把不同节点状态混在一起,因此先判断节点类型,再判断元素名称更稳妥。
read()) {
    // nodeType 先排除文本和结束节点,避免误处理空白。
    if ($reader->nodeType !== XMLReader::ELEMENT || $reader->name !== 'product') {
        continue;
    }

    // 属性属于当前元素,读取前先确认游标仍停在 product 上。
    $sku = $reader->getAttribute('sku');
    $category = $reader->getAttribute('category');

    // 业务代码可以在这里消费一条记录,而不是保存整棵 XML 树。
    consumeProduct($sku, $category);
}
?>
如果目标元素有嵌套内容,readString() 适合读取当前节点的文本内容;如果只想观察属性,可以只调用 getAttribute()。两者都依赖当前游标位置,不能在游标已经移动后再假设它仍指向原来的元素。
read()、next() 和 readString() 不要混用职责
read() 是逐节点前进的基础操作,会让调用方看到文档中的节点边界。next() 用于跳到下一个同名元素并跳过当前子树,适合已经确定当前子树不需要细看时使用。readString() 则是读取当前节点内容的便捷方法,它不是下一次游标移动的替代品。
例如,导入每个一级 item 时,如果 item 内部还有大量无关子节点,可以在明确不需要它们之后考虑 next('item')。如果还需要读取子节点属性,就继续使用 read(),不要提前跳过。
三者的选择可以按这个边界判断:
| 方法 | 职责 | 适用判断 |
|---|---|---|
read() | 移动到下一个节点 | 需要逐节点检查类型、名称或属性 |
next() | 跳过当前子树并寻找后续元素 | 明确不需要当前元素内部节点 |
readString() | 读取当前节点文本内容 | 游标已定位到目标元素 |
解析失败、编码和 close() 要分开处理
read() 返回 false 既可能表示正常到达文档末尾,也可能表示解析过程不能继续。不要只用一个空循环就把两者当成相同结果:生产代码至少要记录输入来源、已处理数量和异常上下文;如果业务必须区分文件结束与解析错误,还要结合错误处理策略检查 XML 输入和 libxml 报告。
编码也要单独考虑。PHP 手册说明 XMLReader 底层使用 libxml,取回的内容会以 UTF-8 表示。源文件应声明正确编码并保持内容合法;如果输入本身不是有效 XML,继续增加 read() 次数不会修复格式问题。
close() 负责关闭 XMLReader 输入。无论循环正常结束、业务消费失败还是解析中抛出异常,都应该放在 finally 中,保证资源释放与业务成功状态分离。
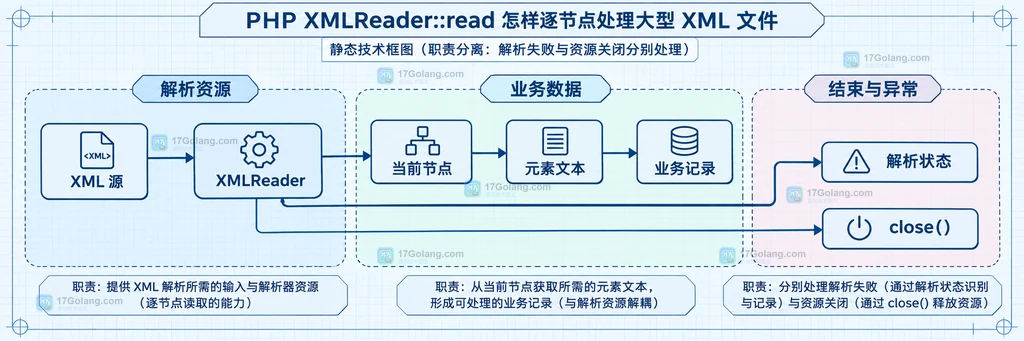
实际使用时的五个边界
- 打开边界:
open()没有成功时,不要进入read()循环。 - 节点边界:先判断
nodeType,再比较name,不要把空白文本当成业务元素。 - 内容边界:
readString()读取的是当前节点内容,调用前要确认游标位置。 - 内存边界:逐节点读取不等于结果数组自动有界;业务结果也要分批消费或落盘。
- 资源边界:循环结束与资源关闭是两个动作,使用
finally保证close()被调用。
常见问题
为什么 while ($reader->read()) 读不到目标节点?
先确认 XML 输入已经成功打开,再记录当前节点的 nodeType 和 name。常见原因是目标名称写错、命名空间导致名称判断不符合预期,或者输入在目标位置之前就已经解析失败。
XMLReader::read 会把整个 XML 放进内存吗?
XMLReader 的接口模型是向前移动的拉式游标,适合按节点消费;但业务代码如果把每条结果都追加到一个无限增长的数组,仍然会产生自己的内存压力。
什么时候用 next() 而不是 read()?
只有在已经确定当前元素的子树完全不需要处理时才跳过。需要读取子元素、属性或文本时,继续用 read() 更容易保留完整的节点判断。
参考资料:https://www.php.net/manual/en/class.xmlreader.php;https://www.php.net/manual/en/xmlreader.open.php;https://www.php.net/manual/en/xmlreader.readstring.php;https://www.php.net/manual/en/xmlreader.next.php;https://www.php.net/manual/en/xmlreader.close.php
 PHP ZipArchive::setCompressionName 怎样单独调整文件压缩级别