
Redis 官方博客怎样提炼数据结构能力的落地场景
读 Redis 官方博客时,不要把“新增数据结构”或“性能提升”直接当成可落地方案。更稳妥的读法是先追问四件事:数据是否需要唯一、是否需要排序、是否需要过期,以及消费者能不能在断线后重放。这样才能把一条产品消息变成可评估的业务场景。
官方地址:https://redis.io/blog/
数据类型文档:https://redis.io/docs/latest/develop/data-types/
Redis 官方文档把 String、Hash、List、Set、Sorted Set、Stream、JSON、Time Series 等类型分别对应到不同的数据形状。下面按“能力变化—旧代码风险—最小写法—回归检查”的顺序,整理一套阅读和迁移方法。
先把博客里的能力词翻译成数据契约
官方文章常用“实时”“高吞吐”“新数据结构”描述价值,但工程落地要从数据契约开始。可以把标题或摘要中的能力词改写成下面这张判断表:
| 先问的问题 | 答案指向 | 典型数据类型 |
|---|---|---|
| 值是否只是一个整体,读写时不需要拆字段? | 缓存、计数器、开关、短文本 | String |
| 一条记录是否由多个字段组成? | 用户资料、商品摘要、会话元数据 | Hash 或 JSON |
| 是否只关心成员是否出现过? | 标签、去重、集合运算 | Set |
| 是否要按分数、优先级或时间排序? | 排行榜、延迟队列、滑动窗口 | Sorted Set |
| 是否需要按追加顺序消费,并允许断线后继续? | 事件流、审计记录、消费组 | Stream |
这一步的重点是先描述“数据形状”和“读取动作”。例如“排行榜”不是因为 Redis 官方博客提到 Sorted Set 才适合,而是因为业务同时需要唯一成员和可按分值取序;“事件流”也不是把 List 换成 Stream 的口号,而是因为消费者需要确认、待处理列表或重放能力。
用官方数据类型对照真实落地场景
Redis 的官方 use cases 文档把限流、会话、排行榜、任务队列、Pub/Sub、流处理和推荐等场景拆开。读者可以按下面的顺序提炼:先看场景的主动作,再看数据生命周期,最后才选择命令。
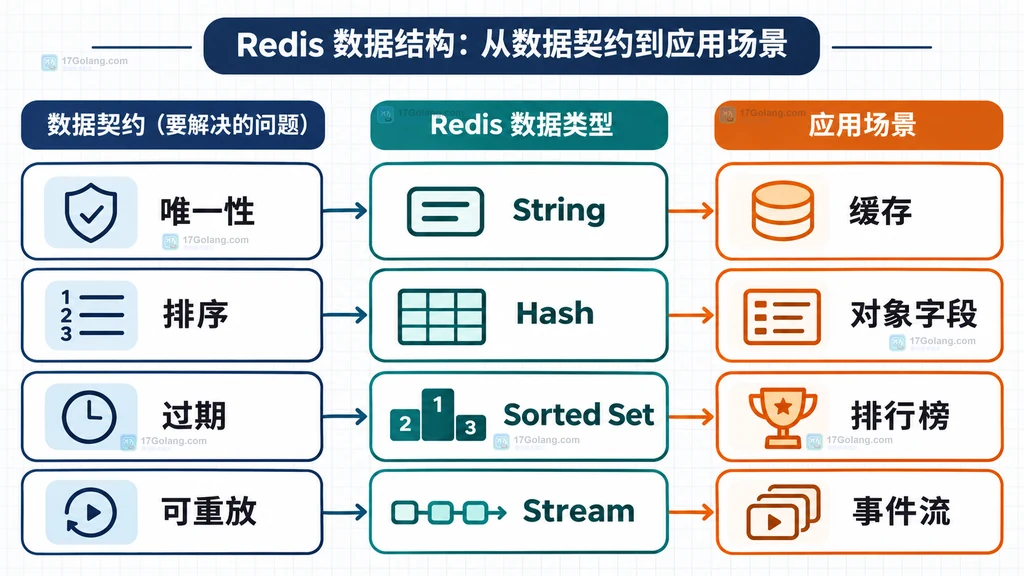
- 缓存和限流:读写的是整体值或计数,通常优先考虑 String,再明确 TTL、原子自增和过期策略。
- 对象局部更新:只改用户资料中的某个字段时,Hash 比每次读写整段 JSON 更容易表达更新边界;如果字段有嵌套查询需求,再比较 JSON。
- 去重和关系:需要判断“是否已经加入”时使用 Set;不要为了得到唯一性,先把所有成员读到应用层再用数组过滤。
- 排序和窗口:排行榜、优先级任务、滑动时间窗口需要 score,Sorted Set 的排序不是查询时临时计算出来的。
- 事件处理:只要有顺序、消费确认、重试或断线恢复要求,就应把 Stream 与 Pub/Sub 区分开;Pub/Sub 更适合即时广播,不能替代可重放日志。
官方博客中出现新类型时,也要沿用同一套问题。以 Redis 8.8 官方文章介绍的 Array 为例,它强调按整数索引访问、可稀疏和动态伸缩,但这不表示 Array 会替代 List、Sorted Set 或 Stream。真正的迁移问题是:调用方是否按索引访问,是否需要 push/pop,是否需要排序或消费确认。
旧方案最容易在哪些地方错配
把一篇官方文章读成改造任务时,最危险的不是命令写错,而是把一种数据结构的边界误套到另一种场景。
- 把所有对象塞进 String JSON。它的优点是模型简单,但局部更新、并发修改、字段级过期和查询能力会变得依赖应用层。对象结构稳定且整体读写时可以保留;需要高频改一个字段时,应比较 Hash 或 JSON。
- 用 Pub/Sub 当可靠队列。订阅者断开时,消息不会像 Stream 那样天然保留给它重放。实时通知可以继续用 Pub/Sub;订单、审计或需要重试的事件应单独评估 Stream。
- 用 List 模拟排行榜。List 擅长按插入顺序从两端 push/pop,不擅长按分值查询和更新排名。只要排名会变化,就应该把“成员”和“分值”作为 Sorted Set 的核心模型。
- 看到“高性能”就忽略生命周期。无论博客谈的是缓存还是实时数据,都要补上 TTL、持久化、内存淘汰、重试和幂等,否则性能优势可能只是把问题推迟到故障时段。
用四个最小模式把能力落到代码
下面的示例不依赖某个业务框架,只展示阅读官方资料后最小的命令边界。代码块中的注释说明了数据契约和关键参数,复制到脚本前仍应按项目的连接、超时和错误处理方式改造。
1. String:带 TTL 的缓存或计数
# SET 的 EX 让缓存最多保留 300 秒,避免把过期策略遗漏在应用代码里
redis-cli SET product:42:summary '{"name":"示例商品","stock":8}' EX 300
# 命中时一次读取完整值;JSON 解析仍由应用负责
redis-cli GET product:42:summary
# 计数器使用原子自增,业务仍需决定是否给新键补充过期时间
redis-cli INCRBY api:limit:user-42 1
2. Hash:只更新对象中的必要字段
# Hash 把一条用户资料拆成字段,局部更新不必覆盖整个对象
redis-cli HSET user:42 name "林然" level "pro"
# EXPIRE 作用于整个 Hash;如果需要字段级 TTL,应比较 Redis JSON 或单字段键方案
redis-cli EXPIRE user:42 3600
# 读取单字段可减少无关数据传输
redis-cli HGET user:42 level
3. Sorted Set:让分值成为排序依据
# score 是排序依据,member 必须保持唯一;这里模拟更新后的积分榜
redis-cli ZADD leaderboard 980 user:42 960 user:17
# 按分值倒序取前两名,并把分数一起返回给调用方
redis-cli ZRANGE leaderboard 0 1 REV WITHSCORES
# 读取范围前先明确并列分值的二级排序和分页约定
4. Stream:为事件保留消费上下文
# * 由 Redis 生成递增 ID,字段记录事件的最小业务事实
redis-cli XADD orders:events '*' order_id 9001 status paid
# 消费组让多个消费者协作;首次创建时从 0-0 读取历史事件
redis-cli XGROUP CREATE orders:events order-workers 0-0 MKSTREAM
# COUNT 限制本次拉取量,BLOCK 让没有新消息时短暂等待
redis-cli XREADGROUP GROUP order-workers worker-a COUNT 10 BLOCK 2000 STREAMS orders:events '>'
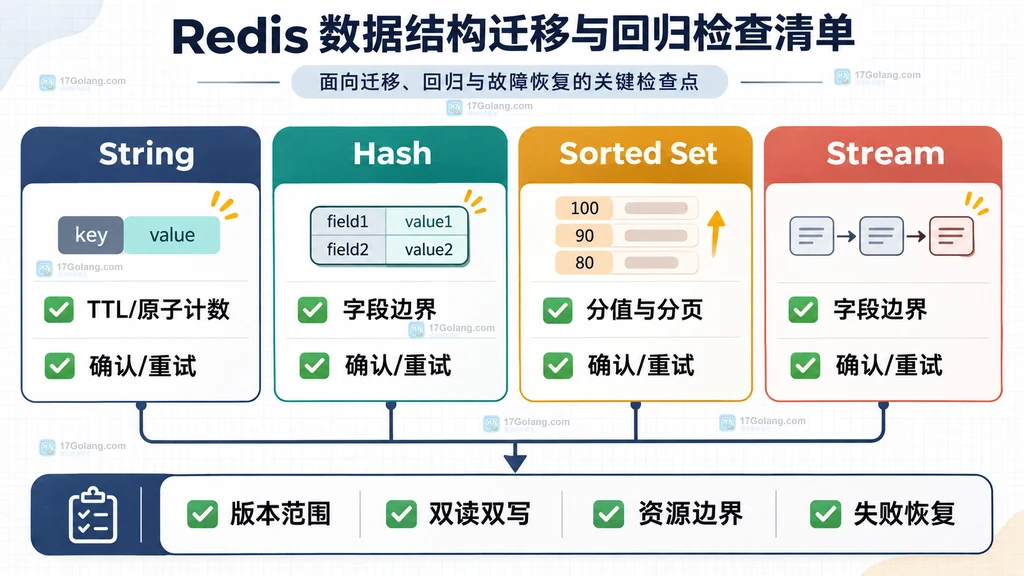
四个例子可以对应四类回归关注点:String 看 TTL 和原子计数,Hash 看字段边界,Sorted Set 看分值与分页,Stream 看消费确认、待处理消息和重试。它们不是“Redis 四大万能模板”,而是用来检验官方文章中一句能力描述是否真的匹配业务约束。
升级或采用前的回归检查
读完官方博客后,不要直接改线上键名或消费逻辑。至少按下面的顺序留下迁移记录:
- 确认版本范围:记录文章提到的 Redis 版本、客户端版本和部署形态,分清“服务端支持”与“客户端已经封装”。
- 确认数据契约:写下 key、member、field、score、stream ID 的含义,说明唯一性、排序、过期和重放是否必须。
- 确认兼容路径:旧键能否双读、新键能否双写,失败时是否能回退;不要只把命令替换成新命令就宣布迁移完成。
- 确认资源边界:比较内存占用、TTL、持久化、淘汰和大 key 风险;官方文档中的“适合”是规则建议,不是对所有数据规模的承诺。
- 确认失败恢复:队列和 Stream 要验证重复消费、确认、重试与积压;缓存要验证回源风暴和空值策略。
如果一篇官方博客只介绍能力而没有你的业务数据形状,就把它当作候选能力,不要当作迁移命令。先在隔离环境用小数据验证命令语义,再用真实读写比例和故障场景判断是否值得承担迁移成本。
常见问题
Redis 官方博客和命令文档应该先看哪个?
先用博客理解能力和场景,再回到数据类型、命令和 use cases 文档确认参数与边界。博客适合发现方向,命令文档才是写代码时的依据。
所有排行榜都应该用 Sorted Set 吗?
只有当成员唯一、分值决定顺序且需要按范围或排名读取时才匹配。若只是按插入顺序展示活动记录,List 或 Stream 可能更贴近需求。
Pub/Sub 能不能替代 Stream?
不能直接替代。即时广播可以使用 Pub/Sub;需要断线恢复、消费组、确认或重试的事件,应单独评估 Stream。
Redis 8.8 的 Array 是否应该替换现有 List?
不能只按版本号决定。需要索引访问时才比较 Array;如果依赖两端 push/pop、插入顺序或队列语义,仍要保留 List 的评估。
迁移清单
- 把官方博客中的能力词改成数据形状、读取动作和生命周期。
- 用官方数据类型文档核对唯一性、排序、过期、消费确认和查询边界。
- 为旧键保留双读、双写或回滚路径,再安排灰度切换。
- 分别压测热 key、大 key、积压、重复消费和缓存回源,不把“实时”当成验收指标。
 MySQL Release Notes 怎样判断数据库升级前的兼容风险
- 上一篇
- MySQL Release Notes 怎样判断数据库升级前的兼容风险
- 下一篇
- PHP 8.5 URI 怎样只修改路径并保留查询参数
-
- 科技周边 · 业界新闻 | 32分钟前 | 工具链 · rust · 工程实践 · Rust 工具链 rustup Cargo Rust 1.100.0 stable beta nightly
- Rust 官方公告怎样区分语言变化和工具链变化
- 149浏览 收藏
-
- 科技周边 · 业界新闻 | 38分钟前 | python · 版本发布 · Python 弃用 版本迁移 What’s New Porting
- Python 官方 What’s New 怎样定位迁移注意事项
- 175浏览 收藏
-
- 科技周边 · 业界新闻 | 39分钟前 | 开发者工具 · GitHub Copilot 模型策略 模型退役 替代模型 迁移计划
- GitHub Copilot 模型退役前怎样切换到替代模型
- 369浏览 收藏
-
- 科技周边 · 业界新闻 | 41分钟前 | 云原生 · kubernetes · 业界新闻 · Kubernetes NameSpace enforce Pod Security Admission PSA warn audit Pod Security Standards
- Kubernetes Pod Security Admission 怎样把策略告警转成阻断
- 272浏览 收藏
-
- 科技周边 · 业界新闻 | 1天前 | 云原生 AI代理 CNCF 代理安全 OpenShell Agent Substrate
- 云原生社区如何应对代理安全边界
- 495浏览 收藏
-
- 科技周边 · 业界新闻 | 1天前 | 资源管理 · kubernetes · GPU Kubernetes 推理平台 资源效率
- Kubernetes推理平台如何评估资源效率
- 374浏览 收藏
-
- 科技周边 · 业界新闻 | 1天前 |
- CNCF AI Conformance Program解决兼容性什么问题
- 158浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1056次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1055次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1220次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1162次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1005次使用
-
- GitHub Actions schedule 仅在默认分支生效怎么办
- 2026-11-14 501浏览
-
- 蒙面演唱引争议,旺仔小乔被平台封禁
- 2025-08-08 501浏览
-
- openGauss向量驱动升级,RAC多写突破内核
- 2025-07-30 501浏览
-
- 安普瑞斯工厂放假,电芯供应受影响
- 2025-07-04 501浏览
-
- 农产品APP开发优势与功能全解析
- 2025-04-30 501浏览


