go/token.FileSet.AddFile 的作用不是打开磁盘文件,而是把一个源码文件登记到一段不重叠的 token.Pos 整数区间里。最稳妥的写法是让 FileSet.Base() 提供下一个文件的基准值,再用返回的 *token.File 把文件内偏移转换成位置值。
官方文档:https://pkg.go.dev/go/token#FileSet.AddFile
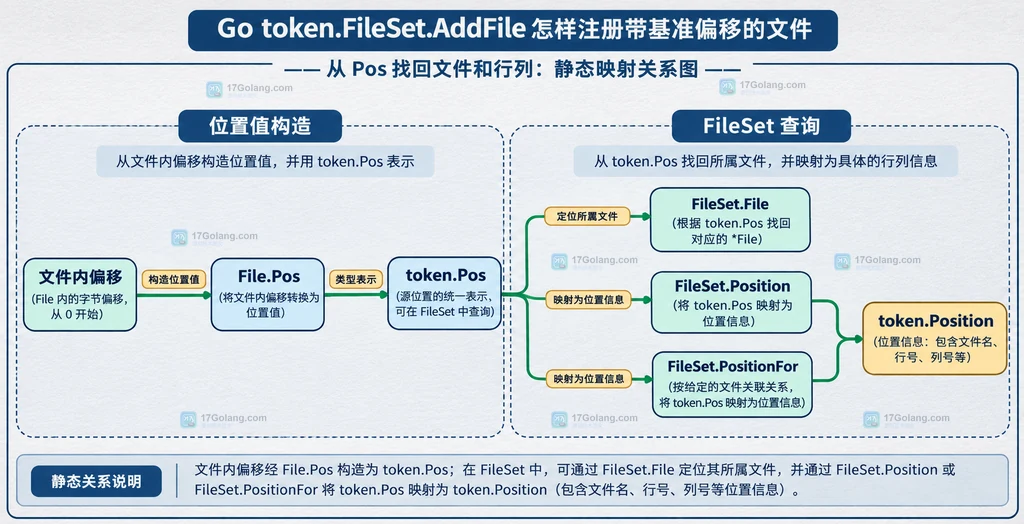
记住这条关系就够开始使用:文件内偏移为 offs 时,token.Pos 的整数值等于 base + offs;文件区间是 [base, base+size]。后续再用 FileSet.File、Position 或 PositionFor 把位置值解释回文件和行列。
先确定 FileSet 的文件区间模型
FileSet 可以看成源码位置的统一登记表。每次调用 AddFile(filename, base, size),都会登记一个文件名、一个起始基准和一个文件大小;它们共同决定该文件占用的 Pos 区间。这里的 filename 只是位置记录里的名称,不会替你读取文件内容。
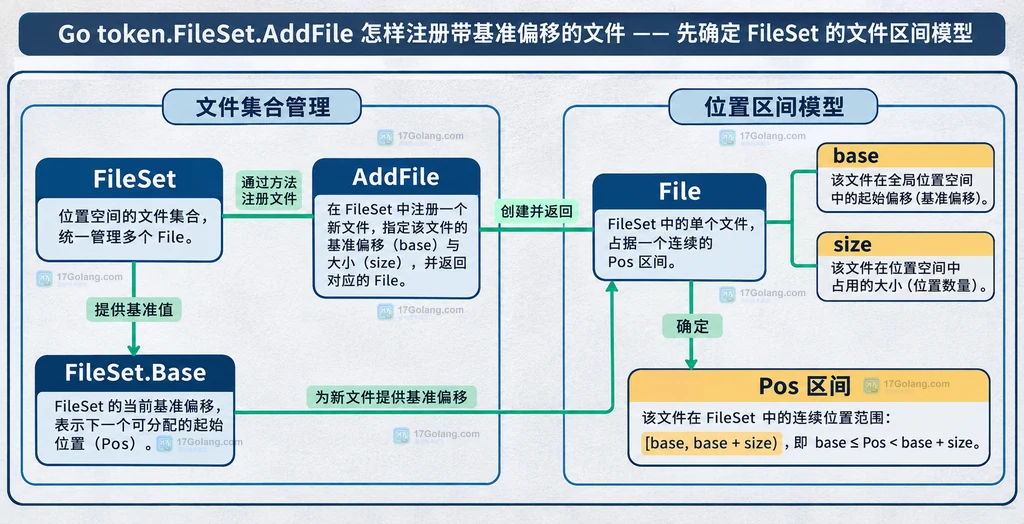
官方约定中,base 不能小于当前的 FileSet.Base(),size 不能为负数。登记完成后,FileSet.Base() 会至少移动到当前区间末端之后,供下一个文件使用。因此不同文件的位置区间不会因为文件名相同而自动合并,也不能随意让两个文件共享重叠的基准范围。
用 FileSet.Base 注册多个文件
生产代码不建议手算第二个文件的 base。可以直接把负数 base 交给 AddFile,表示使用当前的 FileSet.Base;也可以显式读取 set.Base() 后传入。下面的例子选择前一种写法,文件内容只用于计算大小,位置登记本身仍由调用方负责。
package main

import "go/token"

func registerFiles() (*token.FileSet, *token.File, *token.File) {
    set := token.NewFileSet()
    mainSource := []byte("package main\nfunc main() {}\n")
    utilSource := []byte("package util\nfunc Add() {}\n")

    // 负 base 表示使用当前 FileSet.Base,避免手算不重叠区间。
    mainFile := set.AddFile("main.go", -1, len(mainSource))
    // 第二个文件会获得新的区间,大小必须与登记的内容长度一致。
    utilFile := set.AddFile("util.go", -1, len(utilSource))
    return set, mainFile, utilFile
}
如果需要显式控制基准,也可以先读取 set.Base():
func addWithExplicitBase(set *token.FileSet, name string, size int) *token.File {
    // Base 是下一个文件允许使用的最小起点,不要回退到旧区间。
    base := set.Base()
    // AddFile 只登记位置区间,不负责校验 name 对应的磁盘文件。
    return set.AddFile(name, base, size)
}
两种形式的核心语义相同:FileSet.Base() 负责提供连续的坐标空间,AddFile 负责把该空间切成一个文件区间。若业务确实要扩展某个文件的区间,应在设计时保存并复用正确的基准,而不是在已有文件之间插入重叠范围。
把文件内偏移转换为 token.Pos
登记文件之后,分析器通常拿到的是该文件内的字节偏移,例如词法扫描器返回的第 12 个字节。不要直接把这个偏移强转成 token.Pos,因为它还没有带上文件自己的 base。应通过对应的 *token.File.Pos 生成位置值。
func sourcePosition(file *token.File, offset int) token.Pos {
    // offset 必须落在该文件登记的 [0, Size()] 范围内。
    return file.Pos(offset)
}

func fileOffset(file *token.File, pos token.Pos) int {
    // Pos 的整数值包含文件基准,减去 Base 才是文件内偏移。
    return int(pos) - file.Base()
}
File.Pos 让调用方不必了解内部基准;反向计算时,File.Base() 与 File.Offset(pos) 更适合表达“这个位置属于该文件的第几个字节”。如果位置不属于该文件的区间,就不要把它当成该文件的偏移继续处理。
从 Pos 找回文件和行列
得到统一的 token.Pos 后,FileSet 提供三类查询:File(pos) 找到位置所属文件,Position(pos) 转成带文件名、行列的 token.Position,PositionFor(pos, adjusted) 则允许调用方明确是否考虑位置调整注释。
func describe(set *token.FileSet, pos token.Pos) token.Position {
    // 先确认 Pos 落在哪个登记文件中,避免把跨文件位置误归类。
    file := set.File(pos)
    if file == nil {
        return token.Position{}
    }

    // Position 等价于 PositionFor(pos, true),会返回文件、行和列。
    position := set.Position(pos)
    // file 还能提供该 Pos 在本文件内的偏移,便于诊断工具打印上下文。
    _ = file.Offset(pos)
    return position
}
如果工具要忽略源码中的 //line 位置调整,可以改用 set.PositionFor(pos, false);如果希望按调整后的源码位置解释,使用 true。这只是位置解释策略,不会改变 AddFile 登记的底层区间。
把 AddFile 放进源码分析流水线
一个常见的源码分析流水线可以分成四个职责:文件读取层拿到内容和文件名,位置登记层调用 AddFile,解析层使用对应的 *token.File 产生 Pos,诊断层再用 FileSet.Position 输出人类可读位置。这样做的好处是,文件内容读取和坐标管理互不混淆。
type SourceUnit struct {
    Name string
    Data []byte
    File *token.File
}

func registerUnit(set *token.FileSet, name string, data []byte) SourceUnit {
    // 先登记整个内容的字节大小,再让解析器使用 File.Pos 建立位置。
    file := set.AddFile(name, -1, len(data))
    // 行偏移表由调用方根据真实内容建立,FileSet 不会读取 data。
    file.SetLinesForContent(data)
    return SourceUnit{Name: name, Data: data, File: file}
}
SetLinesForContent 是可选的配套步骤:它根据内容建立行偏移表,之后 Position 才能给出有意义的行列。若只关心文件区间或字节偏移,可以不建立行表,但不能因此把 Pos 的整数值误认为从零开始的文件内偏移。
常见失败处理和边界
| 现象 | 原因 | 处理方式 |
|---|---|---|
| 第二个文件的 base 太小 | 手算基准时回退到了旧区间 | 优先使用 FileSet.Base() 或传负数让 AddFile 采用当前基准 |
| size 为负数 | 登记的文件长度无效 | 在调用前把长度归一化为真实非负字节数 |
| Pos 找不到文件 | 位置不在任何登记区间,或已经移除文件 | 先检查 FileSet.File(pos) 是否为 nil |
| 行列与预期不符 | 没有设置行偏移,或选择了不同的 adjusted 策略 | 按真实内容调用 SetLinesForContent,并固定 PositionFor 的参数约定 |
| 长时间运行内存增长 | FileSet 保留了不再使用的文件记录 | 确认没有诊断需求后调用 RemoveFile,并停止使用被移除文件的 Pos |
尤其要注意,AddFile 的登记范围是位置系统的契约,不是文件系统安全边界。它不会验证文件名是否存在,也不会自动读取、哈希或锁定文件;这些职责应由上层的输入和生命周期管理完成。
一张表记住使用边界
| 需求 | 对应 API | 关键约束 |
|---|---|---|
| 登记一个文件 | FileSet.AddFile | base 不小于当前 Base,size 不为负 |
| 取得下一个基准 | FileSet.Base | 用它避免新增区间重叠 |
| 构造文件位置 | File.Pos | 输入是该文件内偏移 |
| 反查所属文件 | FileSet.File | 找不到时返回 nil |
| 得到文件、行、列 | Position / PositionFor | 明确是否考虑位置调整注释 |
| 释放长期不用的记录 | FileSet.RemoveFile | 移除后不要继续依赖该文件的位置查询 |
最终可以把 FileSet.AddFile 理解成“登记坐标空间”,把 File.Pos 理解成“加入文件基准”,把 FileSet.Position 理解成“按统一坐标还原文件和行列”。只要每个文件都从不重叠的 Base 开始,源码分析器就能稳定地在多个文件之间传递位置。
相关问题
AddFile 会自动读取 filename 对应的文件吗?
不会。它只登记文件名、基准偏移和大小;文件内容读取、行偏移建立和内容生命周期都由调用方负责。
为什么推荐使用 FileSet.Base?
因为它返回下一个文件应使用的最小基准,能避免手工计算时让两个文件的 Pos 区间重叠。
FileSet.Position 和 PositionFor 有什么区别?
Position 等价于调用 PositionFor(pos, true)。需要明确忽略源码位置调整注释时,应显式调用 PositionFor(pos, false)。
 Go testing.T.Attr 如何向 CI 写入可筛选测试属性