Go 1.25 开始,testing.T.Attr 可以给测试事件附加结构化属性。它适合把“这是支付回归”“需要数据库”“属于冒烟集”这类元数据交给 CI 或测试框架,而不是把标签塞进普通日志文本。
官方文档:https://pkg.go.dev/testing#T.Attr
最小用法是:
func TestCheckout(t *testing.T) {
    // 属性键用于筛选,值只表达当前测试的稳定元数据。
    t.Attr("suite", "smoke")
    t.Attr("component", "checkout")
    // 这里继续执行真正的断言,Attr 不替代测试逻辑。
    if got, want := 2+2, 4; got != want {
        t.Fatalf("结果不正确:got=%d want=%d", got, want)
    }
}
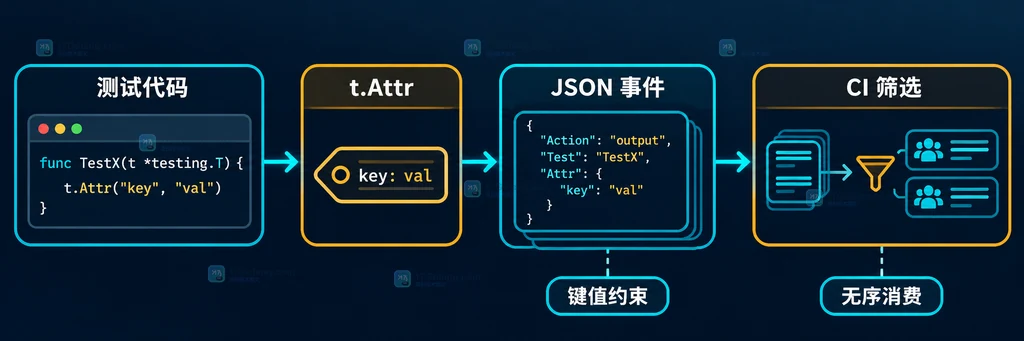
关键点是:Attr 记录的是测试元数据,CI 再从机器可读的测试事件中消费它。不要把它当成带顺序保证的日志 API,也不要让 CI 依赖某一行文本恰好出现在另一行之前。
先确认 Attr 的四个语义
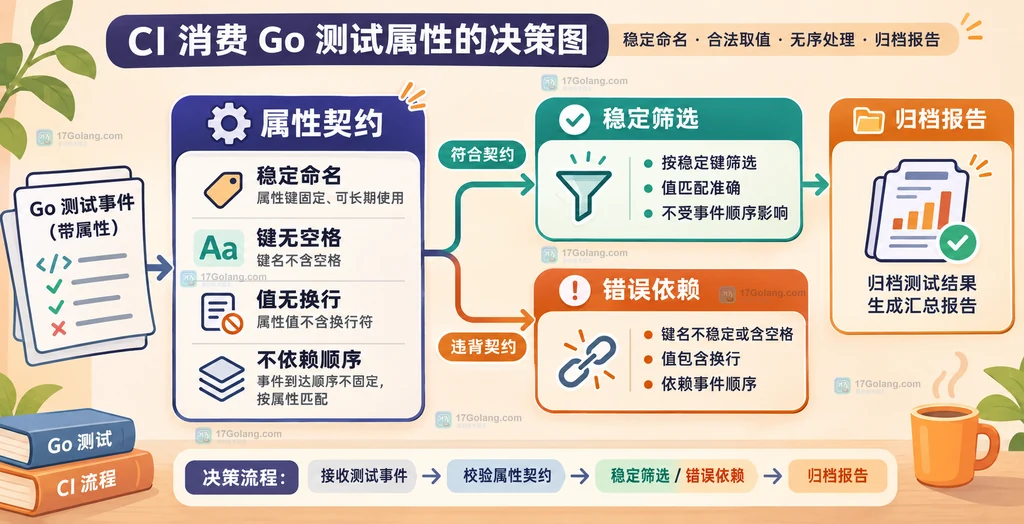
官方文档把 (*T).Attr 标记为 Go 1.25.0 新增方法。它会为当前测试发出属性,键不能含空白,值不能含换行或回车;属性的具体含义由 CI 系统和测试框架解释。
还有一个容易忽略的语义:属性会立即写入测试日志,但被设计为无序数据。也就是说,属性适合表达“这个测试是什么”,不适合表达“步骤一完成后再做步骤二”。后者应该用测试断言、子测试或普通诊断日志完成。
属性键要稳定,值要能筛选
建议把属性设计成低基数、可复用的字段,而不是把请求 ID、时间戳或完整错误堆栈写进去。这样 CI 才能用同一套规则跨提交筛选。
| 属性 | 适合表达 | 不建议表达 |
|---|---|---|
suite=smoke | 测试集合 | 带空格的长句 |
component=checkout | 业务组件 | 一次运行才有意义的随机 ID |
dependency=postgres | 外部依赖类型 | 完整连接串或敏感配置 |
键名可以采用小写短词或稳定的命名空间,例如 suite、component、dependency。不要把 CI 厂商名称写进所有键名,否则迁移流水线时会把测试代码和平台实现绑死。
func TestSearch(t *testing.T) {
    // 这些值跨运行保持稳定,便于 CI 做集合筛选。
    t.Attr("suite", "regression")
    t.Attr("component", "search")
    t.Attr("dependency", "redis")
    // 测试代码仍然负责准备数据和执行断言。
    if err := runSearchCase(); err != nil {
        t.Fatalf("搜索用例失败:%v", err)
    }
}
用 go test -json 交给机器消费
如果 CI 需要做结构化处理,入口应是机器可读的测试事件,而不是解析人类日志。常见做法是让 go test 输出 JSON 事件,再由流水线中的解析器按测试名和属性构建索引。
# 用机器可读事件作为 CI 的输入,避免依赖彩色终端文本。
go test -json ./... > test-events.json

# 先保留原始事件,后续步骤再按属性和测试状态筛选。
test-events.json
这里的命令只说明数据流,不代表某个本地运行结果。实际 CI 中可以直接把标准输出交给下一步,也可以保存为构建产物。重点是让“采集”和“筛选”分开:测试负责发出属性,CI 负责决定哪些属性进入哪种报告。
由于属性是无序的,解析器应把同一测试关联到的属性视为集合或键值表。不要写成“读取到第一个 Attr 才初始化,第二个 Attr 才更新状态”的顺序状态机。
CI 筛选时不要依赖日志顺序
一个可迁移的 CI 规则通常分三层:先识别测试事件,再读取属性,最后把事件归档到报告。比如只想跑冒烟报告,可以筛选 suite=smoke;想统计 Redis 依赖,可以筛选 dependency=redis。
func TestPayment(t *testing.T) {
    // 用属性表达报告维度,不把筛选规则写成日志前缀。
    t.Attr("suite", "smoke")
    t.Attr("component", "payment")

    if err := runPaymentCase(); err != nil {
        // 错误详情属于诊断信息,不应塞进属性值。
        t.Fatalf("支付用例失败:%v", err)
    }
}
如果 CI 要求“属性缺失就失败”,应由消费端显式检查缺失,而不是让测试函数通过一个空字符串伪造属性。这样问题会在报告中显示为元数据契约错误,定位比普通日志更直接。
重复属性、并行测试和版本兼容
同一个键如果被多次写入,消费端不要默认它一定是单值字段。除非团队明确规定“最后一次覆盖”,否则更稳妥的做法是保留值列表,或在测试规范中规定每个键只能出现一次。这个约定属于消费协议,不是 Attr 自动替你完成的业务规则。
Attr 本身不修改测试并发模型,也不会替代 t.Parallel 的同步语义。并行测试的属性应该描述测试本身,而不是记录某个 goroutine 的执行顺序。需要记录时间线时,使用带上下文的诊断日志或专门的 trace 数据。
如果项目需要兼容没有 Attr 的旧 Go 版本,可以把属性写入封装层,并用构建标签提供不同实现;不要在运行时用反射猜测方法是否存在。兼容层的目标是让业务测试继续清晰,而不是把版本判断散落在每个测试函数中。
//go:build go1.25

package testmeta

import "testing"

// Attr 把统一的测试元数据入口收口到一个小封装中。
func Attr(t *testing.T, key, value string) {
    // 调用方只传稳定键值,版本差异集中在这个包内处理。
    t.Attr(key, value)
}
一张表记住使用边界
| 问题 | 建议 |
|---|---|
| 属性键能不能带空格 | 不能,使用短小稳定的键名 |
| 属性值能不能带换行 | 不能,错误堆栈放到日志或报告附件 |
| 能不能依赖属性出现顺序 | 不能,按无序键值集合消费 |
| 能不能用 Attr 替代断言 | 不能,Attr 只记录元数据 |
| CI 应该解析什么 | 解析机器可读测试事件,再按属性筛选 |
最终可以把它概括成一句话:t.Attr 负责声明“这个测试属于什么”,go test -json 负责提供机器可读的事件流,CI 负责按稳定规则筛选和归档。三者职责分开,测试代码就不会被某个平台的日志格式绑住。
相关问题
testing.T.Attr 的键为什么不能包含空格?
因为键需要稳定地作为结构化属性名被测试框架和 CI 读取。包含空格会让跨工具解析和规则匹配变得不一致。
Attr 能不能记录失败原因?
不建议。失败原因通常是高基数、可能包含换行的诊断信息,应放在测试日志或报告附件中;Attr 更适合低基数分类。
属性顺序能不能代表测试步骤?
不能。官方语义把属性视为无序数据,步骤关系应由测试逻辑、子测试或专门的追踪信息表达。
 Go dwarf.UnspecifiedType 怎样在类型报告中单独标记