Go 的 encoding/json 在编码 NaN、+Inf 或 -Inf 时会返回 *json.UnsupportedValueError。这不是 JSON 标签、字段导出或字符转义问题,而是输入浮点值超出了标准 JSON 能表示的数值范围。
本文只讨论标准库的定位方法:先确认错误类型,再读取 Value 和 Str,最后把特殊值追到业务字段。相关类型的官方说明见 https://pkg.go.dev/encoding/json#UnsupportedValueError。
先把错误类型认出来
最小复现不需要复杂结构。只要把特殊浮点值交给 json.Marshal,就能看到这条错误路径:
package main

import (
    "encoding/json"
    "fmt"
    "math"
)

func main() {
    // NaN 不是标准 JSON 数字,Marshal 会返回 UnsupportedValueError。
    payload := map[string]float64{"score": math.NaN()}
    _, err := json.Marshal(payload)
    if err != nil {
        fmt.Printf("%T: %v\n", err, err)
    }
}
输出通常形如 *json.UnsupportedValueError: json: unsupported value: NaN。类型断言可以读取结构体字段,但生产代码更适合用 errors.As,因为错误可能被业务层包裹。
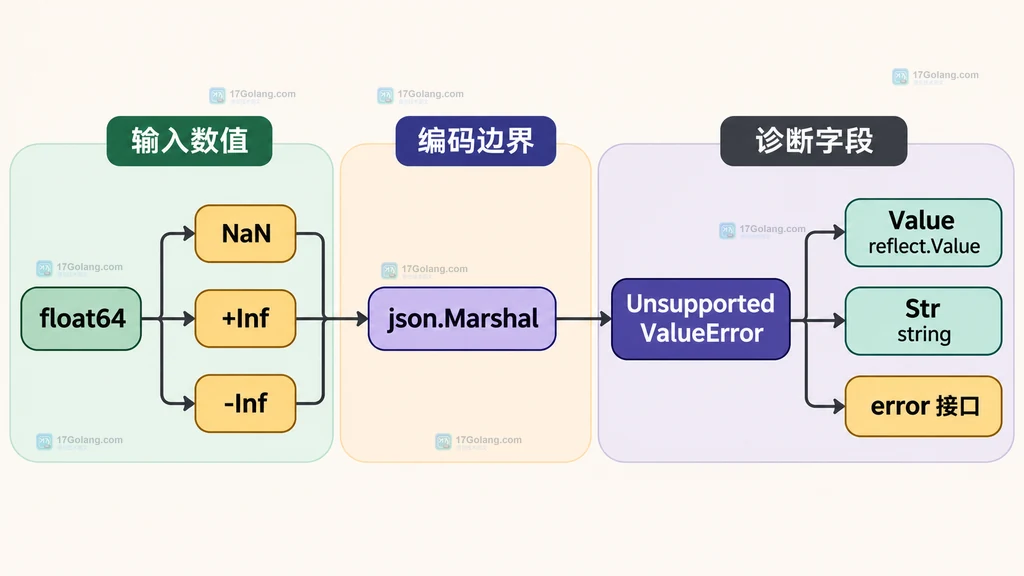
读取 Value 与 Str,确认失败值
UnsupportedValueError 暴露了两个排查入口:Value 保存触发错误的反射值,Str 保存用于错误描述的字符串。读取时要先判断指针是否为空,再读取反射值。
package main

import (
    "encoding/json"
    "errors"
    "fmt"
)

func inspectMarshalError(err error) {
    var unsupported *json.UnsupportedValueError
    if !errors.As(err, &unsupported) {
        // 其它编码错误不能按特殊浮点值路径处理。
        fmt.Printf("unexpected marshal error: %v\n", err)
        return
    }

    // Str 适合记录错误文本,Value 适合继续做反射或类型判断。
    fmt.Printf("unsupported value=%q kind=%s\n", unsupported.Str, unsupported.Value.Kind())
}
Str 可能是 NaN、+Inf 或 -Inf。它能说明哪一种特殊值触发了失败,但通常不能直接告诉你完整的结构体字段路径。Value 也只代表触发值本身,字段名和父对象关系需要在编码前补充。
从错误值追到业务字段
如果只在 json.Marshal 之后检查错误,定位信息往往已经被压缩成一个浮点值。更稳妥的方式是在数据进入编码边界前,沿着业务结构检查可疑字段,并把路径写入上下文。
package main

import (
    "fmt"
    "math"
)

type Report struct {
    Price   float64            `json:"price"`
    Metrics map[string]float64 `json:"metrics"`
}

func validateReport(r Report) error {
    // 先检查高频字段,让错误直接带上业务路径。
    if math.IsNaN(r.Price) || math.IsInf(r.Price, 0) {
        return fmt.Errorf("report.price contains unsupported float: %v", r.Price)
    }
    for name, value := range r.Metrics {
        // map 的键就是定位上下文的一部分,不能只记录 value。
        if math.IsNaN(value) || math.IsInf(value, 0) {
            return fmt.Errorf("report.metrics[%q] contains unsupported float: %v", name, value)
        }
    }
    return nil
}
这段检查把“错误值”转换成了“字段路径 + 错误值”。对于更深的嵌套对象,可以继续沿用同一原则:在进入 JSON 编码边界前,为每个检查点维护路径;不要指望 UnsupportedValueError 自动补全业务对象的字段名。
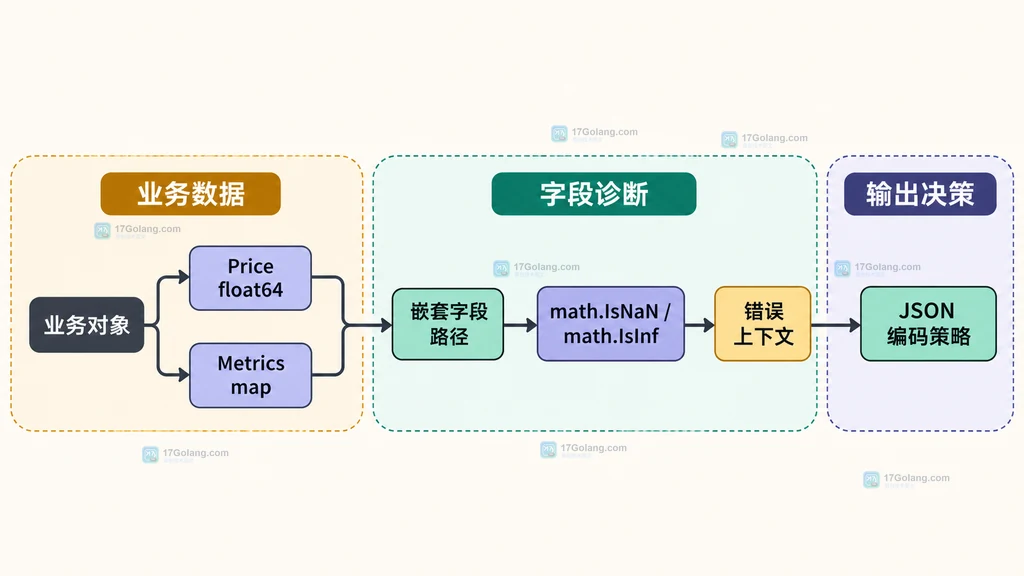
区分 NaN、+Inf 和 -Inf
三种值都不能直接编码成标准 JSON 数字,但业务含义可能不同。math.IsNaN 用来识别未定义结果,math.IsInf(v, 1) 和 math.IsInf(v, -1) 分别识别正、负无穷。
func classifyFloat(value float64) string {
    // 分类只负责诊断,不擅自改变业务值。
    switch {
    case math.IsNaN(value):
        return "NaN"
    case math.IsInf(value, 1):
        return "+Inf"
    case math.IsInf(value, -1):
        return "-Inf"
    default:
        return "finite"
    }
}
不要用普通的等号判断 NaN,因为 NaN != NaN。也不要把所有非有限值一律替换成零:这会掩盖计算溢出、缺失值或除零问题,应该由业务契约决定输出形式。
在编码边界选择处理策略
确认字段后,处理策略通常有三类。第一类是保留错误,适合金额、计费和审计数据;第二类是在业务层预处理,把特殊值转换成指针为空、字符串或明确的状态字段;第三类是使用业务允许的有限值,但必须记录替换原因。
func encodeReport(r Report) ([]byte, error) {
    // 业务约定要求非法浮点值阻断输出,而不是静默修正。
    if err := validateReport(r); err != nil {
        return nil, err
    }
    return json.Marshal(r)
}
如果选择字符串表示,应明确约定客户端能接受 "NaN"、"+Inf" 和 "-Inf";如果选择空值,则要区分“没有值”和“计算结果无效”。策略应放在编码边界之前,避免散落在日志、HTTP 响应和消息序列化的多个调用点。
常见排查边界
- 错误被
fmt.Errorf("%w", err)包裹时,用errors.As,不要只做直接类型断言。 - 接口、指针或嵌套 map 里的浮点值可能来自更深层对象,应在业务字段层保存路径。
- 日志只打印
Str会丢失业务上下文,至少同时记录请求标识、字段路径和对象来源。 - 不要把第三方 JSON 库的兼容行为套到
encoding/json;本文结论只针对 Go 标准库。
小结
json.UnsupportedValueError 的核心信号是标准 JSON 无法表示输入中的 NaN 或无穷值。先用 errors.As 确认类型,再读取 Str 与 Value,最后在业务数据进入 json.Marshal 前用 math.IsNaN、math.IsInf 和字段路径补齐上下文。这样既能保留真实错误,也能让后续的输出策略有明确边界。
 Go math/bits.Mul64 怎样拆分 128 位乘法结果