
MySQL CUME_DIST 怎样计算累计分布比例
做分层报表时,我更常用 CUME_DIST() 回答“当前值已经覆盖了这一组数据的多少比例”,而不是只看名次。它会把窗口分区中小于等于当前排序值的行数除以分区总行数,结果范围是 0 到 1;同一个排序值的并列行会得到相同的累计比例。
官方地址:https://dev.mysql.com/doc/refman/8.4/en/window-function-descriptions.html
CUME_DIST()依赖窗口排序,分子包含当前行和与它并列的行。PARTITION BY决定“在哪一组里算”,ORDER BY决定“按什么值累计”。- 同值行是 peer,会一起跳到同一个累计比例;这不是行号连续增长。
- 没有
ORDER BY时,整个分区被视为并列,结果会退化为 1。
先把累计分布看成一个比例
假设一组订单按金额从低到高排列。某一行金额为 300 元时,如果这一行以及它之前的行一共覆盖了 8 条记录,而分区总共有 10 条记录,那么 CUME_DIST() 就是 0.8。它表达的是“这个值不超过当前值的记录占比”,不是“当前行排第几”。
最小写法如下,窗口里只保留一个排序键:
SELECT
    amount,
    -- 按金额升序计算:小于等于当前金额的行数 / 分区总行数
    CUME_DIST() OVER (ORDER BY amount) AS cumulative_ratio
FROM order_amounts;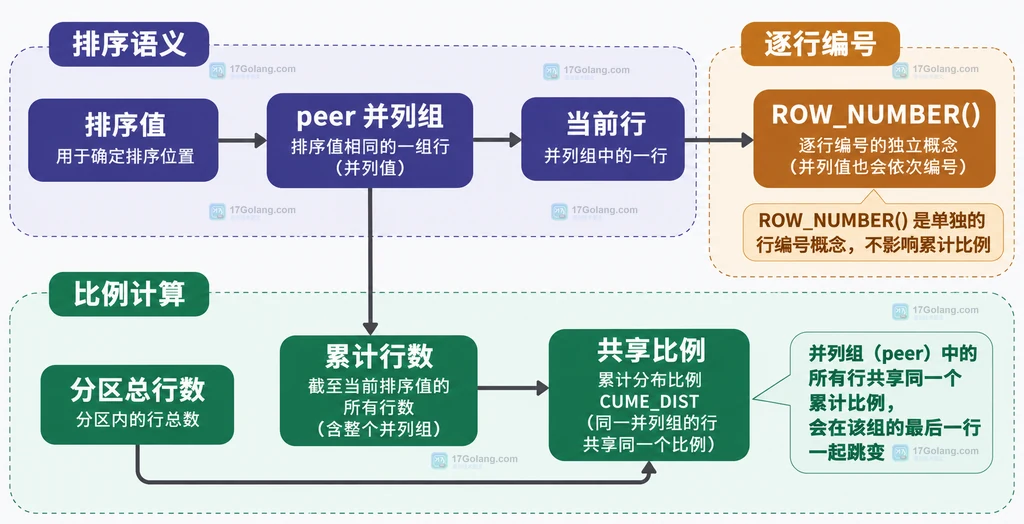
这个比例的分母是窗口分区里的总行数,所以它天然适合回答覆盖率、累计占比、阈值覆盖到哪一段等问题。若业务要的是“第几名”,就不应只看这个小数。
用 PARTITION BY 把累计范围限定在业务分组内
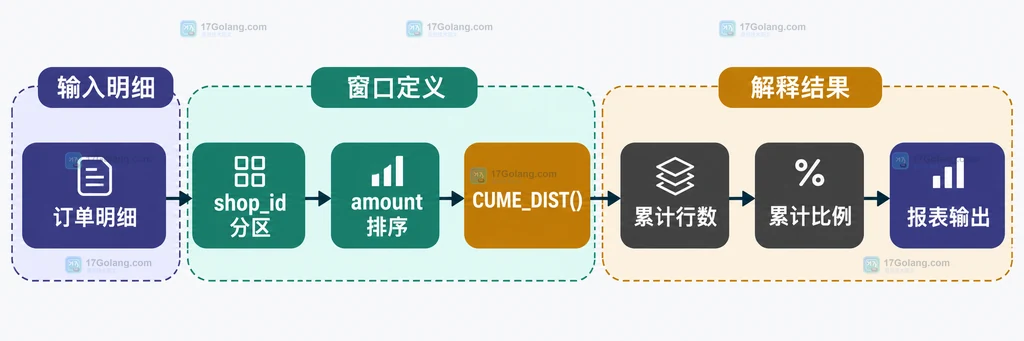
实际报表通常不是把所有订单混在一起算,而是分别计算每个门店、渠道或月份。此时把分组列放进 PARTITION BY,把参与累计的指标放进 ORDER BY:
SELECT
    shop_id,
    order_id,
    amount,
    -- 每家门店单独计算金额累计分布,互不影响
    CUME_DIST() OVER (
        PARTITION BY shop_id
        ORDER BY amount
    ) AS shop_cumulative_ratio
FROM order_amounts;
这里的窗口分区是“同一个 shop_id 的所有行”。门店 A 的分母不会包含门店 B 的订单,因此输出字段可以直接用于门店内的覆盖率或分层报表。若还要按月份隔离,只需把月份字段加入分区键,并先保证它代表稳定的业务周期。
并列值会让比例一起跳变
这是第一次使用时最容易误读的地方。假设同一分区排序后有 6 行,金额为 10、10、20、30、30、40。两行金额为 10 的记录都属于当前值的 peer,它们的累计行数都是 2,所以比例都是 2/6;两行金额为 30 的记录都会得到 5/6,而不是分别得到 4/6 和 5/6。
SELECT
    amount,
    -- 同值金额作为一个 peer 组,共享同一个累计分布比例
    CUME_DIST() OVER (ORDER BY amount) AS cumulative_ratio,
    -- 行号仍然逐行增加,只用于展示两者的语义不同
    ROW_NUMBER() OVER (ORDER BY amount, order_id) AS row_no
FROM order_amounts
ORDER BY amount, order_id;
ROW_NUMBER() 为每行编号,CUME_DIST() 为排序值形成的累计分布。为了让最终明细展示稳定,外层排序可以加上唯一键;但如果唯一键也放进 CUME_DIST() 的窗口排序,peer 的定义就会改变,必须确认这是否符合报表含义。
NULL 和没有 ORDER BY 时要单独判断
MySQL 文档说明窗口函数默认使用 RESPECT NULLS,也就是会把 NULL 纳入计算。NULL 在排序中的位置会影响它所在分区的累计位置,因此金额或评分字段如果允许为空,建议先明确业务语义:NULL 是“未知”,还是要当成最低档参与排序。
SELECT
    shop_id,
    amount,
    -- 用显式条件把 NULL 放到业务指定的位置,再计算累计比例
    CUME_DIST() OVER (
        PARTITION BY shop_id
        ORDER BY (amount IS NULL), amount
    ) AS cumulative_ratio
FROM order_amounts;
另一个边界是遗漏 ORDER BY:
SELECT
    shop_id,
    amount,
    -- 没有排序时,分区中的所有行都是 peer,结果会退化为 1
    CUME_DIST() OVER (PARTITION BY shop_id) AS ratio_without_order
FROM order_amounts;这条查询语法上可以表达窗口计算,但它不再表示“按金额累计”。如果目标是累计比例,ORDER BY 不是可有可无的装饰,而是定义累计方向的核心部分。
CUME_DIST、PERCENT_RANK 和 RANK 怎么选
我在报表里会先问读者需要“覆盖率”还是“名次”。CUME_DIST() 返回小于等于当前值的累计比例;PERCENT_RANK() 更接近相对名次,计算基于 (rank - 1) / (rows - 1);RANK() 返回名次并为并列值留下间隔;ROW_NUMBER() 则强制给每行一个唯一序号。
| 函数 | 回答的问题 | 并列值表现 |
|---|---|---|
CUME_DIST() | 当前值及之前覆盖了多少比例 | 并列行共享累计比例 |
PERCENT_RANK() | 当前行的相对名次是多少 | 并列行共享名次比例 |
RANK() | 当前值的名次是多少 | 并列后名次会跳号 |
ROW_NUMBER() | 当前行在排序结果中的序号 | 每行都不同,需要稳定排序键 |
如果报表要标记“达到某个金额后覆盖了 90% 的订单”,选择 CUME_DIST();如果要展示竞赛名次或排名百分位,再考虑 RANK() 与 PERCENT_RANK()。不要先选函数,再强行解释结果。
落地到报表时保留原始字段
最后一步不要只输出比例。保留分组键、业务主键、排序字段和比例,读者才能追溯某个比例对应的原始记录:
SELECT
    shop_id,
    order_id,
    amount,
    -- 输出可解释的累计分布字段,保留原始业务列便于追溯
    CUME_DIST() OVER (
        PARTITION BY shop_id
        ORDER BY amount
    ) AS cumulative_ratio
FROM order_amounts
ORDER BY shop_id, amount, order_id;
发布前可以用三句话自查:分区是不是业务上真正独立的范围;窗口排序是不是读者理解的累计方向;并列值和 NULL 的处理是否写进了字段说明。这样得到的比例才不会因为换了排序键或新增一条并列记录而被误读。
常见疑问
CUME_DIST() 的结果为什么不是整数?
它返回的是累计行数除以分区总行数的比例,范围在 0 到 1 之间;需要百分数展示时可以在外层乘以 100 或由报表层格式化。
并列值为什么没有得到连续的 0.2、0.4、0.6?
因为 CUME_DIST 按排序值的 peer 组处理,同一个值的记录都会计入当前累计行数并共享结果。要逐行编号应使用 ROW_NUMBER,并提供稳定的唯一排序键。
可以用 CUME_DIST 找到前 90% 的记录吗?
可以先计算累计比例,再按业务需要筛选阈值;但要说明并列值可能让结果一次跨过 0.9,不能把它当成严格切开同值记录的分页边界。
 MySQL GTID_SUBSET 怎样判断两个 GTID 集合的包含关系
- 上一篇
- MySQL GTID_SUBSET 怎样判断两个 GTID 集合的包含关系
- 下一篇
- 暂无
-
- 数据库 · MySQL | 22小时前 | mysql PROCESS权限 INNODB_CACHED_INDEXES InnoDB buffer pool 索引缓存页
- MySQL INNODB_CACHED_INDEXES 查看每个索引的缓存页
- 170浏览 收藏
-
- 数据库 · MySQL | 1天前 |
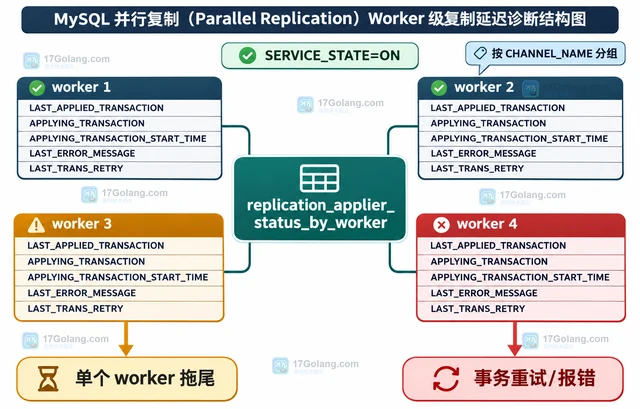
- MySQL复制延迟从状态表判断
- 134浏览 收藏
-
- 数据库 · MySQL | 1天前 |
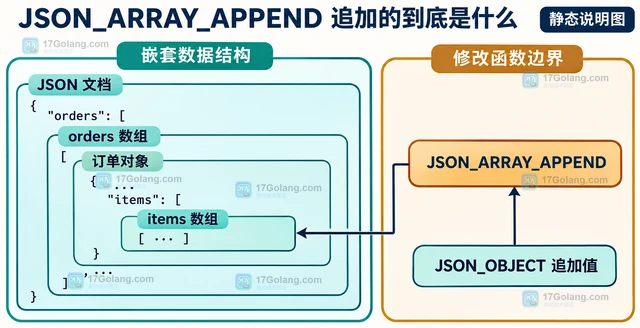
- MySQL JSON_ARRAY_APPEND 怎样把值追加到嵌套数组
- 248浏览 收藏
-
- 数据库 · MySQL | 1天前 |
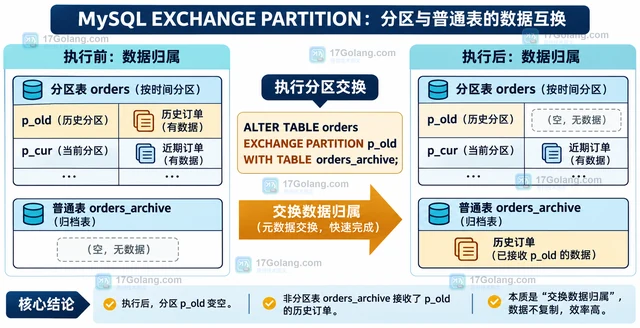
- MySQL EXCHANGE PARTITION 怎样把历史数据移到归档表
- 277浏览 收藏
-
- 数据库 · MySQL | 1天前 | mysql innodb lock ALTER TABLE 元数据锁 ALGORITHM 在线DDL
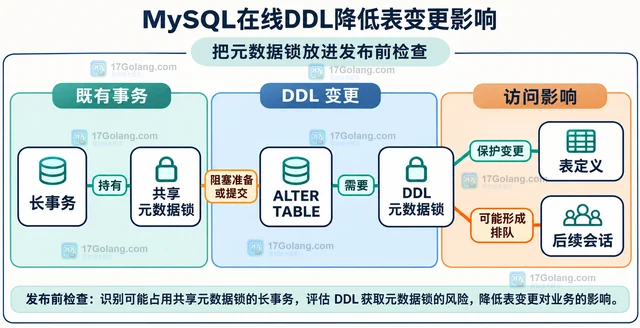
- MySQL在线DDL降低表变更影响
- 358浏览 收藏
-
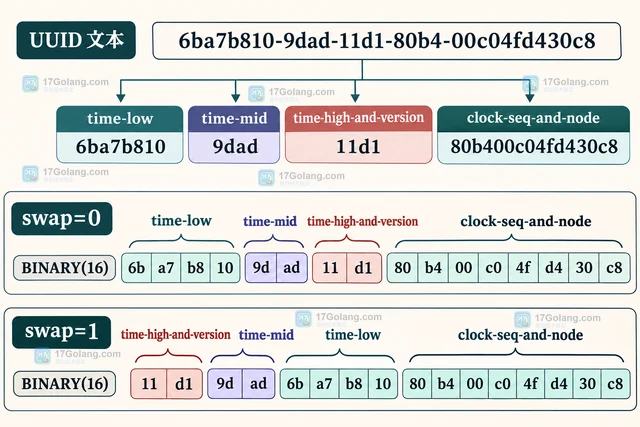
- 数据库 · MySQL | 1天前 | MySQL · 索引 · uuid · mysql innodb UUID_TO_BIN BIN_TO_UUID BINARY(16)
- MySQL UUID_TO_BIN 的 swap 参数怎样让时间型 UUID 保持索引顺序
- 176浏览 收藏
-
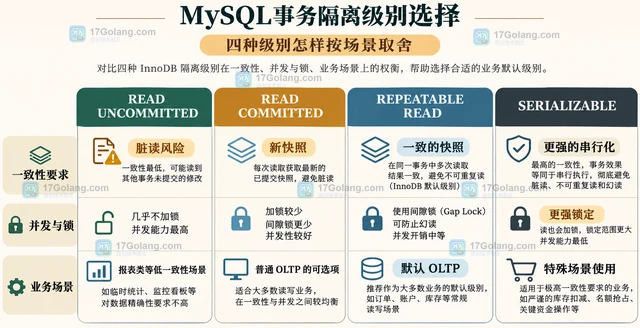
- 数据库 · MySQL | 1天前 | 事务 · 并发控制 · InnoDB · MySQL教程 · mysql innodb 事务隔离级别 Serializable READ COMMITTED REPEATABLE READ
- MySQL事务隔离级别选择
- 188浏览 收藏
-
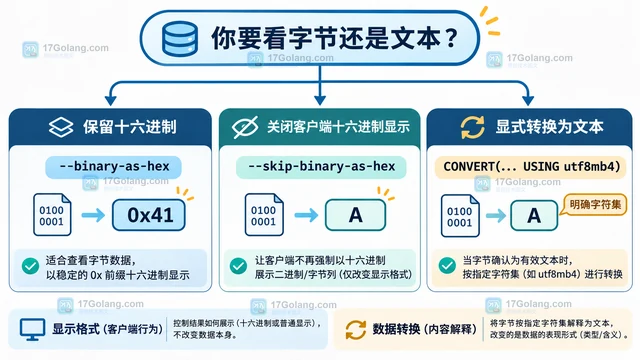
- 数据库 · MySQL | 1天前 |
- MySQL命令行为什么把二进制结果显示成0x开头
- 462浏览 收藏
-
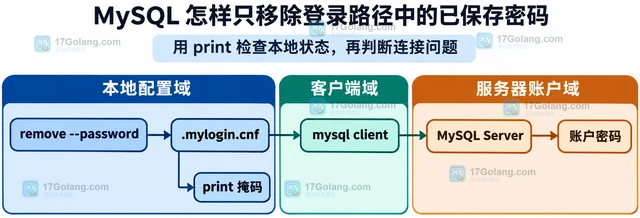
- 数据库 · MySQL | 1天前 |
- MySQL怎样只移除登录路径中的已保存密码
- 382浏览 收藏
-
- 数据库 · MySQL | 1天前 | MySQL教程 · mysql SRID 空间函数 GIS ST_Buffer ST_Buffer_Strategy
- MySQL ST_Buffer 怎样为几何对象生成缓冲区
- 235浏览 收藏
-
- 数据库 · MySQL | 1天前 |
- MySQL生成列配合函数索引
- 295浏览 收藏
-
- 数据库 · MySQL | 1天前 | mysql 空间函数 ST_PointAtDistance
- MySQL ST_PointAtDistance为何报距离越界
- 275浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1052次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1051次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1211次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1159次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1002次使用
-
- MySQL 明明加了索引,为什么查询还是很慢?先查这 6 个点
- 2026-06-27 374浏览
-
- golang MySQL实现对数据库表存储获取操作示例
- 2022-12-22 499浏览
-
- golang 基于 mysql 简单实现分布式读写锁
- 2023-01-07 384浏览
-
- 详解如何利用GORM实现MySQL事务
- 2023-01-07 184浏览
-
- Go语言实现操作MySQL的基础知识总结
- 2023-01-23 265浏览


