
MySQL复制延迟从状态表判断
排查 MySQL 复制延迟时,很多人先看 SHOW REPLICA STATUS 里的 Seconds_Behind_Source。这个字段适合快速判断,但它只描述应用线程相对接收线程的一个时间差;当网络、并行复制、复制通道或人为延迟介入时,单个秒数很容易让排查走偏。
官方地址:https://dev.mysql.com/doc/refman/8.4/en/performance-schema-replication-tables.html
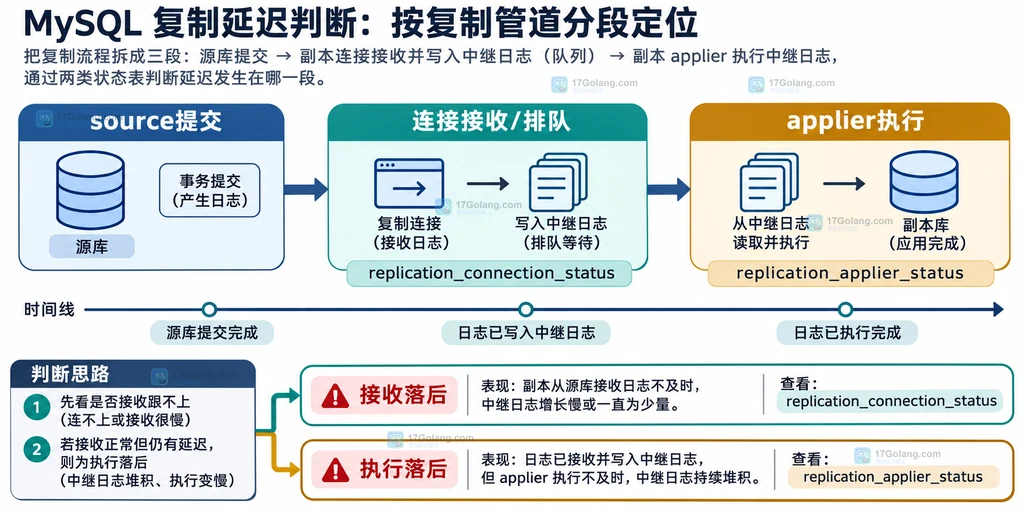
更可靠的顺序是先看replication_connection_status判断事务有没有正常接收并排入 relay log,再看replication_applier_status判断应用器是否工作,最后按需要下钻到replication_applier_status_by_worker。这样才能知道延迟发生在接收、排队还是执行。
先把复制延迟拆成接收与应用两段
一条异步复制链路至少有两个观察点:receiver 从 source 拉取事务并写入 relay log,applier 再从 relay log 取出事务执行。前者落后时,问题更接近连接、心跳、网络或 source 端产生事件的节奏;后者落后时,问题更接近 SQL 执行、锁等待、并行 worker 拖尾或事务重试。
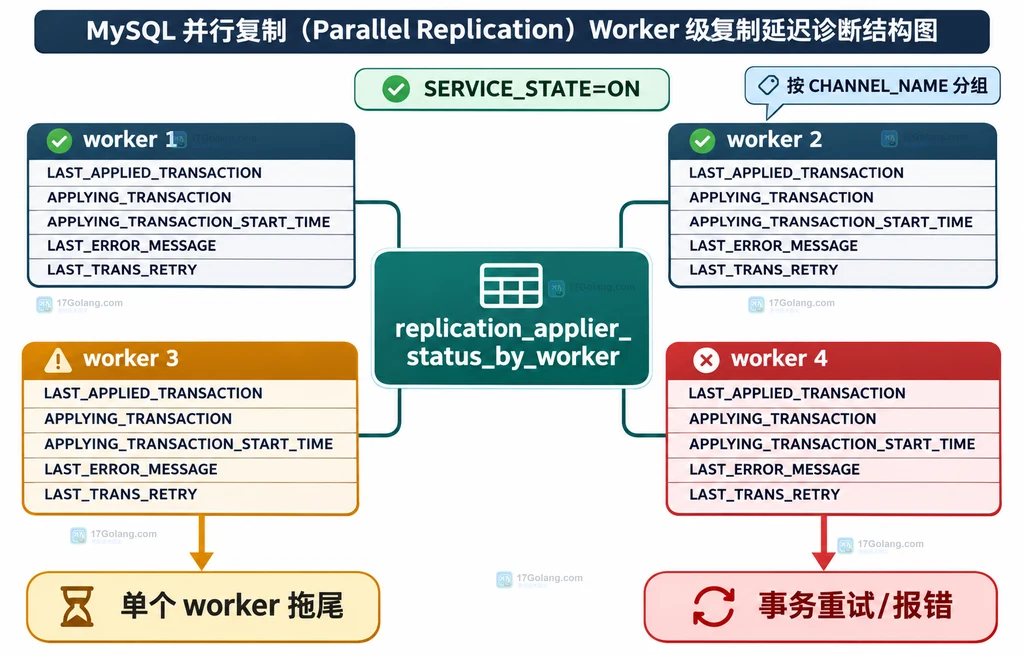
Performance Schema 的复制表适合程序化查询:可以按 CHANNEL_NAME 过滤、和其他表连接,也能把错误与时间字段保存下来。官方文档还特别说明,并行复制时状态表可以按 worker 保存信息,而 SHOW REPLICA STATUS 更适合人工快速查看。
先看连接状态表:事务有没有持续进入 relay log
replication_connection_status 描述 replica 到 source 的连接状态,以及连接线程最近排入 relay log 的事务。第一步不要急着计算延迟,先确认通道是否仍然工作、最近一次接收事务是什么,以及心跳是否还能到达。
-- 先按复制通道查看 receiver 的服务状态和最近一次排队事务
SELECT
    CHANNEL_NAME,
    SERVICE_STATE,
    LAST_QUEUED_TRANSACTION,
    LAST_QUEUED_TRANSACTION_ORIGINAL_COMMIT_TIMESTAMP,
    LAST_QUEUED_TRANSACTION_IMMEDIATE_COMMIT_TIMESTAMP,
    LAST_HEARTBEAT_TIMESTAMP,
    COUNT_RECEIVED_HEARTBEATS
FROM performance_schema.replication_connection_status
ORDER BY CHANNEL_NAME;

-- 只保留仍在运行但最近没有排队事务的通道,便于继续查连接或 source
SELECT CHANNEL_NAME, SERVICE_STATE, LAST_HEARTBEAT_TIMESTAMP
FROM performance_schema.replication_connection_status
WHERE SERVICE_STATE  'OFF'
  AND LAST_QUEUED_TRANSACTION IS NULL;
如果 SERVICE_STATE 已经是 OFF,或者长时间没有新的排队事务,就先不要把问题归因于 SQL 应用慢。反过来,如果 receiver 的最近事务持续前进,但应用器的最近事务不动,才说明 relay log 接收正常、执行端可能在积压。
用应用器状态表判断通道是否真的在追赶
replication_applier_status 给出通道级的应用状态。最重要的三个判断点是 SERVICE_STATE、REMAINING_DELAY 和 COUNT_TRANSACTIONS_RETRIES。其中 REMAINING_DELAY 只在配置了 SOURCE_DELAY 且正在等待时有意义,不能把它和普通积压混为一谈。
-- 查看通道级 applier 状态,区分停止、故意延迟和事务重试
SELECT
    CHANNEL_NAME,
    SERVICE_STATE,
    REMAINING_DELAY,
    COUNT_TRANSACTIONS_RETRIES
FROM performance_schema.replication_applier_status
ORDER BY CHANNEL_NAME;

-- 把已经停止或仍有重试记录的通道先挑出来处理
SELECT CHANNEL_NAME, SERVICE_STATE, COUNT_TRANSACTIONS_RETRIES
FROM performance_schema.replication_applier_status
WHERE SERVICE_STATE = 'OFF'
   OR COUNT_TRANSACTIONS_RETRIES > 0;
看到 REMAINING_DELAY 非空时,优先检查是否主动配置了延迟复制;这表示 applier 正在等待设定的延迟时间,而不一定是性能问题。看到重试次数增加时,则要继续看 worker 的最后错误和当前事务,判断是短暂锁冲突还是持续失败。
并行复制要下钻到 worker,不能只看总状态
当 replica_parallel_workers 大于 0 时,真正拖慢整体进度的可能只是一个 worker。replication_applier_status_by_worker 会保存每个 worker 的最后已应用事务、当前正在处理的事务、开始时间、重试次数和最后错误信息。把这些列放在同一张结果里,比只看总的 Seconds_Behind_Source 更容易找到拖尾。
-- 按通道和 worker 查看最后完成、当前执行、错误与重试信息
SELECT
    CHANNEL_NAME,
    WORKER_ID,
    SERVICE_STATE,
    LAST_APPLIED_TRANSACTION,
    APPLYING_TRANSACTION,
    APPLYING_TRANSACTION_START_TIME,
    LAST_APPLIED_TRANSACTION_END_APPLY_TIMESTAMP,
    LAST_APPLIED_TRANSACTION_RETRIES_COUNT,
    APPLYING_TRANSACTION_RETRIES_COUNT,
    LAST_ERROR_NUMBER,
    LAST_ERROR_MESSAGE
FROM performance_schema.replication_applier_status_by_worker
ORDER BY CHANNEL_NAME, WORKER_ID;

-- 只看出现错误、重试或仍在执行事务的 worker
SELECT
    CHANNEL_NAME,
    WORKER_ID,
    APPLYING_TRANSACTION,
    LAST_APPLIED_TRANSACTION_RETRIES_COUNT,
    APPLYING_TRANSACTION_RETRIES_COUNT,
    LAST_ERROR_NUMBER,
    LAST_ERROR_MESSAGE
FROM performance_schema.replication_applier_status_by_worker
WHERE LAST_ERROR_NUMBER  0
   OR LAST_TRANS_RETRY > 0
   OR APPLYING_TRANSACTION IS NOT NULL
ORDER BY CHANNEL_NAME, WORKER_ID;
判断时可以先按三个信号排序:一是 APPLYING_TRANSACTION_START_APPLY_TIMESTAMP 很早但当前事务仍未结束,说明该 worker 可能长时间卡在执行阶段;二是只有某个 worker 的 APPLYING_TRANSACTION_RETRIES_COUNT 或 LAST_APPLIED_TRANSACTION_RETRIES_COUNT 持续增加,说明拖尾与重试相关;三是 LAST_ERROR_MESSAGE 非空,说明应先处理应用错误,而不是盲目增加并行度。
为什么 Seconds_Behind_Source 为 0 仍不能直接宣布正常
Seconds_Behind_Source 的计算依赖 receiver 与 applier 的相对位置。网络连接较慢时,receiver 自己可能已经落后 source,但 applier 只是追上了 receiver,于是这个值仍可能显示为 0。类似地,在多通道、Group Replication 或时间戳信息不完整的场景中,一个汇总字段也不能代替分层状态。
-- 快速查看传统状态字段,但把它当作入口而不是最终结论
SHOW REPLICA STATUS\G

-- 用连接表和应用器表交叉检查:接收事务与应用事务是否都在前进
SELECT
    c.CHANNEL_NAME,
    c.SERVICE_STATE AS receiver_state,
    c.LAST_QUEUED_TRANSACTION,
    a.SERVICE_STATE AS applier_state,
    a.REMAINING_DELAY,
    a.COUNT_TRANSACTIONS_RETRIES
FROM performance_schema.replication_connection_status AS c
JOIN performance_schema.replication_applier_status AS a
  ON a.CHANNEL_NAME = c.CHANNEL_NAME
ORDER BY c.CHANNEL_NAME;
这组查询不是要制造一个新的“万能延迟秒数”,而是把证据拆开:receiver 不动时看连接与 source,receiver 前进而 applier 不动时看执行与锁,worker 单点异常时看事务和错误,REMAINING_DELAY 非空时先确认是否为主动延迟。
按状态组合排查,比按单字段排查更稳
| 状态组合 | 更可能的方向 | 下一步 |
|---|---|---|
| receiver 为 OFF,applier 也为 OFF | 通道停止或线程异常退出 | 先看 SHOW REPLICA STATUS 的 IO/SQL 错误和线程状态 |
| receiver 最近事务不前进,applier 没有明显错误 | 连接、心跳、source 产出或网络方向 | 结合 LAST_HEARTBEAT_TIMESTAMP 与连接配置继续查 |
| receiver 前进,applier 最近事务不前进 | 执行积压、锁等待或大事务 | 查看 worker 当前事务和开始时间 |
| 只有一个 worker 的执行开始时间很早 | 并行复制拖尾 | 检查该 worker 的事务、表热点和锁冲突 |
REMAINING_DELAY 非空 | 配置的 SOURCE_DELAY 尚未到期 | 先确认是否为预期的延迟复制,不要直接当作故障 |
| 重试次数增加且错误信息存在 | 事务应用失败后重试 | 保留错误信息,先处理根因再决定是否调整参数 |
实际值班时可以连续采集两次状态,而不是只读一次:第一次记录各表的事务和时间字段,间隔一小段时间后再次查询,比较 receiver、applier 和 worker 是否分别前进。这里的关键是观察变化方向,不是把某一次采样的空值或 0 当作最终结论。
一套可复用的状态表检查清单
- 先确定复制通道和当前使用的是 source/replica 术语,避免把旧字段名与新字段名混用。
- 查询
replication_connection_status,看连接服务状态、最近排队事务和心跳。 - 查询
replication_applier_status,看应用器是否开启、是否存在REMAINING_DELAY和重试。 - 启用并行复制时查询
replication_applier_status_by_worker,按 worker 找拖尾和最后错误。 - 把
SHOW REPLICA STATUS当作快速总览,再用状态表解释它为什么显示当前数值。 - 至少采样两次,确认事务时间戳和服务状态是否朝正常方向变化。
相关问题
只查 SHOW REPLICA STATUS 可以吗?
可以作为第一眼总览,但不适合作为复杂复制拓扑的唯一证据。需要区分 receiver、applier 或 worker 时,应继续查 Performance Schema 复制表。
replication_applier_status_by_worker 为空怎么办?
该表只在副本以多线程方式运行时才会按 worker 填充。先确认并行 worker 配置与复制线程是否已经启动,再决定是否需要下钻到 worker 级别。
REMAINING_DELAY 就是复制故障吗?
不一定。它表示配置的延迟复制正在等待剩余时间;如果业务本来就设置了 SOURCE_DELAY,这是预期状态。普通积压要结合连接表和 worker 表判断。
为什么重试次数会影响延迟判断?
事务应用失败后重试会占用 worker 的执行时间,可能让最后已应用事务停在原地。看到重试次数或错误信息持续增加时,应先定位失败原因,而不是只提高并行 worker 数量。
 MySQL JSON_ARRAY_APPEND 怎样把值追加到嵌套数组
- 上一篇
- MySQL JSON_ARRAY_APPEND 怎样把值追加到嵌套数组
- 下一篇
- Redis ZPOPMIN 怎样取出最低分成员并完成删除
-
- 数据库 · MySQL | 36分钟前 |
- MySQL JSON_ARRAY_APPEND 怎样把值追加到嵌套数组
- 248浏览 收藏
-
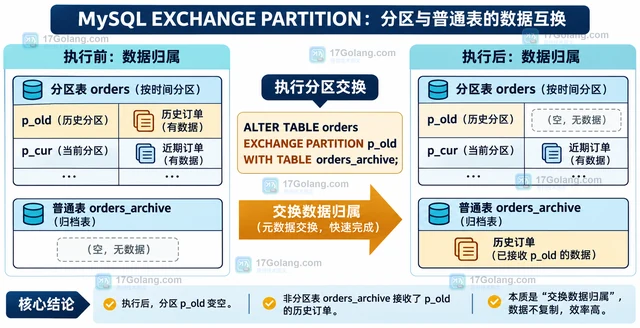
- 数据库 · MySQL | 40分钟前 |
- MySQL EXCHANGE PARTITION 怎样把历史数据移到归档表
- 277浏览 收藏
-
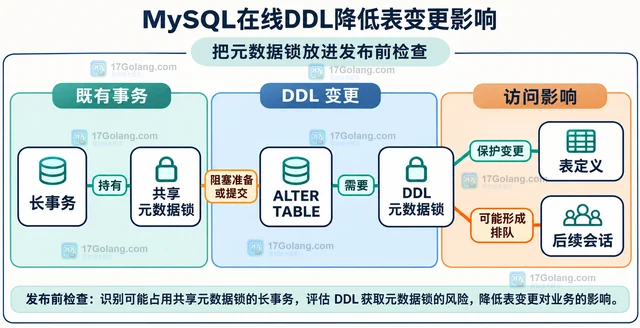
- 数据库 · MySQL | 43分钟前 | mysql innodb lock ALTER TABLE 元数据锁 ALGORITHM 在线DDL
- MySQL在线DDL降低表变更影响
- 358浏览 收藏
-
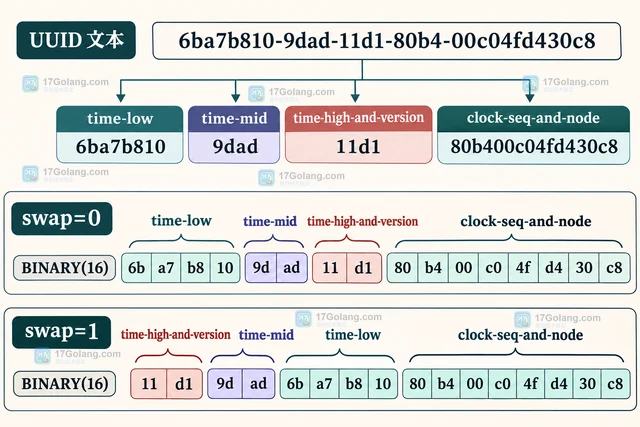
- 数据库 · MySQL | 44分钟前 | MySQL · 索引 · uuid · mysql innodb UUID_TO_BIN BIN_TO_UUID BINARY(16)
- MySQL UUID_TO_BIN 的 swap 参数怎样让时间型 UUID 保持索引顺序
- 176浏览 收藏
-
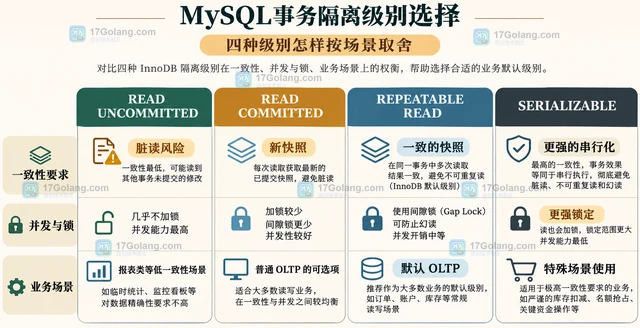
- 数据库 · MySQL | 45分钟前 | 事务 · 并发控制 · InnoDB · MySQL教程 · mysql innodb 事务隔离级别 Serializable READ COMMITTED REPEATABLE READ
- MySQL事务隔离级别选择
- 188浏览 收藏
-
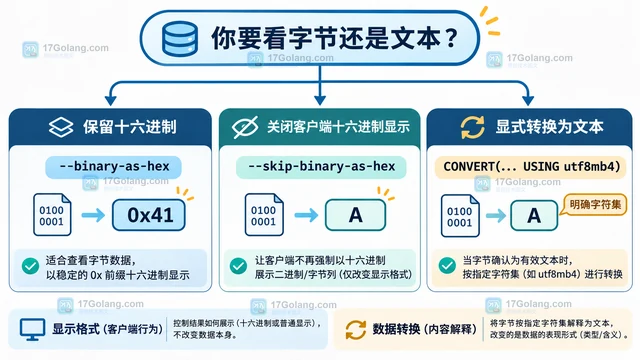
- 数据库 · MySQL | 50分钟前 |
- MySQL命令行为什么把二进制结果显示成0x开头
- 462浏览 收藏
-
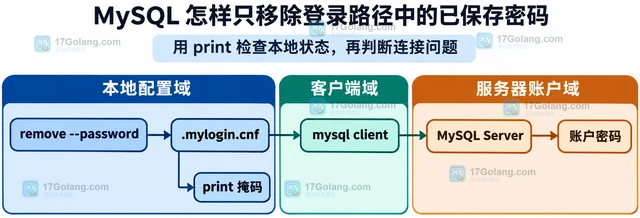
- 数据库 · MySQL | 54分钟前 |
- MySQL怎样只移除登录路径中的已保存密码
- 382浏览 收藏
-
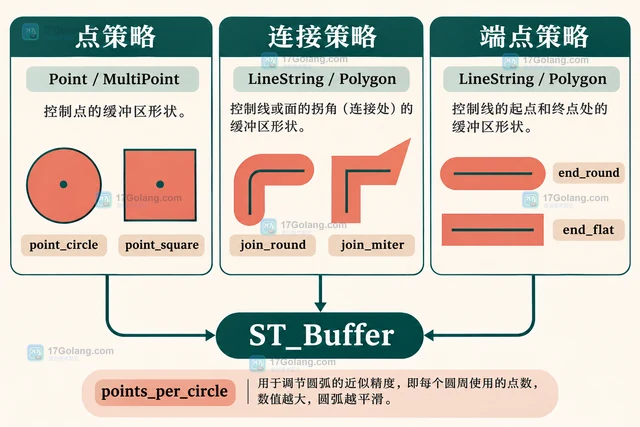
- 数据库 · MySQL | 1小时前 | MySQL教程 · mysql SRID 空间函数 GIS ST_Buffer ST_Buffer_Strategy
- MySQL ST_Buffer 怎样为几何对象生成缓冲区
- 235浏览 收藏
-
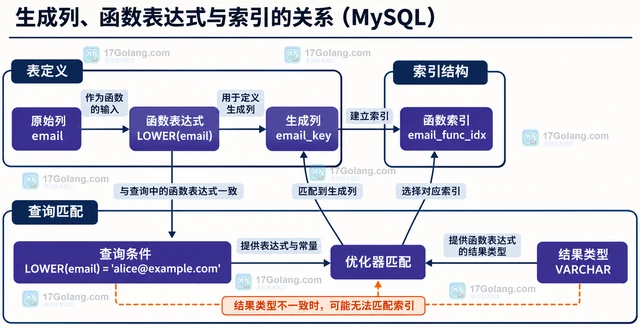
- 数据库 · MySQL | 1小时前 |
- MySQL生成列配合函数索引
- 295浏览 收藏
-
- 数据库 · MySQL | 1小时前 | mysql 空间函数 ST_PointAtDistance
- MySQL ST_PointAtDistance为何报距离越界
- 275浏览 收藏
-
- 数据库 · MySQL | 15小时前 | MySQL · 错误排查 · mysql 空间数据 长度单位 ST_FrechetDistance SRID 0 ER_GEOMETRY_IN_UNKNOWN_LENGTH_UNIT
- MySQL ST_FrechetDistance 指定米单位为什么报错
- 360浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1035次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1033次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1178次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1139次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 981次使用
-
- 用查询属性把页面或请求来源传给当前 SQL 并在服务器端读取
- 2026-11-05 501浏览
-
- MySQL JSON_TABLE 展开数组时如何保留缺失字段
- 2026-09-10 501浏览
-
- MySQL 分区表怎么处理跨分区唯一键:分区列约束与建表取舍
- 2026-08-30 501浏览
-
- MySQL权限管理设置全攻略
- 2026-03-29 501浏览
-
- MySQL分片实现方法及常见方案解析
- 2025-06-24 501浏览


