
Go parser.ParseDir 怎样按包名分组源码文件
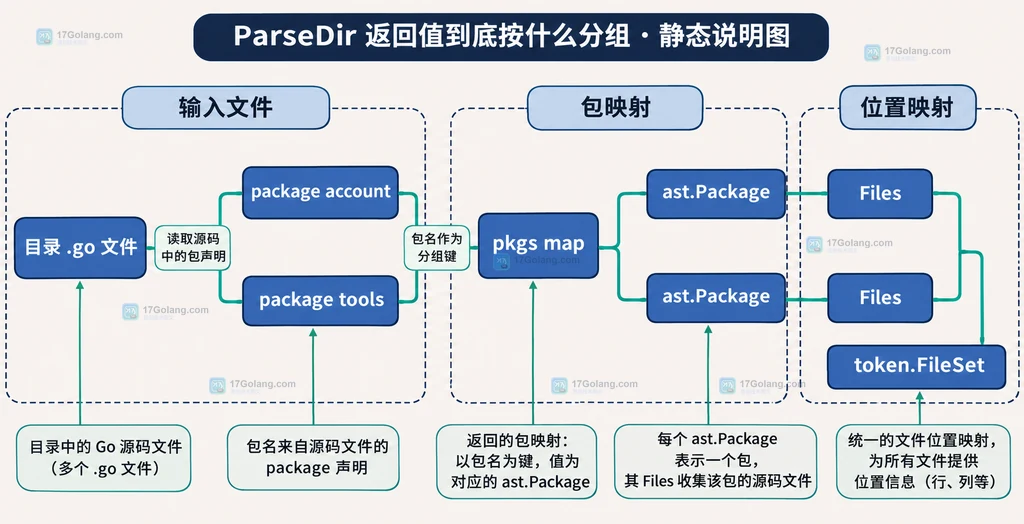
想用 Go 一次读取一个目录里的源码文件,并按包名继续分析时,parser.ParseDir 返回的不是“目录对应一个 AST”,而是一个 map[string]*ast.Package。键来自每个文件的 package 声明,同一包名下的文件会被放进同一个 ast.Package。
官方资料:https://pkg.go.dev/go/parser#ParseDir
最小正确用法是准备非空的token.FileSet,调用ParseDir,遍历返回的包映射和Files;不要把目录名、文件名或 build tags 当成分组依据。
ParseDir 返回值到底按什么分组
函数会读取指定目录,跳过子目录和非 .go 文件,然后逐个解析源码。解析成功后,它使用 AST 中的包名作为键:例如 user.go 和 admin.go 都声明 package account,就会合并到 pkgs["account"] 的 Files 中。
| 返回内容 | 含义 | 不要误解为 |
|---|---|---|
map[string]*ast.Package | 包名到包级 AST 的映射 | 目录名到 AST 的映射 |
ast.Package.Files | 同包文件名到 *ast.File 的映射 | 已经完成类型检查的文件集合 |
token.FileSet | 统一保存源码位置 | 解析器可以省略的临时参数 |
用 FileSet 和过滤器读取目标源码
fset 不能传 nil,因为解析出的节点要把偏移量映射回文件名和行列位置。filter 可以按 fs.FileInfo 排除测试文件、生成文件或不想纳入本轮分析的文件;它只影响是否把文件交给解析器,不会替你判断构建标签。
package main

import (
	"fmt"
	"go/ast"
	"go/parser"
	"go/token"
	"io/fs"
	"log"
	"strings"
)

func main() {
	fset := token.NewFileSet()

	// 只保留非测试 Go 文件,避免把 *_test.go 混入包级 AST。
	filter := func(info fs.FileInfo) bool {
		return !strings.HasSuffix(info.Name(), "_test.go")
	}

	// 解析结果按源码里的 package 名称聚合,而不是按目录名称聚合。
	pkgs, err := parser.ParseDir(fset, "./internal/account", filter, 0)
	if err != nil {
		log.Printf("解析目录时出现错误: %v", err)
	}

	for packageName, pkg := range pkgs {
		fmt.Printf("包 %s 包含 %d 个文件\n", packageName, len(pkg.Files))
		for filename, file := range pkg.Files {
			// file.Name.Name 是 AST 中的包名,可用 FileSet 查询位置。
			pos := fset.Position(file.Package)
			fmt.Printf("  %s: %s:%d\n", filename, pos.Filename, pos.Line)
		}
	}

	_ = ast.File{} // 说明包级 AST 的文件元素类型是 *ast.File。
}
这里的 mode 会原样传给 ParseFile,可以根据需求组合 parser.ParseComments、parser.ImportsOnly 或其他解析模式。若只做导入统计,使用 ImportsOnly 可以减少不需要的 AST 内容,但返回的分组规则不变。
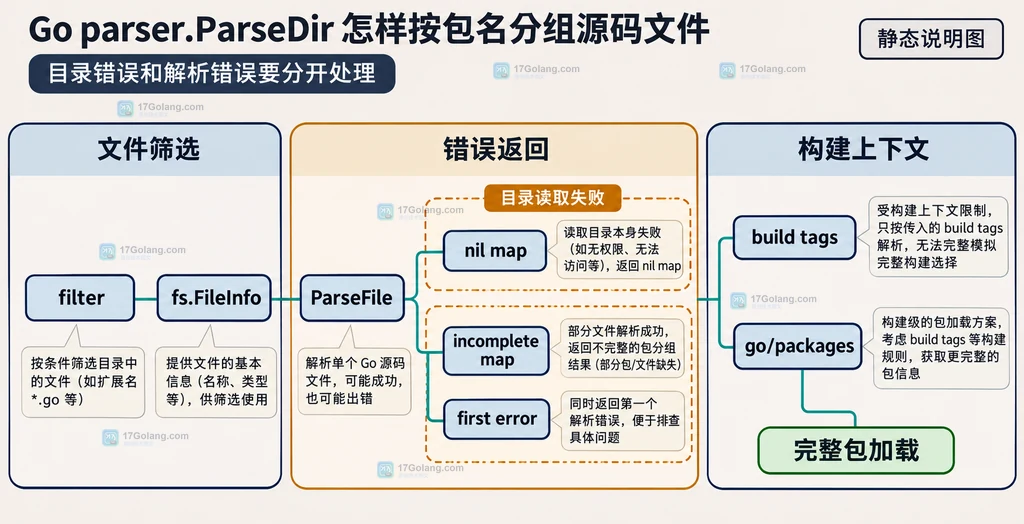
目录错误和解析错误要分开处理
目录本身无法读取时,返回的是 nil map 和对应错误;如果某个 Go 文件解析失败,函数可能返回一个非 nil 但不完整的 map,同时返回第一次遇到的错误。因此不能用“有错误就一定没有结果”来写统一分支。
func readPackages(path string) (map[string]*ast.Package, error) {
	fset := token.NewFileSet()

	// 让调用方拿到部分成功结果,同时保留首个错误供日志和决策使用。
	pkgs, err := parser.ParseDir(fset, path, nil, parser.ParseComments)
	if err != nil && pkgs == nil {
		// 目录读取失败时没有可继续分析的包。
		return nil, fmt.Errorf("读取源码目录 %q: %w", path, err)
	}
	if err != nil {
		// 解析失败可能只影响一个文件,先保留其他完整包供诊断。
		return pkgs, fmt.Errorf("源码存在解析错误: %w", err)
	}
	return pkgs, nil
}
生产代码可以把“继续分析部分结果”作为明确策略:静态索引器通常会记录错误后继续展示已解析的包;需要生成完整产物的任务则应把非空结果也视为失败,避免把残缺 AST 当作完整输入。
为什么 ParseDir 不适合替代构建上下文加载
官方文档明确提示,ParseDir 不考虑 build tags。也就是说,一个目录里的文件可能在不同 GOOS、GOARCH 或自定义标签下属于不同构建集合,但 ParseDir 仍按目录中可见的 .go 文件直接解析并按包名聚合。
如果任务只是做轻量 AST 扫描、导入统计或教学示例,ParseDir 仍然直观;如果需要精确表示“当前构建会包含哪些文件”、解析模块依赖,或进一步做类型检查,应考虑官方文档推荐的 golang.org/x/tools/go/packages。选择工具时要把“解析语法树”和“加载真实 Go 包”当成两个不同问题。
常见问题
为什么 map 里可能有多个包?因为同一目录可以出现多个 package 声明,ParseDir 会按声明名分别建立 ast.Package;是否符合项目构建规则,需要由更完整的加载逻辑判断。
filter 能过滤 build tags 吗?不能。它接收的是文件信息,只能基于文件名、大小、时间等元数据决定是否解析;它不会计算构建约束。
解析错误时应该立即丢弃 pkgs 吗?不一定。返回 map 非空时可以继续做诊断,但必须把结果标记为不完整;需要完整分析时应中止后续产物生成。
总结:ParseDir 的核心是“目录文件 → package 声明 → map[string]*ast.Package”。准备好 FileSet、正确理解过滤器和部分结果,再根据是否需要 build tags 选择下一层工具,就能避免把包名分组误当成完整构建分析。
 pkggo.devAPI读取包版本信息
- 上一篇
- pkggo.devAPI读取包版本信息
- 下一篇
- GreenTea垃圾回收器观察堆行为
-
- Golang · Go教程 | 27分钟前 |
- gofix批量更新现代写法
- 224浏览 收藏
-
- Golang · Go教程 | 35分钟前 | go · uuid · Go Parse UUID github.com/google/uuid NewRandom
- uuid生成并解析标准标识
- 253浏览 收藏
-
- Golang · Go教程 | 36分钟前 |
- errorsAsType按泛型类型取错误
- 332浏览 收藏
-
- Golang · Go教程 | 39分钟前 | Go 并发测试 time.Sleep synctest 虚拟时间
- synctest为并发测试推进虚拟时间
- 439浏览 收藏
-
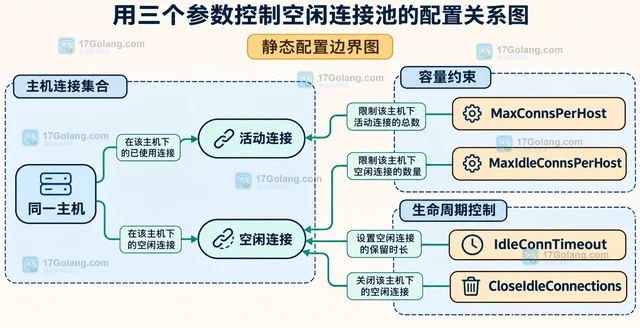
- Golang · Go教程 | 40分钟前 | 标准库 · 连接池 · Go教程 · 性能排查 · HTTP客户端 · Go net/http 连接复用 keep-alive http.Transport http.Client HTTP/1
- http客户端复用HTTP1连接
- 384浏览 收藏
-
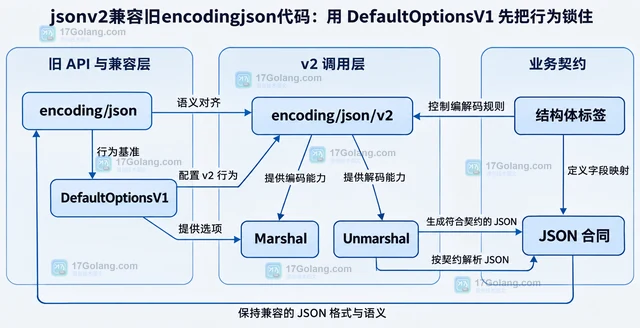
- Golang · Go教程 | 43分钟前 | JSON · Go教程 · 版本迁移 · 兼容性 · Go encoding/json encoding/json/v2 JSON迁移 DefaultOptionsV1
- jsonv2兼容旧encodingjson代码
- 162浏览 收藏
-
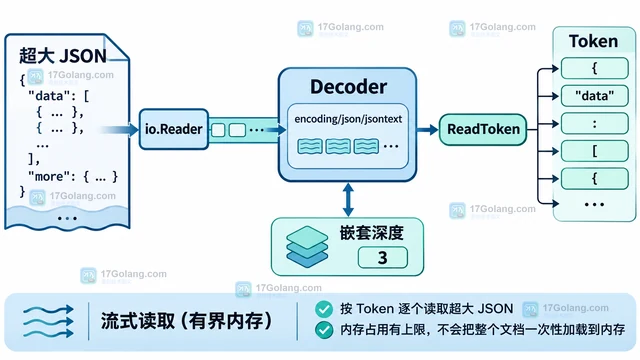
- Golang · Go教程 | 46分钟前 |
- jsontext按Token读取超大JSON
- 246浏览 收藏
-
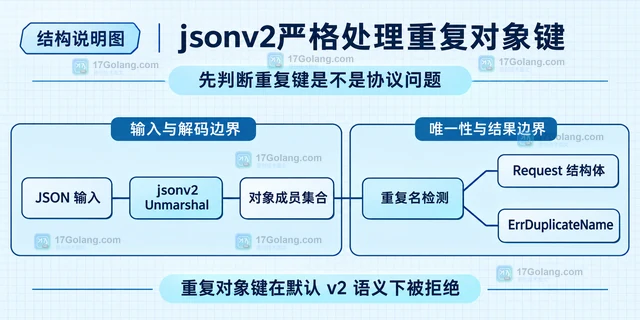
- Golang · Go教程 | 49分钟前 |
- jsonv2严格处理重复对象键
- 224浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1032次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1032次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1175次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1135次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 977次使用
-
- Go Excelize API源码解析GetSheetFormatPr使用示例
- 2022-12-26 449浏览
-
- Go error wrapping 实战:别让错误日志只剩一句 failed
- 2026-06-01 151浏览
-
- Go pprof 排查慢接口:别只会看火焰图,先把问题问对
- 2026-06-01 101浏览
-
- Go Flight Recorder 实战:线上偶发卡顿,别再只靠日志碰运气
- 2026-06-01 323浏览
-
- Go testing/synctest 实战:别再用 time.Sleep 赌并发测试会过
- 2026-06-01 428浏览


