
Linux /proc/loadavg 的 running 与 total 怎么读
看到 /proc/loadavg 中的 3/828,很多人会把 3 理解成“正在运行的进程”,把 828 理解成“进程数”。更准确的读法是:斜杠前是当前可运行的内核调度实体数量,斜杠后是系统当前存在的调度实体总数;它们通常包含线程,所以不能直接替代 CPU 使用率或 ps 的进程计数。
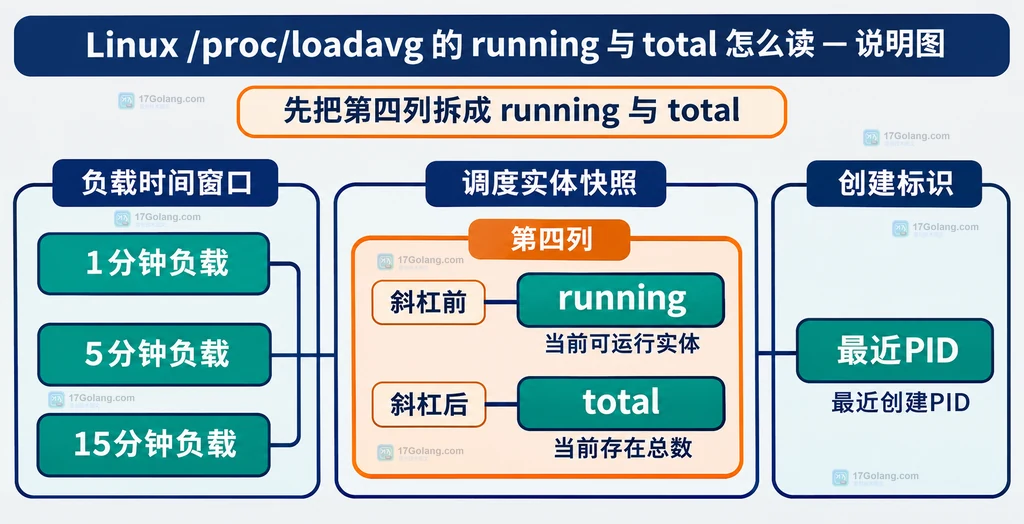
/proc/loadavg五列依次是 1、5、15 分钟负载、running/total、最近创建的 PID。- running 表示正在运行或等待运行的调度实体,total 表示当前存在的调度实体,不是“过去累计创建数”。
- 判断拥堵要同时看 CPU 逻辑核数、D 状态任务和时间窗口,不能只盯着第四列。
官方资料:https://docs.kernel.org/filesystems/proc.html
先把第四列拆成 running 与 total
可以先把内容按空格切成五列。下面的命令只做文本读取,不把示例输出当成固定值:
# 读取内核导出的负载行,并按空格拆出字段
read -r one five fifteen running_total last_pid | 位置 | 含义 | 不要这样理解 |
|---|---|---|
| 1~3 | 1、5、15 分钟负载平均值 | 不是百分比 |
| 4 的斜杠前 | 当前可运行的进程或线程数 | 不等于此刻正在执行的数量 |
| 4 的斜杠后 | 当前存在的内核调度实体总数 | 不是历史累计进程数 |
| 5 | 最近创建的 PID | 不是当前最大 PID 的可靠替代 |
例如 0.61 0.61 0.55 3/828 22084 中,3 是当前可运行实体数,828 是当前存在的调度实体数,22084 是最近创建的 PID。这里的“实体”很重要:Linux 的调度对象可以是进程,也可以是线程。一个多线程服务可能只对应一个用户态 PID,却贡献多个调度实体。
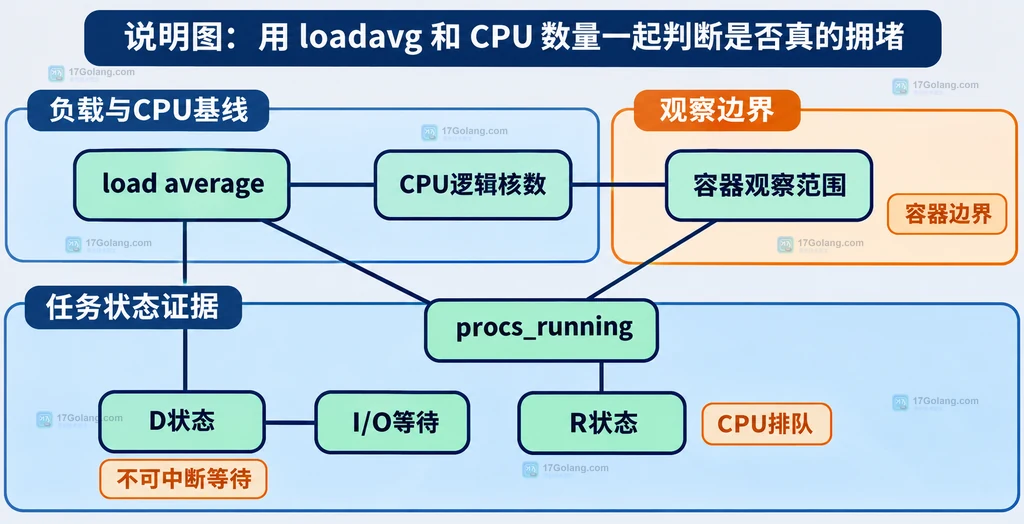
用 loadavg 和 CPU 数量一起判断是否真的拥堵
running 只能回答“当前有多少调度实体处于可运行状态”,不能回答“它们是否都在抢 CPU”。多核机器上,running 为 3 可能完全没有排队;单核机器上,running 长时间高于 1 才更值得关注。负载前三列还会把等待磁盘 I/O 的任务纳入统计,因此 load average 升高不一定是 CPU 算力不足。
# 查看逻辑 CPU 数量,作为负载的参照基线
cpu_count=$(getconf _NPROCESSORS_ONLN)

# 查看可运行线程与不可中断睡眠线程,辅助区分 CPU 和 I/O 方向
awk '/^procs_running |^procs_blocked / { print }' /proc/stat

# 查看进程状态,重点关注 R(运行)和 D(不可中断睡眠)
ps -eo state=,pid=,comm= --sort=state | awk '$1 ~ /^[RD]$/ { print }'
排查时可以采用一个简单的组合判断:
- 1 分钟值持续高于 5 分钟和 15 分钟,且 running 接近或超过逻辑 CPU 数量:优先检查 CPU 饱和、锁竞争和突发任务。
- load average 偏高但
procs_running不高,同时 D 状态任务增多:优先检查磁盘、网络文件系统或块设备延迟。 - total 很大但负载不高:它只说明系统存在较多调度实体,不能单独证明系统变慢,应再看线程数量、内存和进程树。
还要留意容器和宿主机边界。容器内看到的 /proc、CPU 配额和 PID 命名空间可能改变观察范围;在容器里读取到的 running/total 不应未经核对就与宿主机的 uptime 或监控面板直接比较。
读取时最容易踩的三个边界
第一,第四列不是百分比,不能写成“3% 的 CPU”。第二,total 不是从开机到现在创建过的进程总量,进程退出后它会减少。第三,running 不是瞬时 CPU 执行槽位的计数,它是调度实体状态的快照;采样时刻不同,数字就可能变化。
生产排查可以把以下内容一起记录:连续几次的 /proc/loadavg、逻辑 CPU 数、/proc/stat 中的 procs_running、R/D 状态任务,以及容器的 CPU/PID 限制。这样才能把“负载变高”进一步收敛到 CPU 排队、I/O 等待或线程数量增长。
常见问题
running 是进程数还是线程数?
它是当前可运行的内核调度实体数,实践中应按进程和线程共同理解,不能只按 PID 数量解释。
total 越大,服务器就一定越慢吗?
不一定。total 只反映当前存在的调度实体数量,是否变慢还要结合 CPU、I/O、内存和任务状态。
为什么 load average 高但 CPU 使用率不高?
任务可能在等待磁盘或其他不可中断资源。此时重点看 D 状态任务和对应 I/O 延迟,而不是只增加 CPU。
记住一个速查句:先按字段位置读懂 running/total,再用 CPU 核数和 R/D 状态解释负载,最后用连续采样确认趋势。
 Python unittest.subTest 怎样保留多个失败
- 上一篇
- Python unittest.subTest 怎样保留多个失败
- 下一篇
- Linux statx 怎样读取文件创建时间
-
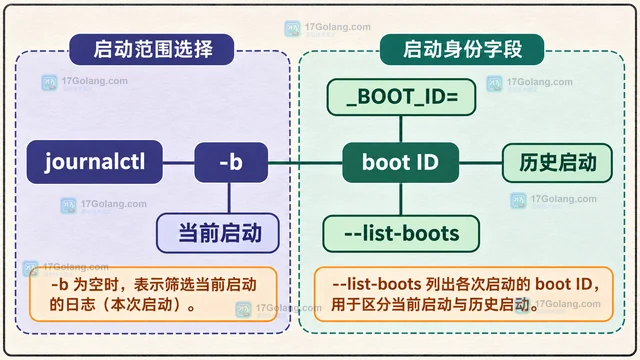
- 文章 · linux | 6分钟前 | 命令行工具 · linux运维 · 故障排查 · Linux systemd journalctl 日志排查 启动日志 Boot ID systemd-journald
- journalctl -b 怎样筛选本次启动日志
- 311浏览 收藏
-
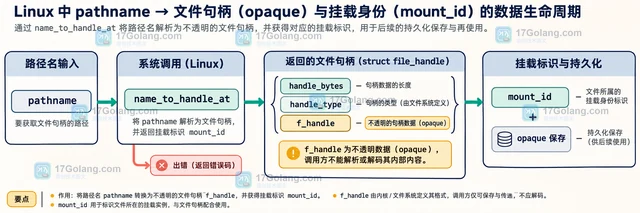
- 文章 · linux | 8分钟前 | linux运维 · 文件系统 · Linux 文件句柄 name_to_handle_at open_by_handle_at file_handle mount_id
- Linux name_to_handle_at 怎样保存可复用的文件句柄
- 340浏览 收藏
-
- 文章 · linux | 11分钟前 |
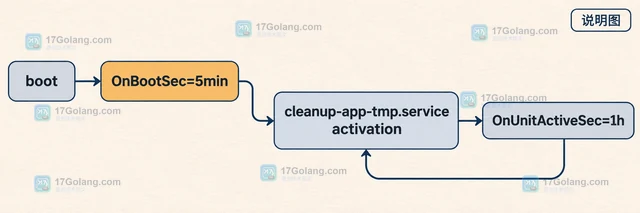
- systemd.timer OnBootSec 与 OnUnitActiveSec 的周期触发配置方法
- 351浏览 收藏
-
- 文章 · linux | 11分钟前 |
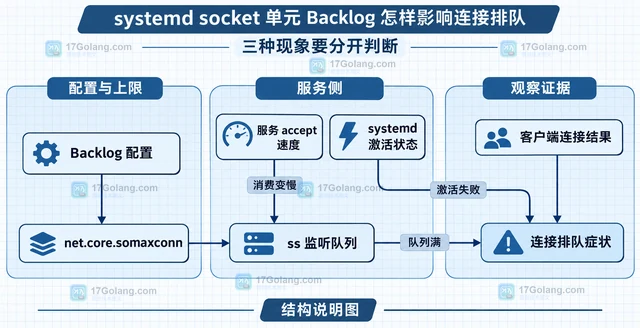
- systemd socket 单元 Backlog 怎样影响连接排队
- 490浏览 收藏
-
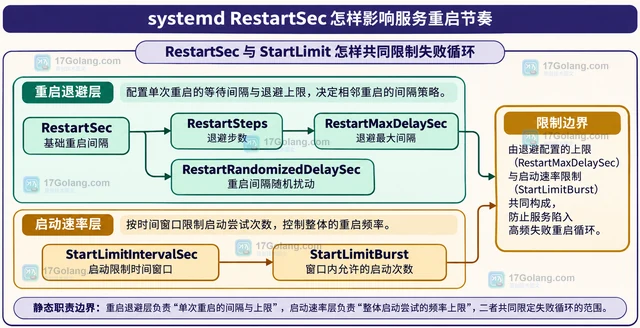
- 文章 · linux | 15分钟前 | linux运维 · 故障排查 · 服务治理 · Linux systemd 故障恢复 服务重启 RestartSec StartLimit Restart RestartSteps
- systemd RestartSec 怎样影响服务重启节奏
- 312浏览 收藏
-
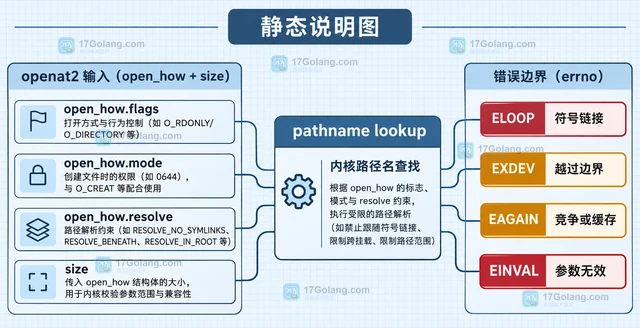
- 文章 · linux | 17分钟前 |
- Linux openat2 resolve flags 怎样限制路径解析范围
- 132浏览 收藏
-
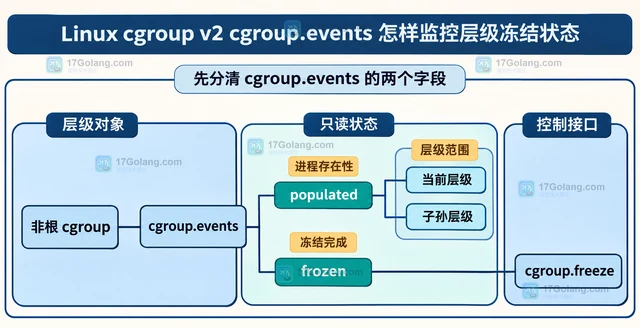
- 文章 · linux | 19分钟前 | linux运维 · Linux cgroup v2 frozen cgroup.freeze cgroup.events populated 进程层级 运维监控
- Linux cgroup v2 cgroup.events 怎样监控层级冻结状态
- 332浏览 收藏
-
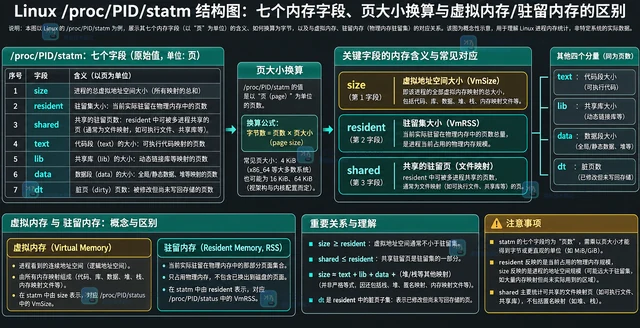
- 文章 · linux | 22分钟前 |
- Linux /proc/PID/statm 怎样区分虚拟内存与常驻内存
- 481浏览 收藏
-
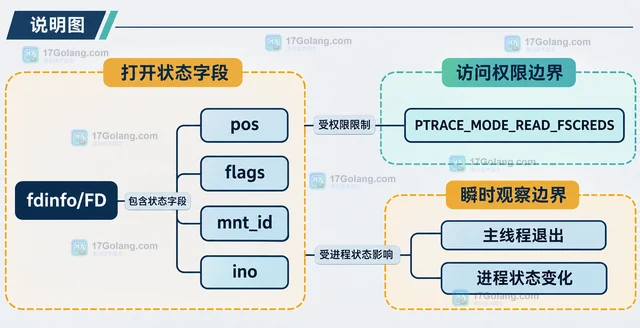
- 文章 · linux | 26分钟前 |
- Linux /proc/PID/fd 怎样判断进程打开的文件
- 313浏览 收藏
-
- 文章 · linux | 27分钟前 | Linux statx STATX_BTIME 文件创建时间
- Linux statx 怎样读取文件创建时间
- 165浏览 收藏
-
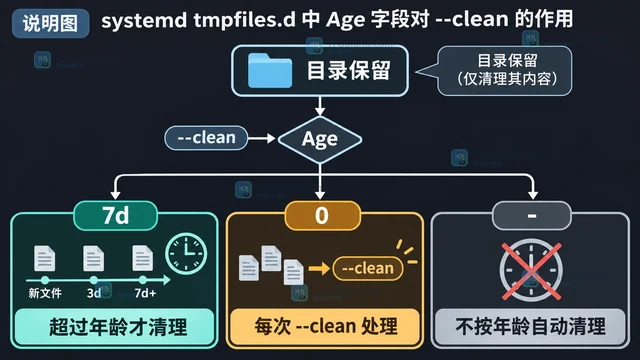
- 文章 · linux | 18小时前 | linux运维 · Linux 目录清理 tmpfiles.d systemd-tmpfiles 文件系统年龄
- tmpfiles.d d 与 D 类型清理规则有何区别
- 263浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1029次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1030次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1173次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1134次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 974次使用
-
- Go Flight Recorder 实战:线上偶发卡顿,别再只靠日志碰运气
- 2026-06-01 323浏览
-
- Go runtime/trace 任务区域如何标记异步链路:Log、Region 与查看顺序
- 2026-08-27 244浏览
-
- Go 1.25 runtime/pprof Label 控制采样范围:Do、ForLabels 与 goroutine 归因
- 2026-08-27 447浏览
-
- Go runtime/metrics.Float64Histogram 怎么计算 P99:Buckets 与 Counts 的边界
- 2026-08-28 314浏览
-
- Go runtime/trace 如何定位 goroutine 阻塞:trace.NewTask、Logf 与时间线筛选
- 2026-08-28 474浏览


